
Оценка поисковых агентов обычно строится на аккуратно прописанных сценариях: заранее известные реплики, предсказуемые запросы, один «усреднённый» пользователь. Такой подход удобно измерять, но он плохо отражает реальность, где за одним и тем же интерфейсом сидят люди с совершенно разным темпом, стилем и терпением. Работа AgentWorld: Personality-Aware Reliability Evaluation for Agentic Information Retrieval (arXiv:2608.24076, принята на воркшоп Agent4IR @ KDD 2026) предлагает смотреть на надёжность агента иначе — через характер собеседника и через попытки этот характер сломать.
От скриптов к личностям: в чём пробел
Классический бенчмарк для агентного поиска отвечает на вопрос «решил ли агент задачу». Но он молчит о том, что происходит между шагами, и почти ничего не говорит о разбросе результатов. Если все пользователи в тесте ведут себя одинаково, атаки на систему не моделируются вовсе, то и выводы получаются стерильными: по такому замеру невозможно понять, где именно агент начинает спотыкаться.
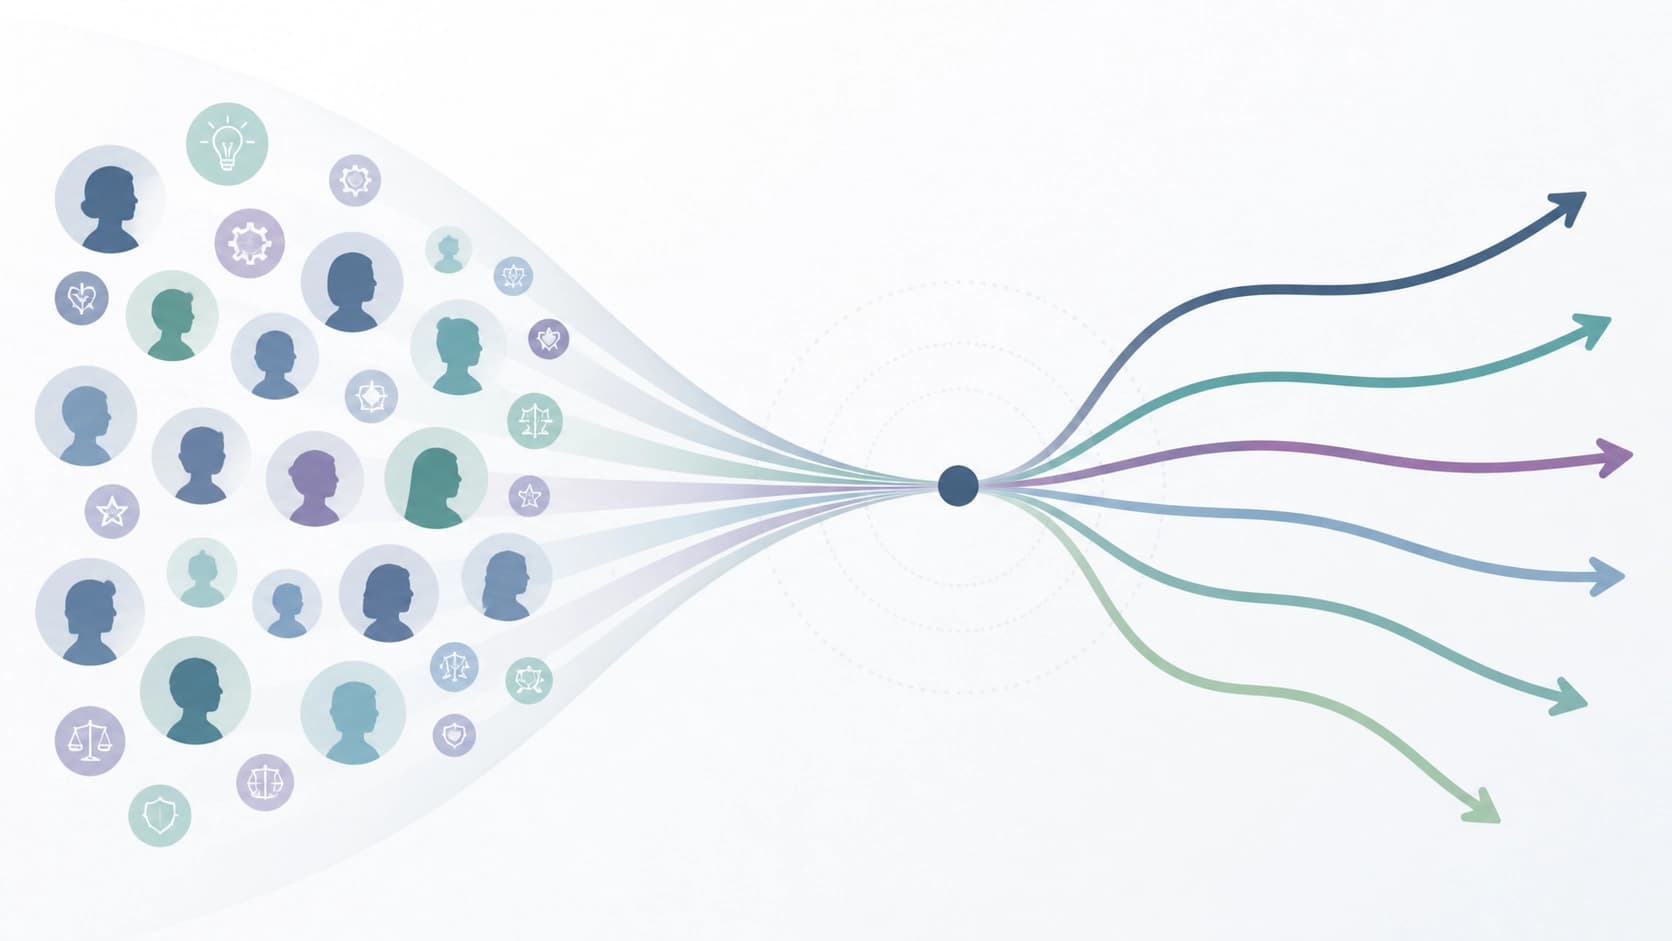
Именно эту дыру авторы — Gunja Agarwal, Arup Kumar Das, Arun Menon, Jitesh Chandra Mishra и Vignesh Divakaran — и пытаются закрыть. Их ключевая мысль проста: разброс поведения пользователей следует не сглаживать, а превращать в отдельный измерительный прибор.
Что представляет собой AgentWorld
AgentWorld — это симулятор, а не отдельный поисковый движок. Он не решает задачи вместо агента, а создаёт среду, в которой агента можно гонять по разным сценариям и разным типам собеседников, фиксируя не только финальный ответ, но и траекторию его получения.
Четыре опорных блока
- Модели пользователей по Big Five. Персоны задаются по пятифакторной модели (её ещё называют OCEAN), причём работают они не в вакууме: у каждого пользователя есть собственное состояние и собственный набор доступных инструментов, а эти состояния меняются по ходу диалога.
- Метрика согласованности pass^k. Это не просто «сколько раз получилось». Рядом идёт структурная классификация сбоев, частичное начисление баллов за неполный, но осмысленный прогресс и двойная проверка передачи управления — то есть отдельно верифицируется, корректно ли агент передал ход человеку или другой системе.
- Экспорт данных для дообучения. Симулятор умеет выгружать накопленные прогоны, отсекая слабые по оценке, сразу в шести форматах, пригодных для файн-тюнинга.
- Состязательный Risk Analyser. Этот модуль снимает слепки с «хребтов» промежуточных состояний, которые агент обязан пройти, а затем ветвит прогоны методом Монте-Карло по четырём типам возмущений, привязанных к конкретной задаче. Итоговый риск считается через отношение ΔP / ΔT, слияние свидетельств по Демпстеру—Шейферу и атрибуцию категорий атак по Шепли.
Обратите внимание на логику: три первых блока — это про измерение и обучение, четвёртый — про предсказание поломок. Фреймворк изначально строится как инструмент не только диагностики, но и стресс-тестирования.
Три прогона: от аналитики до состязательной атаки
Экспериментальная часть состоит из трёх частей с разной степенью «нагрузки».
- Разговорный аналитический агент прогонялся против десяти персон OCEAN. Для разметки качества собрано 240 судейских оценок.
- Агент клиентской поддержки проверялся на пяти задачах, каждая в четырёх вариантах персоны.
- Состязательный стресс-тест тех же пяти задач: сюда добавили возмущения, чтобы посмотреть, как быстро разваливаются траектории.
Третий прогон оказался самым показательным. Уже в отсутствие возмущений минимальная устойчивость траектории составила V_min = 0.375 — то есть даже «чистые» условия не дают запаса прочности. А когда атаки включили, выяснилось, что опаснее всего удары не по содержанию запроса, а по инструментам и инфраструктуре: атрибуция по Шепли отдаёт системному уровню около 46%, уровню действий — примерно 38%.
Это важный сдвиг акцента. Обсуждение безопасности агентов часто сводится к промпт-инъекциям в текст, тогда как цифры говорят, что основной риск живёт в слое, который отвечает за вызовы инструментов и их состояние.
Характер как источник расхождений
Самое интересное в статье — не абсолютные оценки, а разброс между персонами. На одной и той же задаче проходимость различалась радикально: 50% против 100%. Это не шум измерения, а сигнал о том, что агент по-разному справляется с разными стилями общения.
Отдельно перечислены режимы отказа, которые унифицированное тестирование попросту не показывает:
- кросс-доменные утечки — когда контекст одной задачи протекает в другую;
- контекстный дрейф — постепенное смещение темы и целей по ходу длинного диалога;
- разрыв в качестве между персонами в 0.27 пункта.
Авторы подчёркивают, что Risk Analyser умеет измерять хрупкость на уровне траектории — там, где одиночная метрика pass^k бессильна, потому что она фиксирует только факт успеха или неудачи и не различает «сорвался на первом шаге» и «дошёл почти до конца, но не удержал состояние».
Чем это полезно на практике
Если воспринимать выводы как рецепт, он выглядит так: тестируйте агента не на одном «среднем» пользователе, а на наборе характеров, и смотрите на разброс между ними, а не на среднее. Средний балл может быть вполне приличным, пока половина персон стабильно проваливает сценарий.
Второй практический слой — данные. Раз симулятор умеет помечать успешные и неуспешные прогоны и выгружать их в готовых форматах, личности становятся не только испытанием, но и источником обучающего материала. Слабое место тут очевидно: качество такого датасета целиком зависит от качества разметки, а судейские оценки — самая дорогая и субъективная часть процесса.
Наконец, третий слой — приоритеты в защите. Раз основная доля риска приходится на системный уровень и действия, а не на формулировки, то и укреплять нужно в первую очередь права доступа, проверку вызовов и корректность передачи управления, а не только фильтры на входном тексте.
Что стоит держать в голове
Стоит помнить о масштабе: речь идёт о трёх наборах экспериментов, десяти персонах в одном из них и пяти задачах в двух других. Цифры вроде 50% против 100% выглядят драматично, но построены на небольшой выборке — это скорее указание направления, чем окончательный приговор. Кроме того, симуляция пользователя по Big Five неизбежно огрубляет реальный характер: живой человек непоследователен, а персона в симуляторе всё-таки следует заданному профилю.
Тем не менее методологическая идея выглядит прочной и переносимой. Надёжность агента — это не одно число, а распределение по типам собеседников и по типам сбоев. Симулятор AgentWorld делает первый серьёзный шаг к тому, чтобы это распределение можно было измерять, а не угадывать.
Версия статьи v1 появилась 25 августа 2026 года, текущая v2 от 26 августа 2026 года (объём 1,710 KB); DOI — 10.48550/arXiv.2608.24076, тематика — cs.AI.


