Награда по результату — и слепая зона внутри неё
В исследованиях GUI-агентов заметно сместился акцент: всё больше работ посвящено моделированию вознаграждения по результату (outcome reward modeling). Логика простая — агент получает балл в зависимости от того, привела ли его траектория к состоянию, которое подразумевала инструкция пользователя. Есть действие, есть экран, есть итог, есть оценка.
Но здесь и спрятан подвох. Если агент получает награду «за результат», кто-то должен сформулировать, что именно считается результатом. В типичной схеме этот шаг либо пропускают, подменяя общей формулировкой, либо оставляют на усмотрение самой модели: она «рассуждает» по ходу проверки, без явно зафиксированных критериев. И то и другое выглядит рабочим ровно до момента, когда нужно оценивать десятки разных задач одним и тем же верификатором.
Три типовые ошибки обобщённых рубрик
Авторы работы arXiv:2608.24174 «Task-Adaptive Rubrics for GUI Reward Modeling» (Tao Xiong и соавторы) описывают, к чему приводит опора на универсальный шаблон или на неявное рассуждение модели. Проблемы предсказуемые:
- Перенос проверок между задачами. Критерий, выведенный когда-то для одного сценария, механически применяется к другому, где он просто не имеет смысла.
- Потеря ограничений. Конкретные требования текущей инструкции — нужные значения, конкретные поля, определённые шаги — остаются незамеченными, потому что общая рубрика их не различает.
- Избыточная строгость. Верификатор начинает требовать того, чего пользователь не просил, и бракует корректно выполненное задание.
Общая причина у всех трёх одна: рубрика живёт отдельно от задачи. Она не выводится из инструкции, а прикладывается к ней снаружи.
Как устроен AdaptRubric
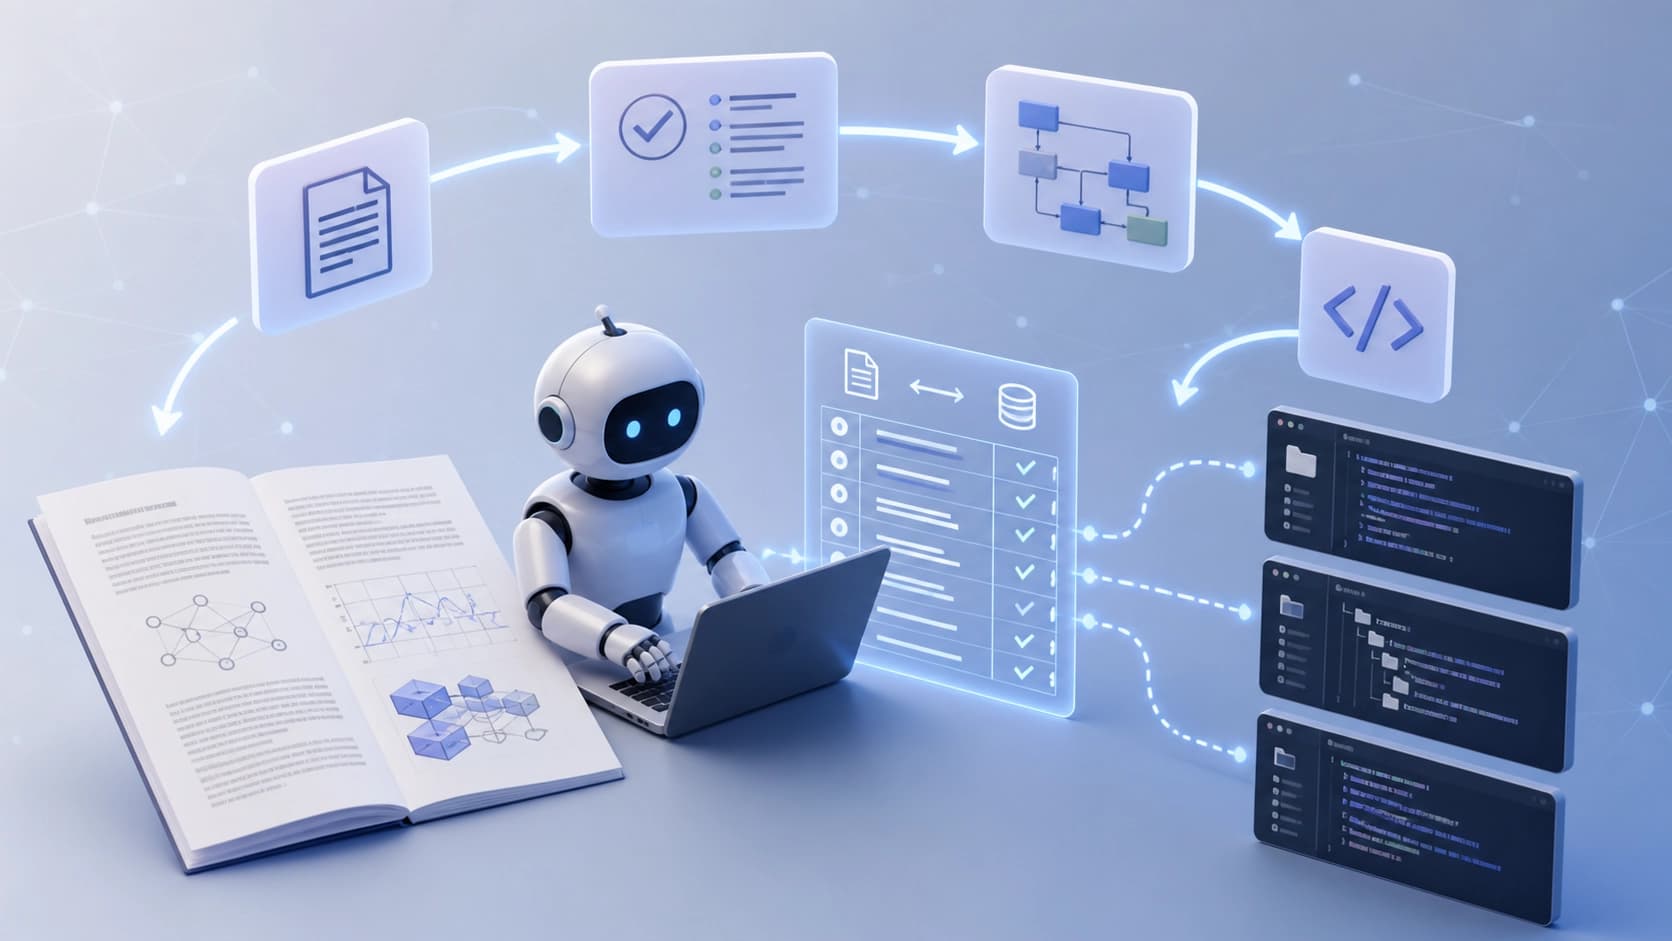
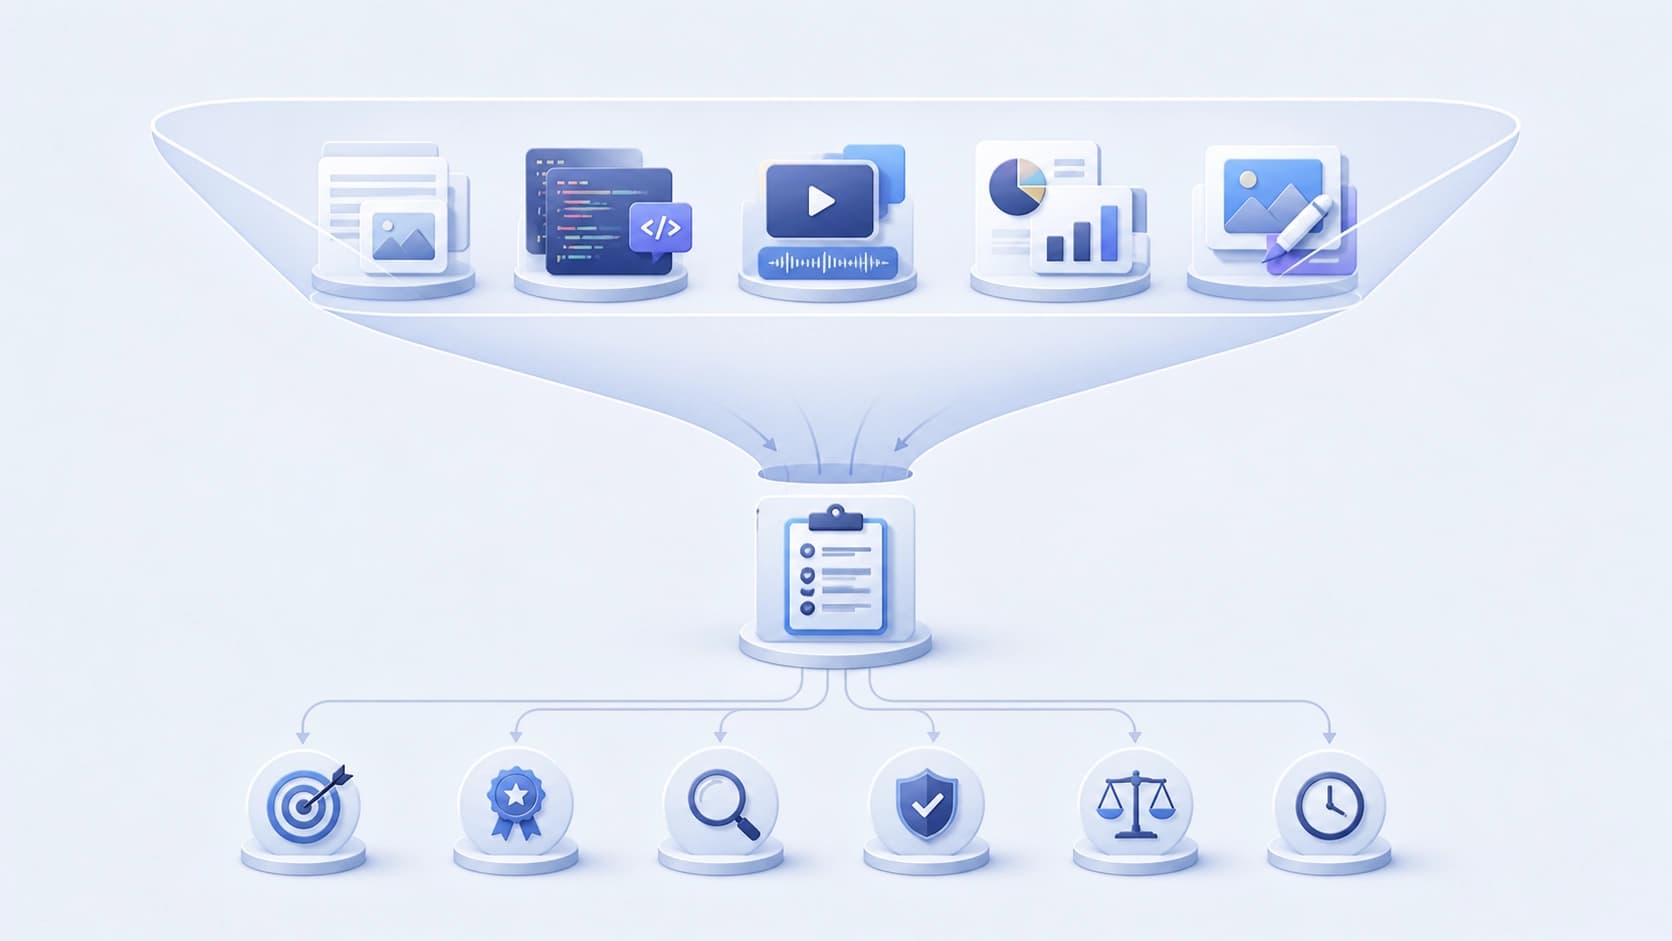
Предлагаемый фреймворк так и называется — рубрики «от грубого к тонкому» (Coarse-to-Fine Rubrics Framework). Его задача — не хранить готовый набор критериев, а строить их под каждую конкретную инструкцию, двигаясь от широкого уровня к узкому. Две стадии решают две разные проблемы, и это ключевая деталь конструкции.
Грубая стадия: сначала понять, что это за класс задач
Первый шаг — маршрутизация. Инструкция относится к определённому семейству GUI-задач, и из этого семейства подтягиваются переиспользуемые критерии. Смысл в том, что у похожих действий есть устойчивые признаки успеха: они уже известны и не нужно изобретать их заново для каждого нового запроса. Грубая рубрика задаёт рамку — рамку, а не окончательный приговор.
Тонкая стадия: вытащить детали конкретного экземпляра
Второй шаг работает уже с отдельной инструкцией. Из неё извлекаются компактные подсказки — конкретные значения, области действия, ограничения, которые в этой задаче принципиальны. Именно здесь рубрика перестаёт быть общей и становится своей для данного случая. Требования, которых пользователь не выставлял, не появляются; требования, которые он выставил, не теряются.
Такое разделение снимает главную претензию к универсальным схемам: обобщение остаётся, но оно больше не подменяет спецификацию.
Результаты: офлайн и в обучении с подкреплением
AdaptRubric проверяли в двух режимах. Первый — офлайн-оценка вознаграждения, то есть насколько хорошо верификатор различает успешные и неуспешные траектории. Второй — онлайн-оптимизация с обучением с подкреплением, где рубрики работают уже как источник сигнала для обучения агента.
Заявленные цифры: при сопоставимом бюджете изображений показатель F1 вырос на 3,6 пункта относительно среднего значения базовых решений, а прирост успешности выполнения задач составил 4,23 пункта. Авторы подчёркивают, что преимущество стабильно воспроизводится, а не держится на отдельных удачных прогонах.
Что это меняет по существу
Оценка агента перестаёт быть вопросом «хороший верификатор или плохой». Она становится вопросом процедуры: кто и на каком основании сформулировал критерии для этой конкретной задачи. Пока критерии выводились неявно, ошибку оценки было почти невозможно отделить от ошибки самого агента — обе выглядели одинаково в итоговом отчёте.
Подход с адаптивными рубриками делает промежуточный слой явным, а значит его можно проверять, обсуждать и править отдельно от модели. Для разработки это ещё и практическое удобство: если рубрика строится по инструкции, то изменение формулировки задачи автоматически меняет и способ её оценки, без переписывания верификатора.
Остаются и открытые вопросы — насколько хорошо маршрутизация справляется с задачами на стыке семейств, как ведёт себя тонкая стадия на намеренно двусмысленных инструкциях. Но сама постановка уже выглядит полезнее, чем очередная попытка сделать универсальный шаблон чуть более аккуратным.