
La sagesse des foules se heurte à l'uniformité
Quand il faut prédire quelque chose sur l'avenir — le comportement d'un marché, l'issue d'un événement, le destin d'une technologie —, une idée simple vient à l'esprit : plus on interroge de modèles, plus la réponse sera fiable. La logique semble imparable : les différents systèmes se trompent de manières différentes, donc la moyenne lissera les erreurs aléatoires.
Mais ce schéma a un piège. Si tous les participants de la « foule » raisonnent de façon similaire, leurs voix ne sont pas des témoignages indépendants, mais une seule et même opinion, multipliée par copie. Dix réponses presque identiques n'apportent pas plus d'information qu'une seule ; elles créent seulement un sentiment de confiance et augmentent la facture d'inférence.
C'est précisément autour de ce problème que s'articule le travail « Diverse by Reasoning: Harnessing the Wisdom of LLM Crowds for Future Prediction », préparé par Niropam Chetlapalli, Yiming Liao, Min-Chun Chen et Keke Chen. Le preprint arXiv:2608.24001 est paru le 25 août 2026, une version révisée est sortie dès le lendemain, et l'article lui-même a été soumis à IEEE BigData 2026.
« Plus de modèles » ne suffit pas à résoudre le problème
L'observation clé des auteurs : différents grands modèles de langage peuvent se comporter de manière excessivement similaire. Ils sont entraînés sur des données comparables, tendent vers des formulations proches et des schémas de raisonnement types. Au final, l'élargissement mécanique de la liste des participants ne produit pas la diversité pour laquelle tout avait été entrepris.
Il importe ici de distinguer deux notions. La quantité — c'est le nombre de modèles que l'on interroge. La diversité — c'est à quel point ils parviennent à des conclusions de manières différentes. La seconde ne découle pas automatiquement de la première : on peut réunir vingt participants et obtenir vingt variations d'une même pensée.
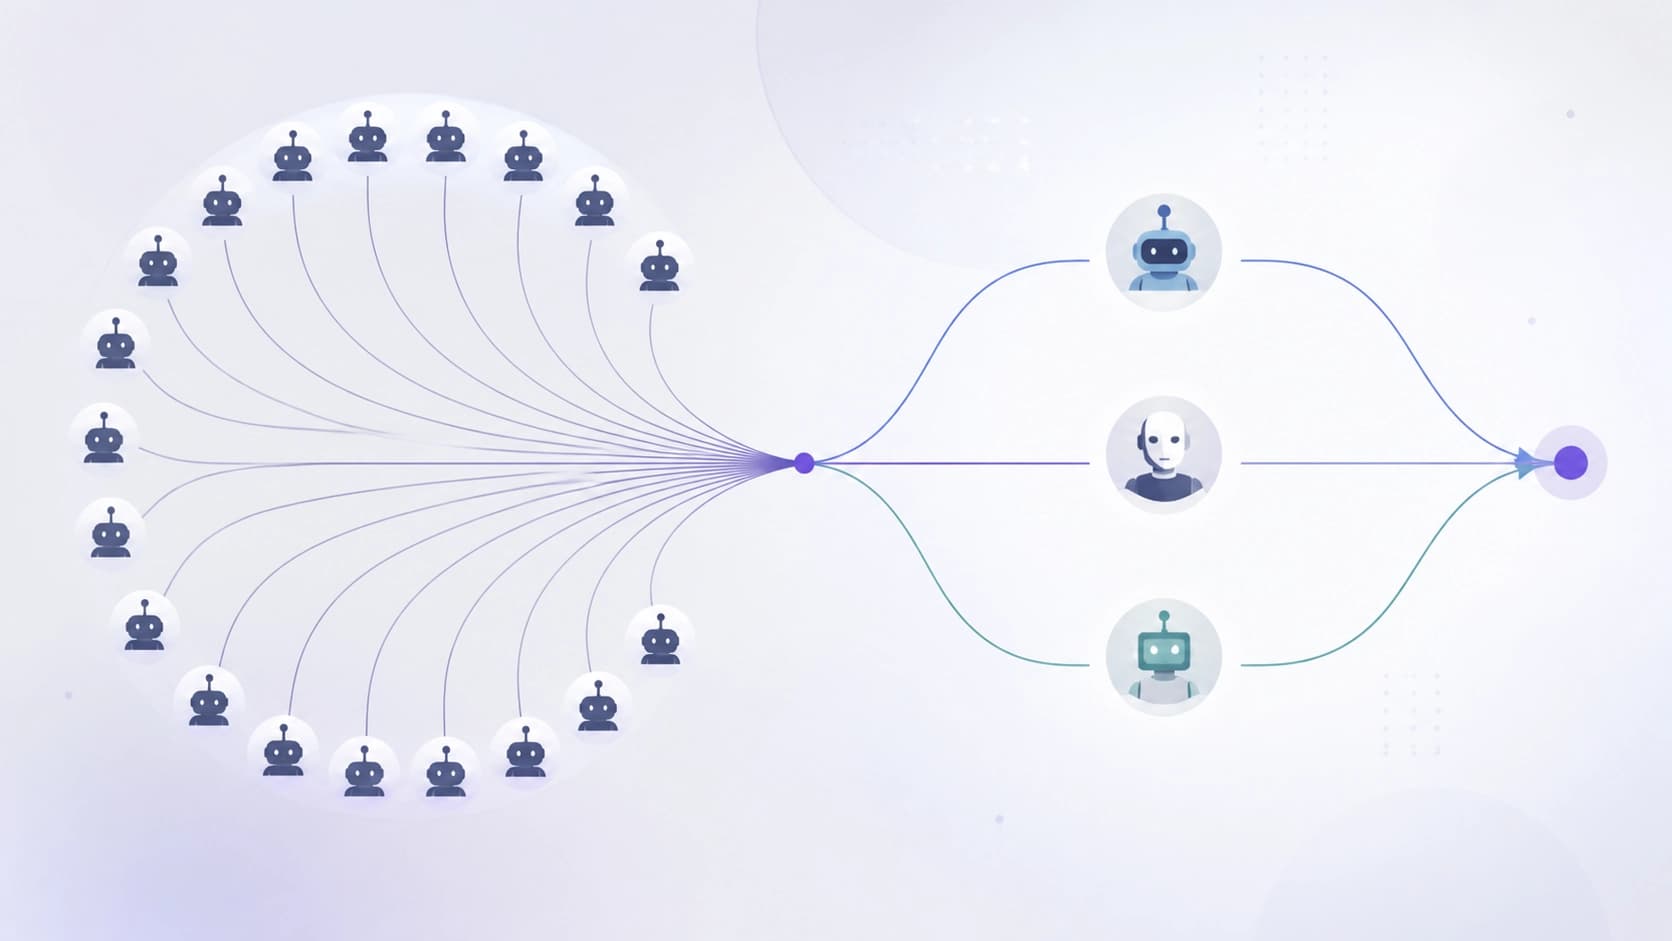
Méthode : les modèles sont sélectionnés selon leur style de raisonnement, pas selon leurs réponses
À quoi ressemble la sélection comportementale
Les auteurs proposent un cadre qu'ils qualifient d'orienté comportement. L'essentiel n'est pas de comparer les modèles selon la justesse de leurs réponses finales, mais de comprendre comment ils pensent.
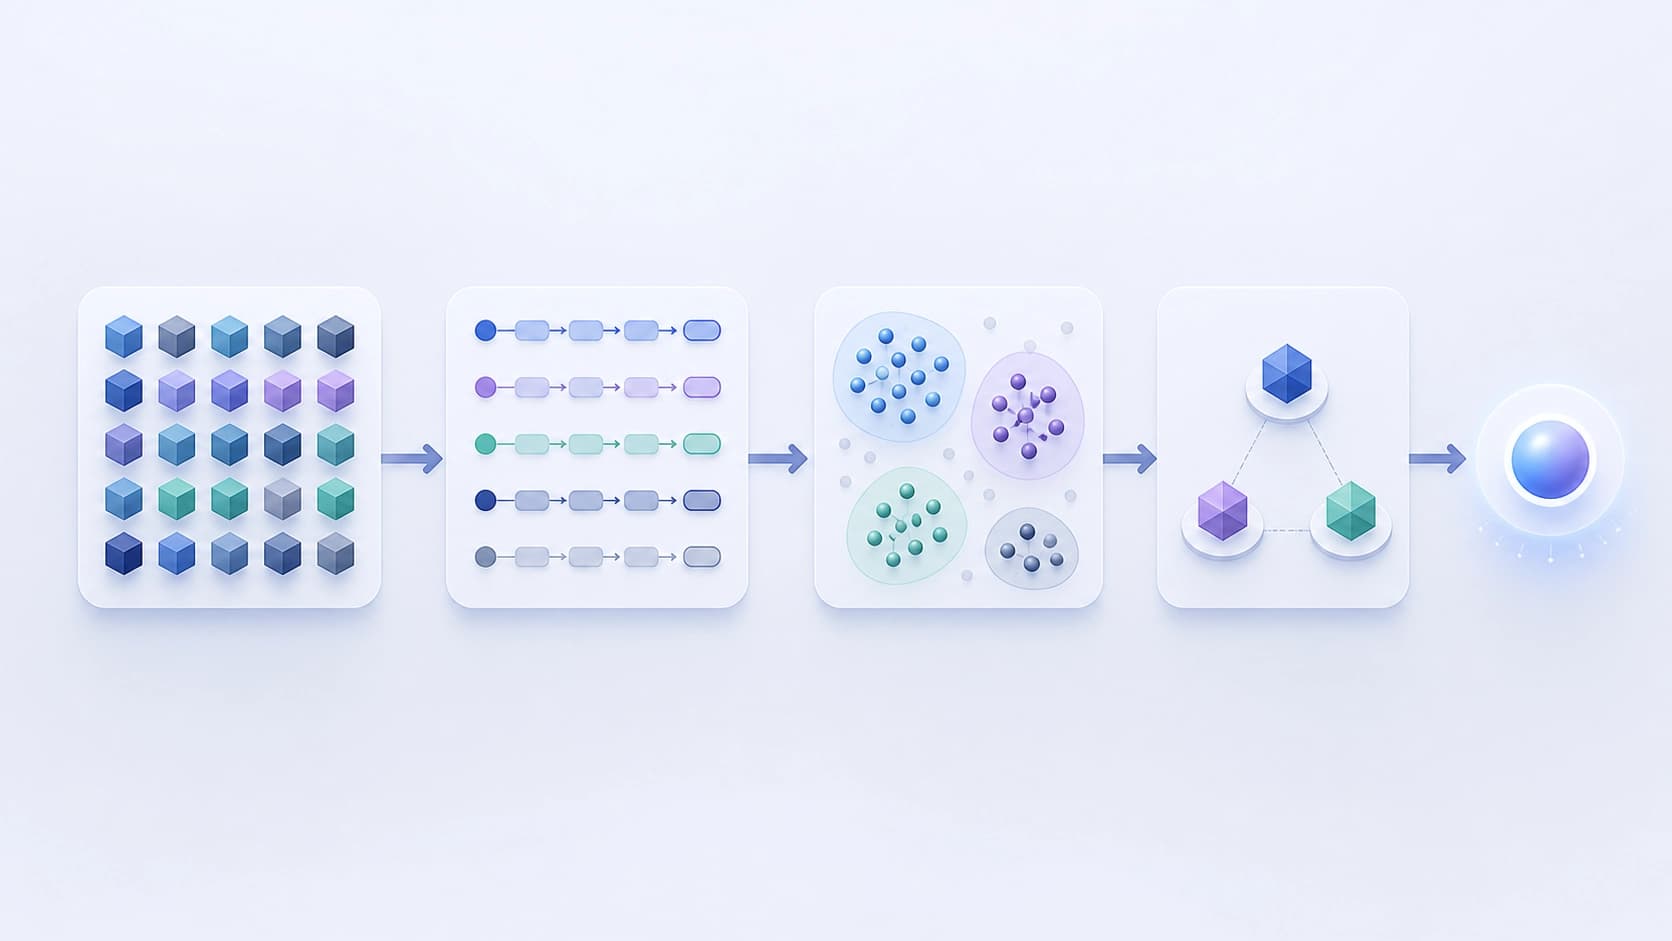
Le schéma est le suivant :
- Chaque modèle est passé sur un ensemble de tâches indépendantes, sans lien avec la prédiction de l'avenir. On recueille moins les réponses que les chaînes de raisonnement — les fameuses reasoning traces.
- À partir de ces traces, on construit un profil comportemental : quelles étapes le modèle effectue, comment il décompose la tâche, où il se trompe, à quels arguments il recourt.
- Les modèles sont regroupés en clusters par similarité de comportement. Pour cela, on utilise l'algorithme K-means++.
- De chaque cluster, on prend un représentant — un médoïde, c'est-à-dire le modèle le plus typique de son groupe.
- C'est cette « foule » compacte de médoïdes qui produit la prédiction collective.
L'idée, à y réfléchir, n'est pas nouvelle — c'est ce que l'on fait en statistique lorsqu'on ne garde qu'un représentant parmi des variables corrélées, pour ne pas dupliquer la même information. La nouveauté ici, c'est que le « trait » devient la manière de raisonner d'un modèle de langage, et non une caractéristique numérique.
Sur quoi on a testé
L'expérience repose sur 25 modèles. Sept benchmarks de développement ont servi à décrire et à distinguer les modèles par leur comportement, et deux benchmarks distincts — portant sur la prédiction de l'avenir — à évaluer la qualité des « foules » obtenues. Cette séparation est fondamentale : les tâches sur lesquelles le profil est construit ne coïncident pas avec celles sur lesquelles le résultat est mesuré. Sinon, on aurait un apprentissage avec triche, et les chiffres ne voudraient presque rien dire.
Résultat : trois modèles surpassent vingt-cinq
Le plus marquant dans ce travail, c'est le résultat de la comparaison. Une « foule » de seulement trois modèles-médoïdes, constituée par clustering comportemental, s'est montrée meilleure qu'un vote ordinaire sur les 25 modèles à la fois. Et cela vaut pour les deux benchmarks de prédiction.
L'économie réalisée est en outre considérable : le nombre d'appels aux modèles a diminué de 88 %, et les coûts d'inférence d'environ 80 %. Pour la pratique, c'est peut-être plus important encore que le gain de précision lui-même. Les systèmes de prédiction se heurtent souvent non pas à la qualité de la réponse, mais à son coût : si pour chaque question il faut interroger une vingtaine de modèles, la solution devient non rentable bien avant de devenir imprécise.
D'où une conclusion peu évidente : la composition de la « foule » pèse plus que sa taille. Vingt-cinq modèles ne constituent pas un avantage automatique face à trois, si ces vingt-cinq se répètent en substance les uns les autres.
Toute diversité n'est pas également utile
Les auteurs tirent une autre conclusion fine, facile à négliger. Il s'avère que l'important n'est pas la maximisation de la diversité en soi, mais la représentativité — à quel point les participants choisis reflètent les différents pôles de comportement présents parmi les modèles.
La différence est fondamentale. On peut réunir trois modèles qui diffèrent les uns des autres de façon aléatoire et sur des détails — et obtenir du bruit au lieu d'un signal. Ou bien sélectionner un modèle dans chacune des groupes comportementaux réellement distincts — et obtenir un ensemble compact qui couvre l'espace des solutions. Le premier cas, c'est l'hétérogénéité disparate ; le second, la diversité véritable. C'est le second qui fonctionne.
Une parallèle s'impose ici avec l'expertise ordinaire. Une bonne commission n'est pas celle où il y a le plus de gens, mais celle où sont représentées différentes approches et points de vue. Cinq spécialistes de domaines différents sont généralement plus utiles que quinze diplômés d'une même chaire.
Ce que cela signifie en pratique
Pour ceux qui construisent des services de prédiction sur des modèles de langage, les conclusions de l'article donnent une recette assez concrète :
- Ne pas courir après la longueur de la liste des modèles. Élargir le pool sans analyser les comportements, c'est payer pour des réponses dupliquées.
- Mesurer d'abord le comportement, choisir ensuite la composition. Un passage sur des tâches étrangères et un clustering donnent une image claire de qui, dans l'ensemble, se distingue réellement.
- Économiser en connaissance de cause. Réduire d'un ordre de grandeur le nombre d'appels tout en maintenant ou en améliorant la précision change l'économie d'un produit, et pas seulement ses caractéristiques techniques.
- Garder à l'esprit les limites. Tout cela a été vérifié sur un ensemble précis de 25 modèles et deux benchmarks de prédiction ; il ne faut pas transposer les chiffres tels quels à d'autres domaines et d'autres modèles.
L'idée principale du travail résonne de façon presque humaine : la valeur de l'opinion collective ne repose pas sur le nombre de voix, mais sur le fait que ces voix soient réellement différentes. Appliqué aux modèles de langage, cela signifie qu'il faut mesurer non pas une liste de noms, mais un style de pensée — et constituer l'équipe à partir de celui-ci.


