
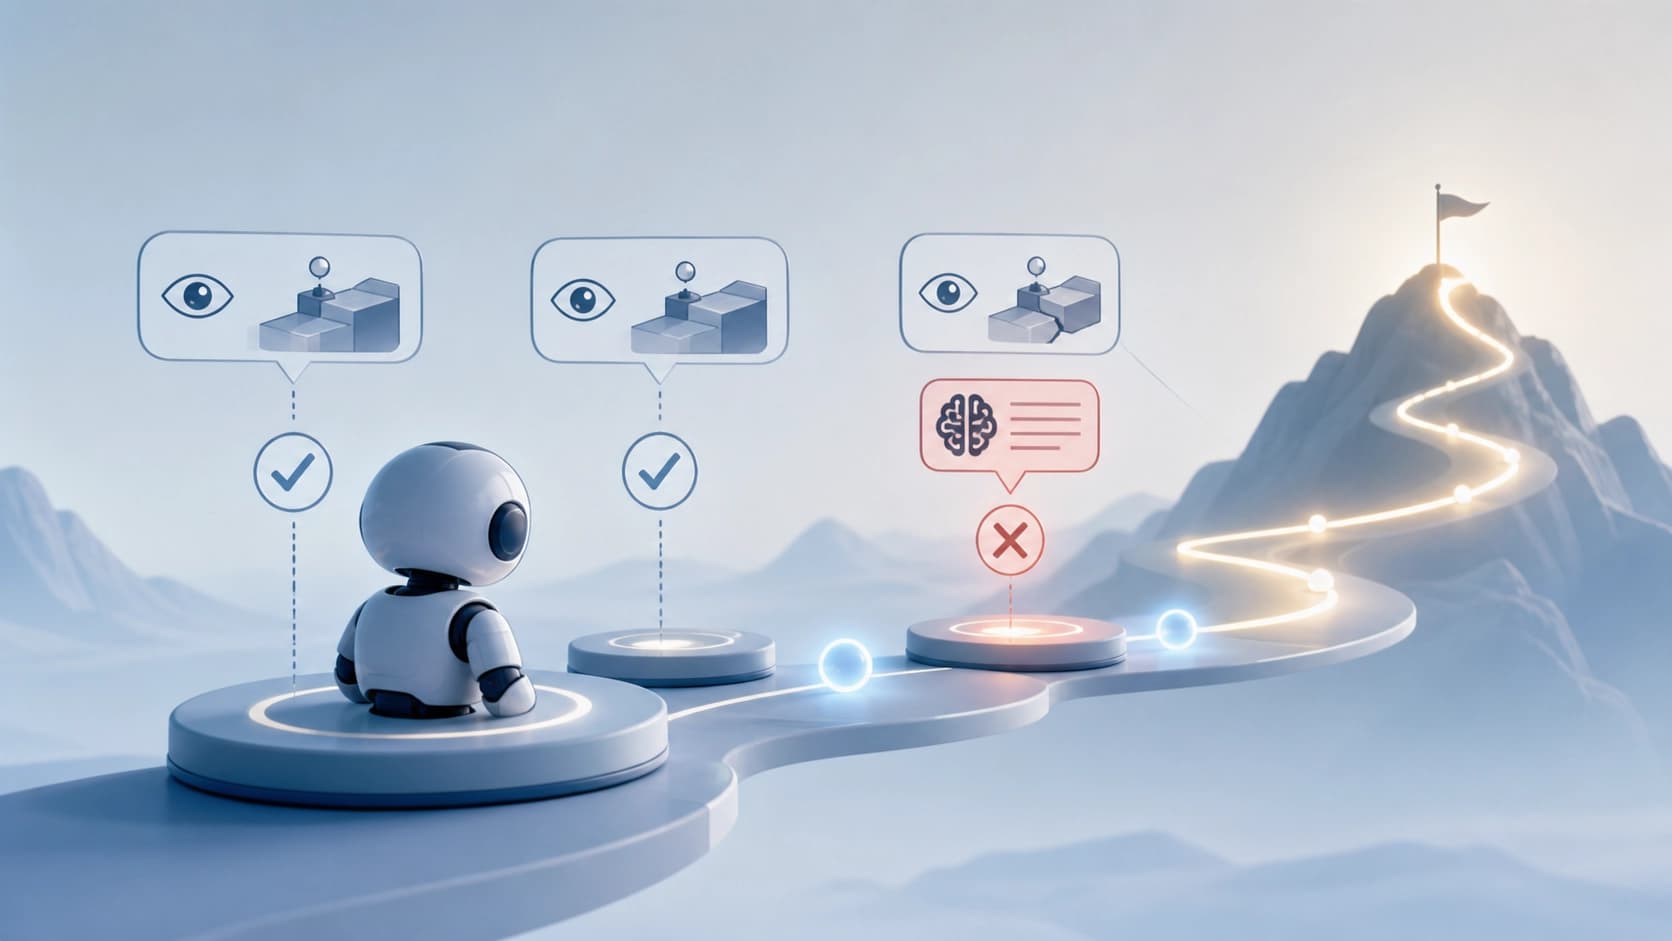
Problème : une récompense unique pour toute la trajectoire
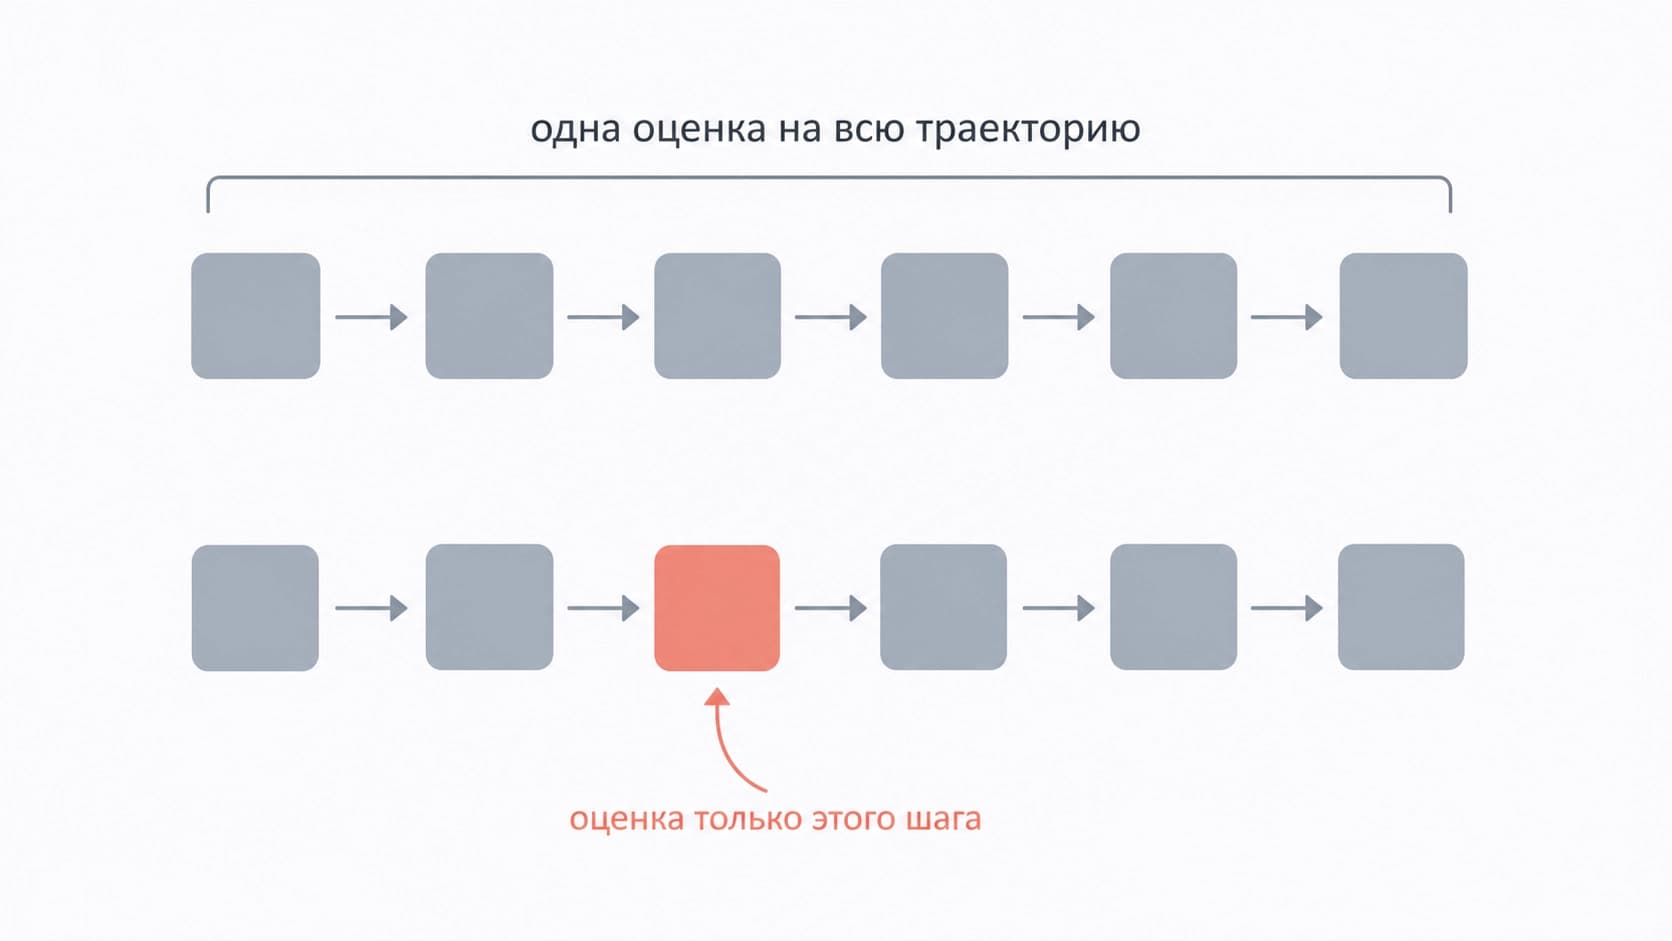
Les agents multi-étapes basés sur des LLM apprennent par essais et erreurs : ils exécutent une chaîne d'actions, reçoivent une évaluation finale et ajustent leur comportement en fonction de celle-ci. Le hic, c'est que cette évaluation porte généralement sur l'ensemble de la trajectoire. L'agent apprend que la tâche est réussie ou échouée, mais pas à quelle étape précise les choses ont mal tourné.
Ensuite commence une arithmétique qui s'accorde mal avec le bon sens. Le même avantage est étalé sur toutes les étapes successives — aussi bien sur le choix judicieux d'un outil que sur une faute de frappe accidentelle dans la requête, ou sur le « confirmer l'action » routinier. Résultat : le modèle récompense en même temps les erreurs aléatoires et les étapes de travail normales, si le résultat final s'avère un succès. Le crédit de la réussite revient à tous à parts égales, et la faute de l'échec aussi.
Le remède classique — l'auto-distillation avec information privilégiée. L'enseignant en sait plus que l'élève : il a accès à l'environnement, aux signaux intermédiaires, à la bonne réponse. Il peut donner des indications à chaque étape, et pas seulement à la fin. Cela sonne bien, mais cette approche comporte une négligence cachée : la même indication est délivrée à toutes les étapes sans distinction.
L'asymétrie des étapes : la routine et les erreurs ont besoin de choses différentes
L'idée clé du travail AHEAD est que les étapes d'une trajectoire ne sont pas équivalentes, et que la supervision doit elle aussi être différente pour chacune.
- Les étapes routinières — ouvrir une page, confirmer une transition, appeler l'outil adéquat — n'ont presque pas besoin d'indications. Le modèle s'en sort déjà. Une guidance superflue ne fait ici que bruiter l'apprentissage et consommer du budget.
- Les étapes critiques comportant une erreur — là où l'agent a pris la mauvaise direction et perdu une chance de réussir — exigent non pas un simple constat « c'est mauvais ici », mais une direction concrète : ce qu'il aurait fallu faire à la place.
- Le retour d'information de l'environnement ancre bien ce qui se passe : il dit ce qui s'est réellement produit. Mais il ne sait pas expliquer comment il aurait fallu agir. Le signal « la porte ne s'est pas ouverte » n'indique pas où se trouvait la clé.
Il en résulte que les deux sources de supervision se complètent, mais ne se remplacent pas. Le feedback de l'environnement fournit un signal dense et honnête à chaque étape ; les indications correctives générées par le modèle apportent ce qui est par principe absent du feedback de l'environnement — l'intention et l'alternative. Les mélanger aveuglément sur toute la trajectoire, c'est perdre les atouts des deux.
Comment fonctionne AHEAD
Les auteurs — Xiaolong Jin, Dingmin Wang, Vijay Lingam et Varun Kumar — proposent un framework qui prend conscience du type d'étape et choisit en conséquence la source de supervision. Le travail a été publié sur arXiv fin août 2026, rubrique cs.AI ; volume — 22 pages, 15 figures et 7 tableaux, donc de la matière pour les détails, il y en a.
Un enseignant qui voit l'environnement
Le modèle enseignant reçoit le feedback de l'environnement sur toutes les étapes — c'est un signal ancré et dense, également disponible sur les segments réussis comme sur les segments échoués. Un tel enseignant ne fantasme pas : il s'appuie sur ce qui s'est réellement produit dans l'environnement.
Des indications correctives — de manière ciblée
Par-dessus, l'enseignant reçoit des indications générées par LLM, mais pas sur toutes les étapes, précisément sur les étapes erronées. La logique est simple : là où l'agent s'est trompé, le seul fait issu de l'environnement ne suffit pas, il faut une explication de la direction à prendre. Là où tout se passe bien, aucune guidance supplémentaire n'est ajoutée.
C'est là l'« indication ciblée » du titre : non pas étalée sur la trajectoire, mais concentrée sur les points problématiques. Une mise en correspondance des sources de supervision consciente des étapes, au lieu d'un signal unique pour toute la chaîne d'actions.
Des modifications minimales à GRPO
Il faut souligner à part la sobriété d'ingénierie de la méthode. GRPO — un algorithme populaire d'apprentissage par renforcement — n'est pas réécrit de zéro : les changements sont apportés de manière ciblée, par-dessus le schéma standard. Pour les praticiens, c'est important, car cela ne nécessite pas de reconstruire tout le pipeline d'entraînement de l'agent.
Ce qu'ont montré les expériences
L'évaluation a porté sur trois types de tâches : ALFWorld — des scénarios multi-étapes dans un environnement textuel, WebShop — l'interaction avec une boutique en ligne, et un question-réponse de recherche. Trois échelles de modèles ont été testées, de sorte que les conclusions ne sont pas liées à une seule taille.
Résultats par rapport à GRPO classique :
- +13,3 points de taux de réussite sur ALFWorld avec un modèle de 7B ;
- +11,0 points sur WebShop à la même échelle.
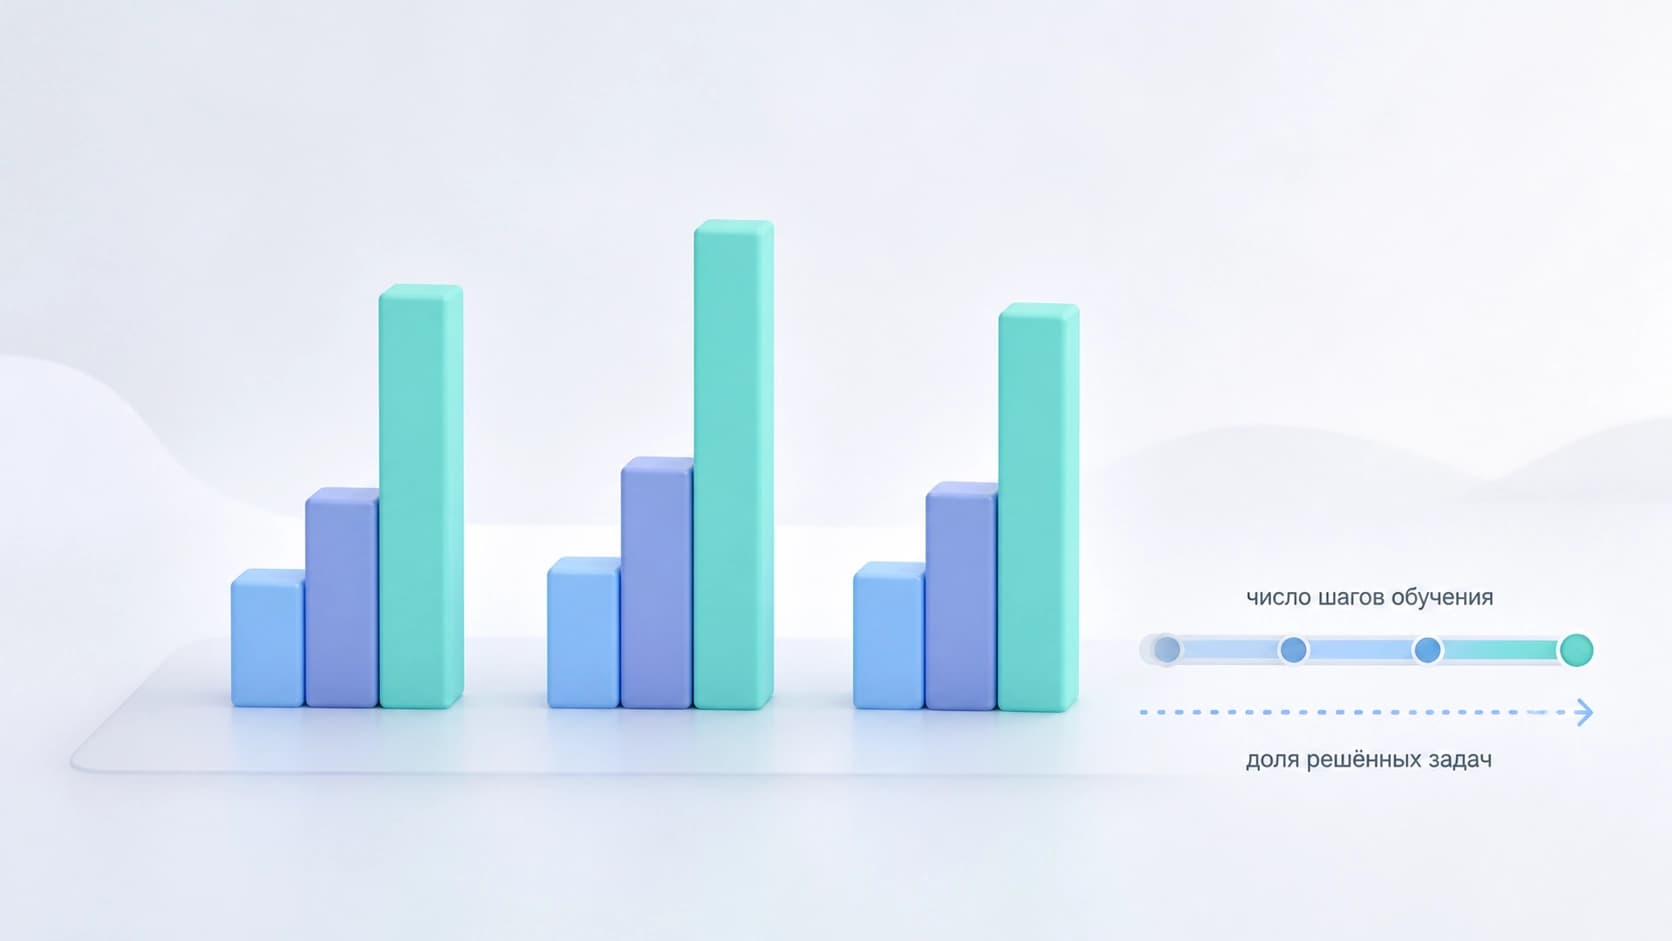
Outre les chiffres absolus, il y a deux effets tout aussi intéressants. Premièrement, le niveau de réussite visé est atteint en moins d'étapes d'entraînement — c'est-à-dire que la méthode n'est pas seulement meilleure à la limite, mais atteint aussi plus vite une condition opérationnelle. Deuxièmement, l'agent résout les tâches dans des budgets d'interaction plus restreints que les approches fondées uniquement sur la récompense finale et que les méthodes d'auto-distillation précédentes.
Le deuxième point, à mon avis, est sous-estimé. L'économie d'étapes d'interaction n'est pas qu'une métrique esthétique. Dans des scénarios réels, chaque appel d'outil coûte de l'argent, du temps et du risque. Un agent qui atteint son but en cinq actions au lieu de dix est utile non pas de 13 pour cent, mais plusieurs fois plus — surtout là où le coût d'une erreur est élevé.
Pourquoi cela fonctionne et ce qui reste hors champ
L'explication de la méthode est presque pédagogique. Un bon enseignant ne commente pas chaque mouvement de l'élève — il se tait tant que celui-ci fait des choses raisonnables, et intervient précisément là où l'élève s'est écarté du chemin. Si l'on commente tout sans arrêt, l'élève cesse de réfléchir par lui-même et se met à attendre des indications. Si l'on ne commente rien, il répétera les mêmes erreurs.
AHEAD formalise cette intuition en termes d'apprentissage par renforcement : type d'étape différent — source de signal différente. Un feedback dense et ancré — comme toile de fond, une direction corrective — comme accent. Aucune magie, juste le rejet de l'idée que toutes les étapes sont égales.
Ce qui reste en question. La génération d'indications correctives requiert elle-même un modèle, ce qui ajoute des coûts de calcul et dépend de sa qualité — si l'enseignant explique de manière erronée, l'élève recevra une direction assurée mais incorrecte. Reste également ouverte la question de savoir dans quelle mesure la méthode se transpose à des tâches où le coût d'une étape intermédiaire n'est pas aussi évident que dans ALFWorld ou WebShop, et où le caractère « erroné » d'une étape ne peut pas toujours être déterminé immédiatement, mais seulement par ses conséquences différées.
Néanmoins, la direction semble saine. La ligne principale de développement des méthodes agentiques de ces dernières années — non pas agrandir le modèle, mais gérer plus intelligemment le signal d'apprentissage. AHEAD relève précisément de cette ligne : une intervention ciblée au lieu d'un contrôle total.


