
Des données brutes au lieu de tableaux prêts à l'emploi
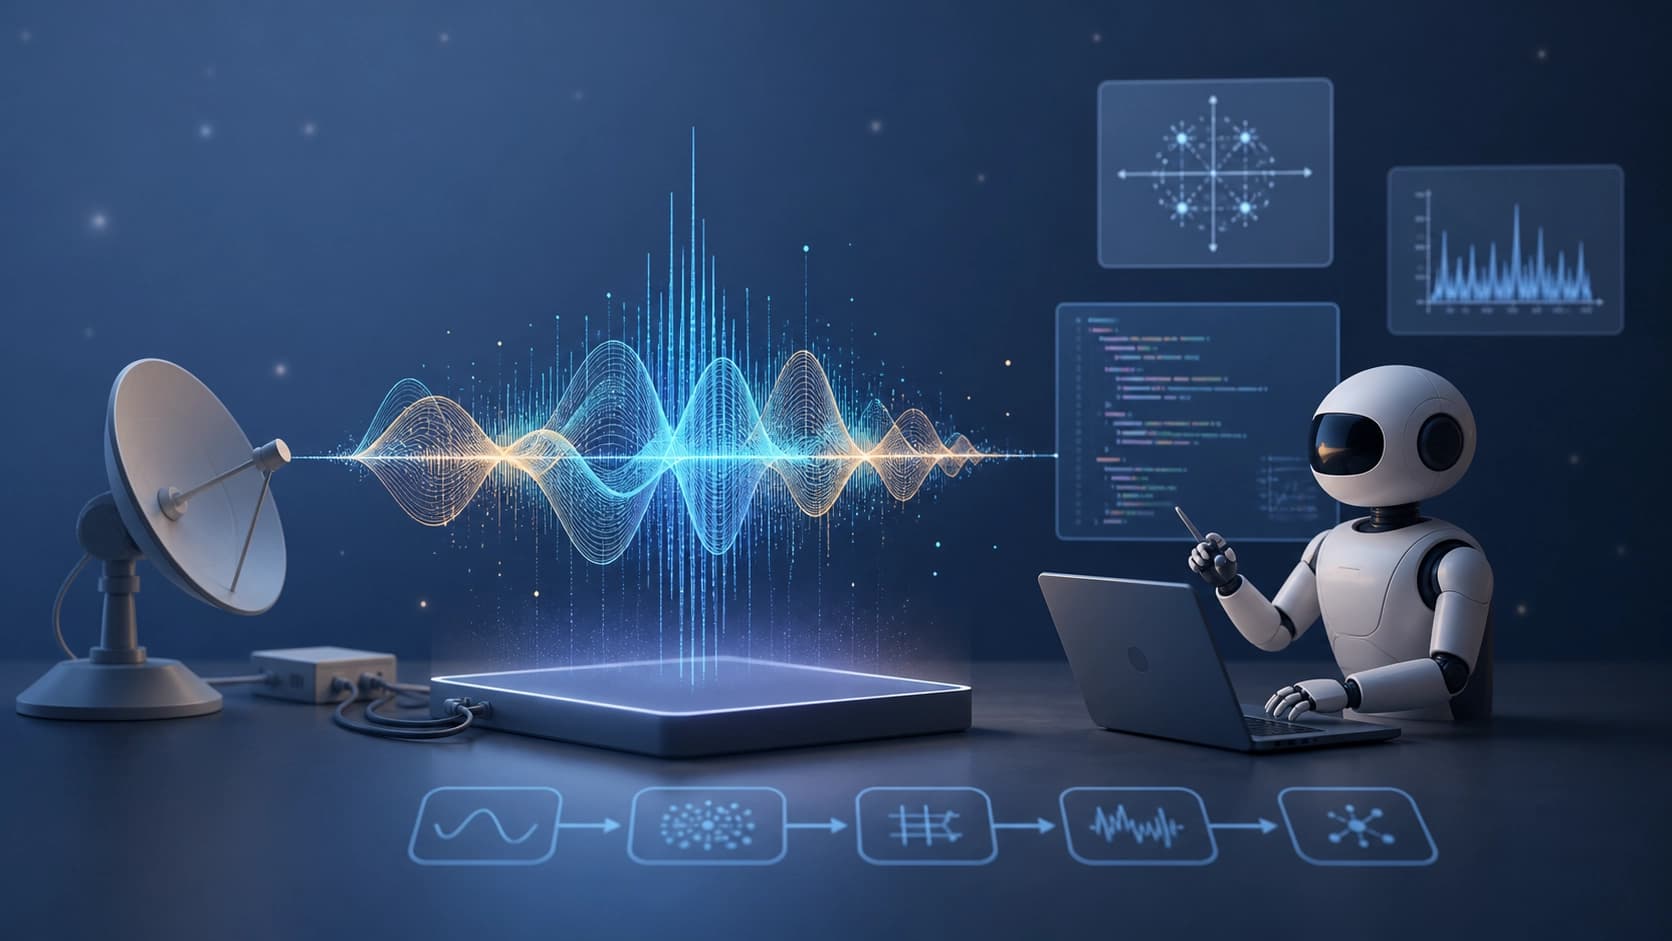
Les modèles jouent de plus en plus le rôle d'agents de code : on leur confie l'écriture de scripts pour traiter des données, tracer des graphiques, calculer des métriques, analyser des extractions d'ingénierie. Mais il existe une catégorie de tâches qui n'avait jusqu'ici presque jamais été évaluée — le travail sur les « matières premières » du niveau physique. C'est précisément cette niche que comble le benchmark EMRB (Electromagnetic Reasoning Benchmark), décrit dans le préprint arXiv:2608.24086 (sections cs.AI, cs.CE, cs.SE).
L'idée clé est simple, et c'est ce qui la rend convaincante. En entrée, uniquement des enregistrements I/Q bruts, c'est-à-dire des échantillons en quadrature du signal, tels qu'ils arrivent du récepteur. Aucune caractéristique prétraitée, aucun spectrogramme annoté, et encore moins de tableaux avec des valeurs toutes faites. La grandeur à laquelle se rapporte la question, le modèle doit d'abord la détecter dans les données — au moyen d'un code qu'il écrira et exécutera lui-même.
En quoi cela diffère des évaluations habituelles
Ces dernières années ont vu apparaître un grand nombre de jeux de tâches où l'on propose aux modèles de raisonner sur des signaux radio. Mais le plus souvent, le travail a déjà été fait à leur place : on a extrait des caractéristiques de l'enregistrement, calculé le spectre, estimé le niveau de bruit, et tout consigné dans un tableau structuré. Dans une telle configuration, il ne reste que de l'arithmétique et de la comparaison de nombres — des compétences utiles, mais sans rapport avec la radiofréquence.
La différence est fondamentale. Quand les grandeurs sont données à l'avance, une erreur du modèle à une étape précoce reste invisible : une mauvaise estimation de bande ou de fréquence ne se produit tout simplement pas, puisque ces valeurs figurent dans l'énoncé. Quand les données sont brutes, toute erreur au stade de la reconnaissance du signal entraîne tout le calcul qui suit. C'est pourquoi EMRB ne teste pas la connaissance des termes, mais la capacité à construire une chaîne : observer les échantillons, comprendre de quel signal il s'agit, isoler la caractéristique voulue, la calculer correctement et ne pas perdre les dimensions.
Comment le benchmark est structuré
Les auteurs — Mingxu Zhang, Ying Sun, Yuhan Li, Yang Ji, Dazhong Shen, Ke Zhang et Shan Huang — ont rassemblé 200 tâches. Elles sont réparties sur cinq niveaux de difficulté et 27 types de questions : de la simple détection de signal à la conception d'un système OFDM. La source du matériau est constituée de 11 types de signaux, pour chacun desquels une vérité de référence vérifiée a été préparée.
Cinq niveaux
Les niveaux sont ordonnés selon l'autonomie croissante du modèle. En bas, les mesures de paramètres de base : trouver un signal, estimer ses caractéristiques. Plus haut, l'interprétation et la comparaison, puis l'analyse en plusieurs étapes, ensuite le diagnostic et, enfin, la conception systémique, où l'on attend du modèle non pas qu'il mesure, mais qu'il conçoive une solution répondant à des exigences données.
27 types de questions et 11 types de signaux
Cette diversité vise à ce que le résultat ne dépende pas d'une formulation heureuse ou malheureuse. Les différents types de signaux présentent différents pièges : ici le bruit gêne, là c'est le chevauchement spectral, ailleurs il faut composer avec précaution avec l'échantillonnage. Le nombre de types de questions et de signaux forme ensemble un espace dans lequel il est difficile de tomber juste par hasard.
Données ouvertes
Tous les matériaux et le code sont publiés dans un dépôt GitHub public, de sorte que le résultat peut être vérifié indépendamment. Pour un benchmark, c'est plus important que d'ordinaire : si les tâches sont générées plutôt que collectées manuellement à partir d'enregistrements de terrain, la question de la validité des références devient centrale — et l'ouverture est ici la seule réponse qui fonctionne.
Ce que les modèles ont montré
Quatorze modèles de langage ont été testés : propriétaires, à poids ouverts et, séparément, des modèles orientés raisonnement. L'écart final va de 24,1 % à 78,9 %. Ce seul intervalle en dit long : la différence entre le meilleur et le moins bon modèle se mesure ici non pas en pourcentages, mais en facteurs.
Mais il y a plus intéressant. Le résultat moyen chute brutalement à mesure que le niveau se complique : de 84,9 % sur les mesures de base à 21,2 % sur la conception systémique. Autrement dit, les modèles s'en sortent plutôt bien lorsqu'il faut calculer une grandeur mesurable, et s'effondrent presque lorsqu'il faut assembler une solution fonctionnelle à partir de ces grandeurs.
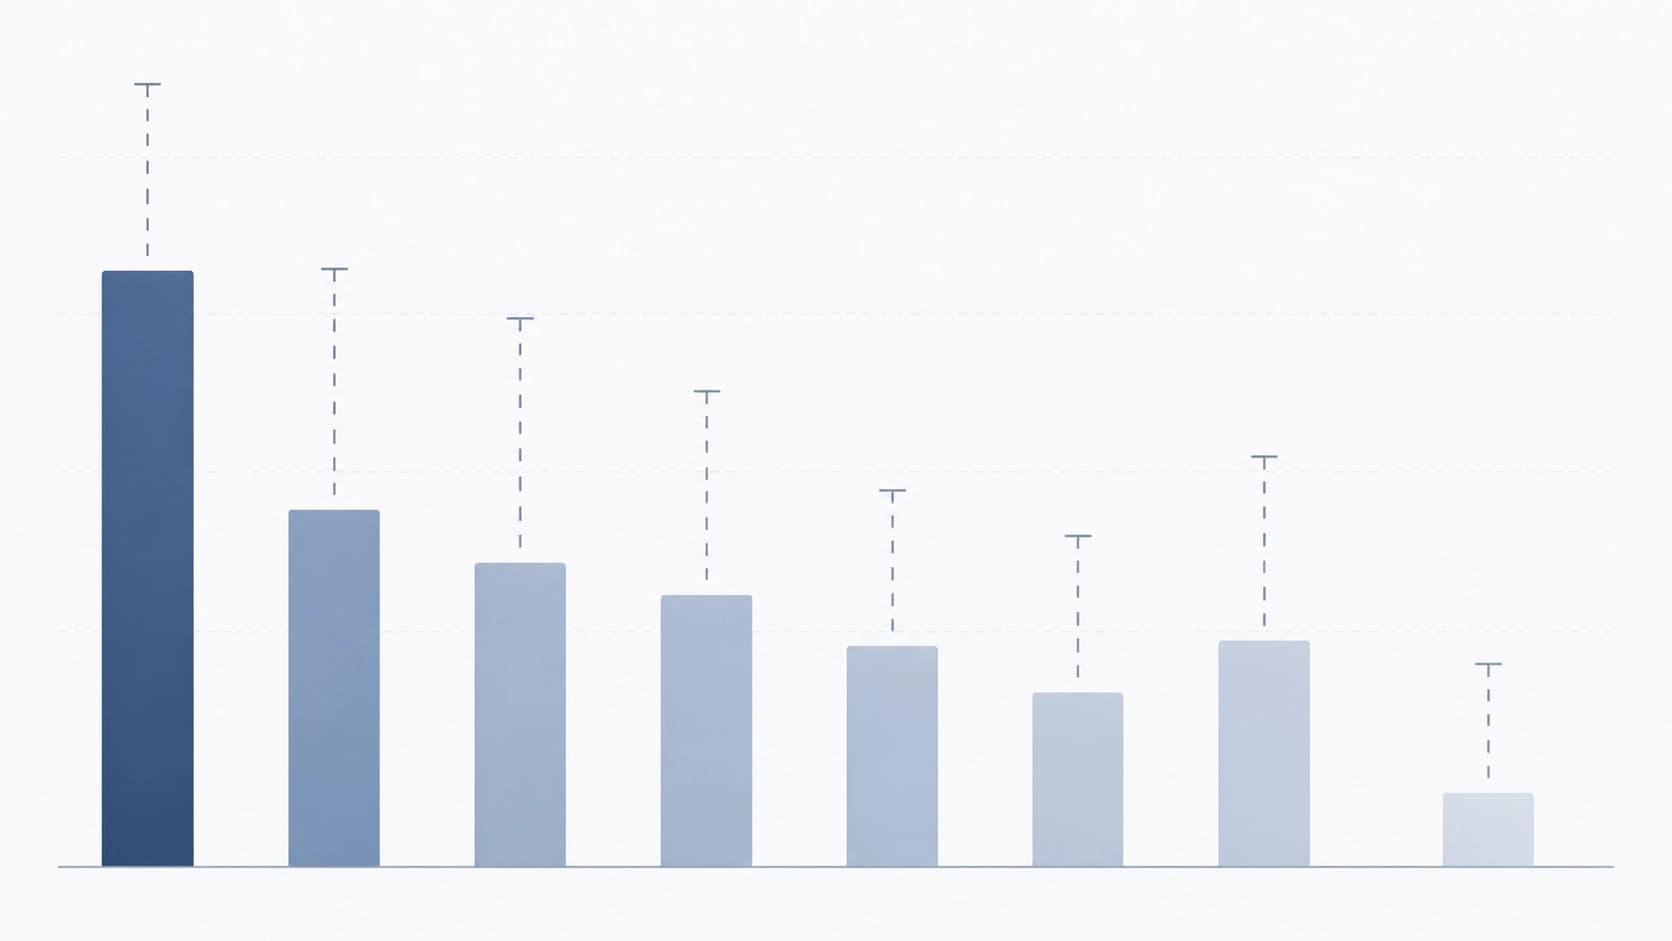
Cela se lit comme un diagnostic, non comme un classement. Le point fort des modèles actuels, c'est l'exécution de code et l'arithmétique sur une configuration connue. Le point faible, c'est la traduction d'une tâche d'ingénierie en étapes mesurables : comprendre quelles grandeurs sont nécessaires, dans quel ordre les chercher, comment vérifier que ce qui a été trouvé ressemble vraiment à quelque chose de plausible. C'est précisément cet écart qui rend le benchmark utile.
ReconPilot : reconnaissance, analyse, vérification
Les auteurs ne se sont pas limités à la mesure. Ils ont proposé ReconPilot — une approche structurée dans laquelle le travail est divisé en trois étapes : reconnaissance du signal, analyse ciblée et auto-vérification. D'abord, le modèle étudie l'enregistrement et se forge une représentation de ce à quoi il a affaire. Ensuite, il résout la tâche concrète. Puis il revient sur son résultat et en vérifie la cohérence.
Sur trois modèles de base, la méthode ajoute au score global de 3,8 à 17,6 points. L'amélioration est obtenue dans 13 des 15 combinaisons « backbone + niveau » testées. Notez la formulation : le gain n'est pas uniforme, et dans deux cas il est totalement absent. C'est un signe normal d'une expérience honnête — il n'existe pas de remède universel, mais la tendance est solide.
Il est révélateur que ce soit précisément la séparation explicite des phases qui aide. Un modèle à qui l'on demande simplement d'« analyser un signal » a tendance à sauter directement aux calculs sans s'être assuré qu'il a compris les données. La reconnaissance, en tant qu'étape obligatoire distincte, force à d'abord observer, puis à calculer.
Ce qu'il faut en retenir
Pour la pratique de l'ingénierie, la conclusion est assez directe : avant de confier à un agent des calculs sur des mesures réelles, il vaut la peine de le tester sur des données sans indices. Une interface pratique et une réponse fluide dans le chat ne disent rien de la capacité d'un modèle à survivre à une extraction brute issue d'un récepteur.
Il y a aussi une idée plus générale, qui dépasse le cadre de la radio. Dans tout domaine où le raisonnement s'appuie sur des mesures brutes — hydroacoustique, vibrations, télémétrie —, l'agent doit savoir d'abord trouver la grandeur dans les données, puis travailler avec elle. Les tableaux de caractéristiques masquent cette partie du travail, et avec elle, les erreurs.
Limites et perspectives
La question n'est pas entièrement close. 200 tâches, c'est un volume honorable, mais pas illimité, et une génération fondée sur 11 types de signaux signifie que les enregistrements de terrain réels, avec tous leurs artefacts, n'y sont tout de même pas représentés. L'évaluation de 14 modèles est un instantané, non un verdict : la composition des leaders dans ce domaine évolue vite.
Néanmoins, la formulation du problème semble juste. Si nous voulons que les LLM travaillent non pas sur un résumé des données, mais sur les données elles-mêmes, il faut les tester précisément là où s'arrêtent les indices. EMRB fait exactement cela — et montre que la marge de progression des modèles en reconnaissance de signal est encore très grande.


