
Un juge trop facile à croire
Les modèles multimodaux jouent de plus en plus le rôle d'arbitres : ils regardent une image, une vidéo ou écoutent un audio et rendent un verdict — le résultat correspond-il à la requête textuelle ? Ces juges « omnivores » servent aussi bien à évaluer les systèmes génératifs qu'à l'annotation automatique de données, quand les experts humains ne suffisent pas à tout couvrir.
La logique est claire : si un modèle sait comprendre plusieurs modalités à la fois, pourquoi ne pas lui confier la vérification du text-to-image, du text-to-video et du text-to-speech ? Mais une question dérangeante se cache ici. Une bonne précision globale d'un tel juge ne signifie pas encore qu'il voit réellement ce qu'il évalue. Les jeux de tests et les corpus d'entraînement existants sont généralement biaisés en faveur des exemples réussis, et les différents types d'échecs y sont amalgamés.
Le résultat — une image faussée. Le juge affiche des chiffres corrects parce qu'il a appris à dire « oui », et ses véritables angles morts restent invisibles. C'est précisément ce problème qu'aborde un nouveau travail issu d'arXiv.
Ce que proposent les auteurs : D3-Omni
L'étude est parue sous un titre que les auteurs eux-mêmes ont construit sur un contraste : « OmniJudge or OmniBias? ». Plutôt qu'un classement de plus, ils ont assemblé un outil de diagnostic — D3-Omni, un benchmark conçu pour ne pas laisser le juge se cacher derrière une statistique globale. Le nom se décompose en trois principes, et chacun d'eux frappe une faiblesse précise des tests habituels.
Dual-balanced : le biais en faveur du « tout va bien » est éliminé
Le premier principe assure l'équilibre. Au lieu de constituer les exemples au hasard, l'ensemble est équilibré : pour chaque caractéristique vérifiée, il doit y avoir un nombre comparable de cas réussis et de cas échoués. Disparaît ainsi la situation où le modèle accumule des points simplement parce que la bonne réponse est plus souvent « oui ».
Decoupled : une erreur — une cause
Le deuxième principe — le découplage. Chaque défaut du test est rattaché à exactement une capacité. Si le juge se trompe, on comprend ce qui lui a manqué : la compréhension de la composition, de la couleur, de la synchronisation du son ou autre chose. Aucun exemple composite où l'on ne sait pas laquelle des trois violations a fait trébucher le modèle.
Dynamic : le test s'adapte aux progrès des générateurs
Le troisième principe — la dynamique. La construction du test est orientée là où la représentation des exemples fait encore défaut, au fur et à mesure que les modèles génératifs investissent de nouveaux domaines. L'objectif — maintenir une parité d'environ un pour un sur chaque caractéristique et un remplissage uniforme de tous les niveaux du score final.
Comment le jeu de données est structuré
L'échelle de D3-Omni est conséquente : 53 caractéristiques binaires, réparties sur trois tâches (17, 22 et 14 pour chacune), et 10 671 exemples (3 526, 1 998 et 5 147 respectivement). Les caractéristiques sont choisies de manière orthogonale — elles ne se dupliquent pas.
Un détail d'ingénierie à part — la façon dont sont obtenus les exemples négatifs. Les auteurs ont délibérément renoncé à la régénération des sorties : cette voie entraîne une fuite d'information entre les caractéristiques, et le test cesse d'être propre. À la place, on prend des « graines » entièrement positives et vérifiées, et les violations sont introduites de manière contrôlée — en réécrivant le prompt et en ajoutant des perturbations ciblées qui isolent une seule caractéristique.
Ce qui ressort : les juges louent avec assurance et repèrent mal les défauts
Le plus intéressant dans ce travail — ce n'est pas la conception du benchmark, mais ce qu'il a révélé. Même de solides juges multimodaux trébuchent sur des caractéristiques directement liées à la modalité. Autrement dit, ce pour quoi on les recrute comme évaluateurs est justement ce qui leur est difficile.
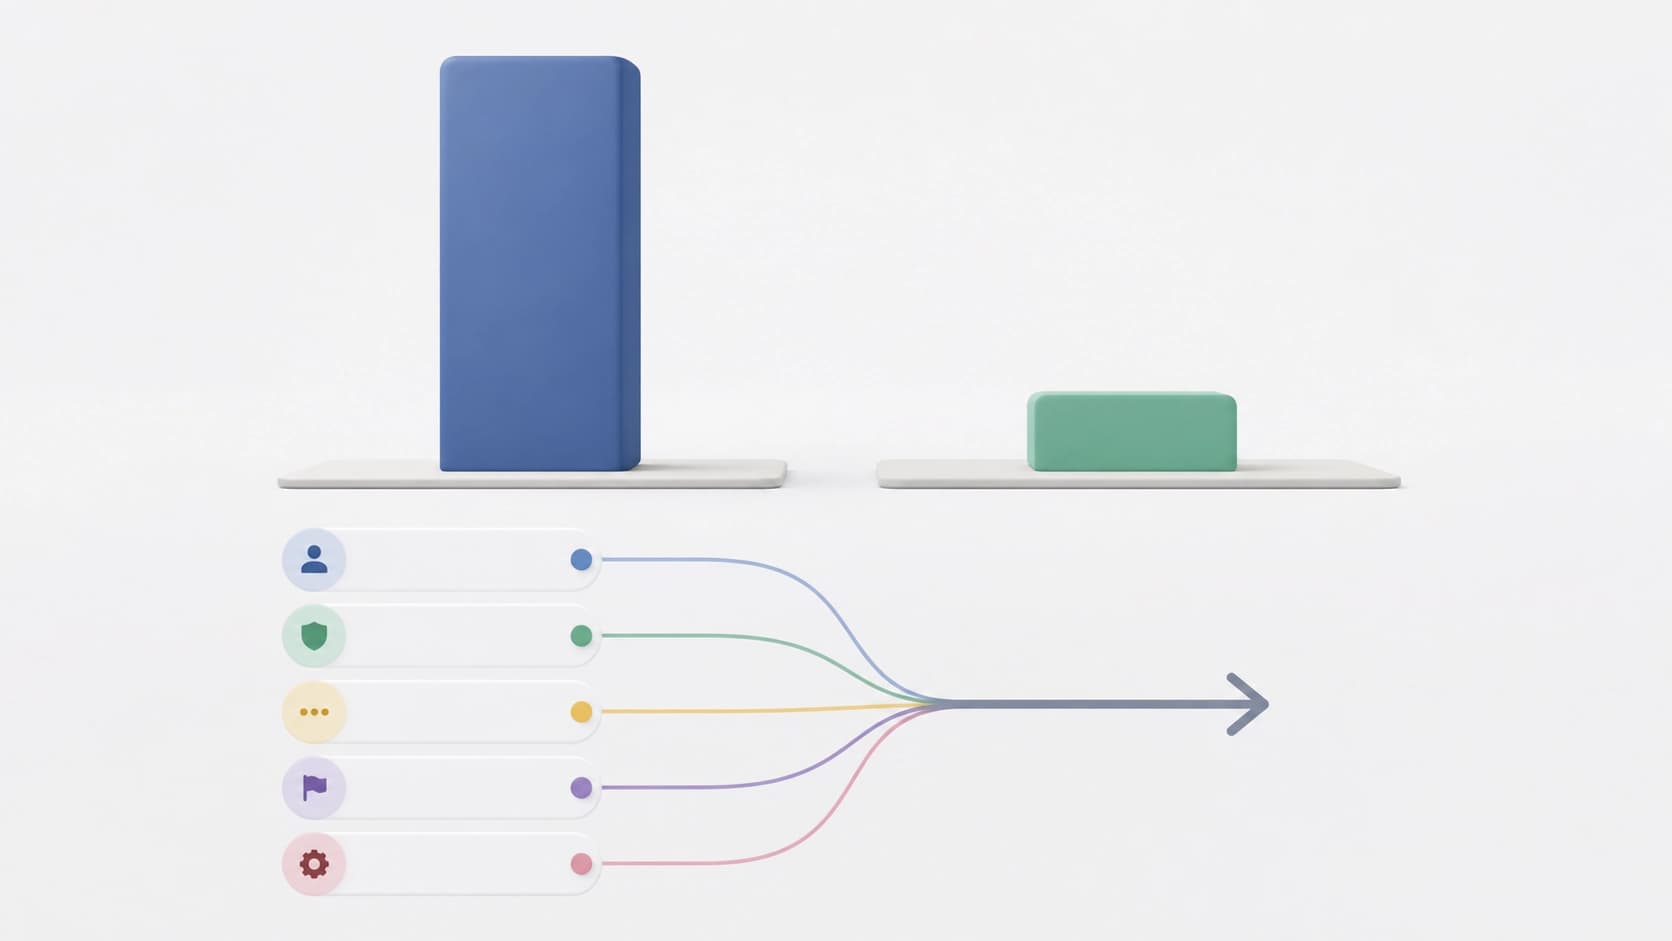
La deuxième observation est encore plus désagréable. Les modèles confirment nettement plus fiablement les exigences satisfaites qu'ils ne détectent celles qui sont violées. L'asymétrie est stable : dire « ici tout correspond à la requête » est bien plus facile pour un juge que de repérer une non-conformité précise.
Troisième point — des attributs nominalement différents, le modèle tend à les percevoir comme une seule décision globale. Les différences entre propriétés s'estompent, et le juge rend un verdict généralisé au lieu d'une analyse point par point.
Pourquoi un pourcentage agrégé trompe
De ces observations découle la conclusion principale : la précision finale peut masquer des angles morts systématiques. Un juge qui devine systématiquement la réponse « positive » aura l'air correct sur un ensemble biaisé — et échouera là où il faut repérer une erreur du générateur.
Une optique équilibrée et découplée n'est pas nécessaire pour la beauté de la métrique, mais pour rendre ces zones enfin visibles. Et une fois vues — on peut les combler de manière ciblée : en affinant l'entraînement sur les caractéristiques problématiques, plutôt qu'en courant après la note moyenne.
Pour la pratique, cela signifie une chose simple. Si vous assemblez un pipeline où un modèle-juge filtre les résultats de génération ou annote un dataset, il faut le tester sur un ensemble biaisé vers les négatifs, et non sur un échantillon commode d'exemples réussis. Sinon, l'évaluateur laissera passer les défauts, et vous l'apprendrez des utilisateurs, pas des métriques.
En bref
- D3-Omni — un benchmark pour diagnostiquer les juges multimodaux, pas un classement de modèles.
- Trois principes : l'équilibre entre exemples positifs et négatifs, le rattachement de chaque erreur à une seule capacité, l'adaptation du test à l'évolution des générateurs.
- 53 caractéristiques et près de 11 000 exemples sur les tâches text-to-image, text-to-video et text-to-speech.
- Les négatifs sont créés en réécrivant les prompts et par des perturbations ciblées, et non par régénération — afin de ne pas mélanger les caractéristiques.
- Conclusion principale : un résultat moyen élevé peut dissimuler des angles morts persistants, surtout là où il faut remarquer une violation plutôt que confirmer une conformité.


