Aliments pour animaux

355 matériaux

Trier par
Nouvelles5 novembre 2026

Évaluation des agents de programmation pour le développement XR interactif : résultats de GenXR-Bench

GenXR-Bench est publié : un ensemble de 112 tâches expertes pour évaluer de bout en bout les agents de programmation dans le développement XR interactif, de l’amélioration de fonctionnalités et de la correction de défauts à la création d’applications dont le comportement est testé sur du matériel grand public. Parmi les dix modèles testés, le meilleur résultat a été de 50,9 % en Pass@1 ; les défaillances récurrentes concernent notamment la gestion des événements asynchrones des capteurs, l’ancrage des objets dans l’espace réel et la compréhension des interactions dans un contexte physique.


Évaluation des agents de programmation pour le développement XR interactif : résultats de GenXR-Bench
Lire
Nouvelles5 novembre 2026

De la récompense scalaire au front de Pareto : synthèse RTL par LLM avec apprentissage par renforcement multicritère

Une méthode est proposée pour entraîner un modèle de langage à générer non pas un seul schéma, mais un ensemble de candidats RTL offrant différents compromis entre surface, latence et consommation d’énergie ; la récompense est calculée en fonction de la contribution de chaque variante à l’hypervolume du front de Pareto. Sur RTLLM v2, l’hypervolume relatif a augmenté de 13,3 points de pourcentage par rapport à la version de base sans optimisation PPA et de 14,4 points de pourcentage par rapport à l’apprentissage par renforcement mono-objectif.

De la récompense scalaire au front de Pareto : synthèse RTL par LLM avec apprentissage par renforcement multicritère
Lire
Nouvelles4 novembre 2026

Les LLM médicales sont informés des révisions des recommandations, mais répondent souvent selon les anciennes règles

L’étude de ChronoEvo portant sur 1 709 changements dans les recommandations cliniques montre que, dans le modèle principal, 90,8 % des réponses repéraient la nouveauté, mais que seules 58,5 % l’appliquaient intégralement, avec un écart de 32,3 points de pourcentage observé dans 14 modèles. Même en renforçant la visibilité des mises à jour, le transfert intégral des nouvelles règles dans les recommandations cliniques n’a pas connu de hausse significative.

Les LLM médicales sont informés des révisions des recommandations, mais répondent souvent selon les anciennes règles
Lire
Nouvelles4 novembre 2026

Modèle du monde pour les agents basés sur des LLM fermés : correction aux points de risque

PAWM est proposé comme un prédicteur externe qui ne reproduit pas l’observation étape par étape, mais s’active en cas d’échec probable et détourne l’agent d’une action erronée. Après un SFT sur des scénarios synthétiques et un co-entraînement GRPO, la méthode a enregistré des gains de 24,3 % sur ScienceWorld et de 7,7 % sur WebArena-Lite pour Claude Sonnet 4.5.

Modèle du monde pour les agents basés sur des LLM fermés : correction aux points de risque
Lire
Comparaisons4 novembre 2026

Une couche de classification au-dessus de SpeechLLM : là où elle surpasse la génération d’étiquettes pour la reconnaissance des émotions

À partir des corpus IEMOCAP et MELD, l’étude compare la génération d’étiquettes émotionnelles à un classificateur linéaire appliqué aux représentations latentes d’une SpeechLLM compacte. Le gain de performance apporté par le classificateur n’est pas universel : il dépend du corpus et de l’utilisation de transcriptions de référence ou de résultats ASR.

Une couche de classification au-dessus de SpeechLLM : là où elle surpasse la génération d’étiquettes pour la reconnaissance des émotions
Lire
Nouvelles4 novembre 2026

Des évaluations individuelles aux ensembles admissibles : décodage global sous contraintes DDI

L’article compare une sélection globale exacte d’un ensemble compatible de médicaments, réalisée au moyen de la programmation linéaire en nombres entiers mixtes, à plusieurs méthodes locales de résolution des conflits DDI avec les scores FLAME fixés sur MIMIC-III. Sur l’échantillon de test, la méthode globale offre un gain faible mais constant en Jaccard, qui augmente lorsque les contraintes se durcissent et atteint +0.0064 par rapport à la meilleure méthode locale de référence.

Des évaluations individuelles aux ensembles admissibles : décodage global sous contraintes DDI
Lire
Nouvelles3 novembre 2026

Le passage au simplexe probabiliste réduit l’écart modal dans les modèles multimodaux contrastifs

L’article arXiv:2610.32890 propose de remplacer les embeddings sphériques par un simplexe probabiliste, en ajoutant de légers adaptateurs softmax et une similarité fondée sur la variation totale. Sur cinq benchmarks de recherche, la distance ℓ2 entre les centroïdes des modalités diminue de 97 à 99 %, tandis que la qualité de la recherche est maintenue ou améliorée.

Le passage au simplexe probabiliste réduit l’écart modal dans les modèles multimodaux contrastifs
Lire
Nouvelles3 novembre 2026

Comment ActionRAG réévalue les preuves lors de la propagation dans le graphe de mémoire des agents LLM

Une architecture de mémoire en graphe a été proposée : lors de l’indexation, elle harmonise soigneusement les entités, puis réévalue les relations au moment de la requête en s’appuyant sur la structure locale. Sur MemoryAgentBench, la méthode a atteint une précision moyenne de 55,1 et dépassé de 5,4 points de pourcentage le meilleur modèle de référence en récupération, tout en maintenant un faible coût de synthèse par requête.

Comment ActionRAG réévalue les preuves lors de la propagation dans le graphe de mémoire des agents LLM
Lire
Nouvelles1 novembre 2026

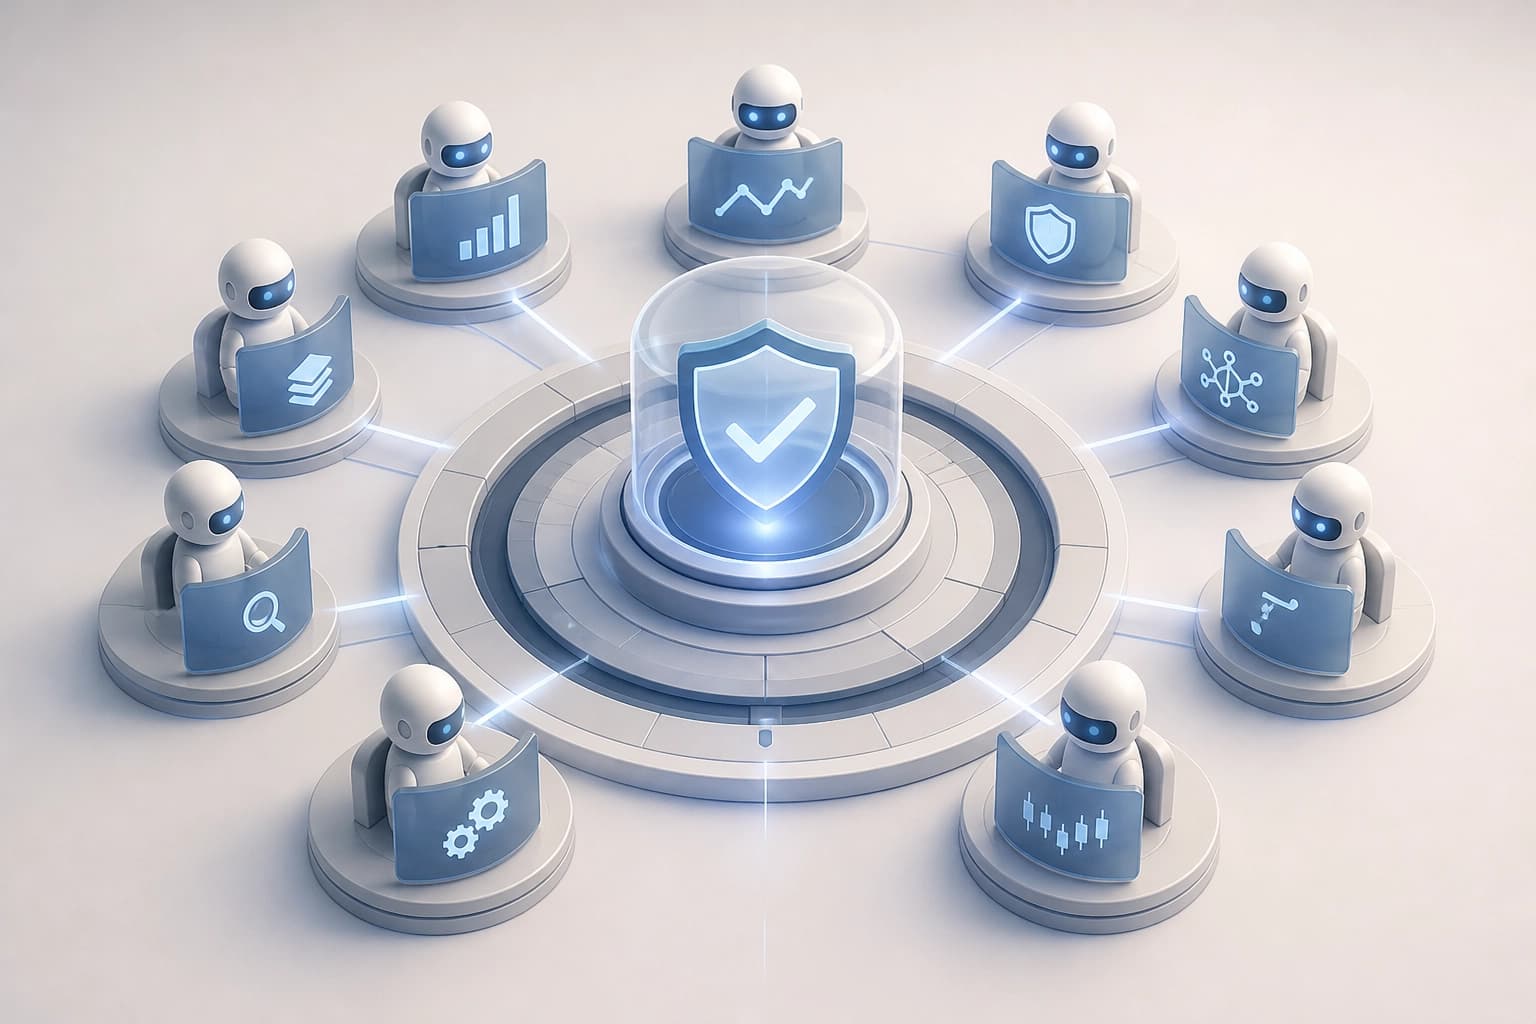
Développement maîtrisé des agents LLM dans l’investissement autonome : architecture multi-agents avec un périmètre de protection immuable

L’article décrit Steward, un système composé de neuf agents LLM spécialisés par rôle, dans lequel les décisions relatives au portefeuille sont examinées par un gestionnaire des risques et où les modifications des prompts ne sont autorisées qu’au moyen d’un contrôle réversible et de la reproduction des données enregistrées. La conclusion essentielle est qu’un noyau immuable et des procédures d’audit permettent de faire évoluer les agents sans leur confier le contrôle des règles de risque ni de l’exécution des ordres.

Développement maîtrisé des agents LLM dans l’investissement autonome : architecture multi-agents avec un périmètre de protection immuable
Lire