
Сигналами светофора управляет VLA-модель VLALight: сквозной вывод действий прямо из видео придорожных камер
Авторы предлагают VLALight — сквозную модель класса «зрение — язык — действие», которая переводит многовидовые записи с камер перекрёстка непосредственно в переключения сигналов, минуя вручную заданные состояния транспортного потока. В основе — совместное восприятие с учётом топологии узла, обучение с подкреплением на уровне городской сети и адаптивный выбор между быстрым и глубоким рассуждением; на семи наборах реальных данных в трёх городах решение превзошло базлайны на транспортных моделях, обучении с подкреплением и LLM/VLM.
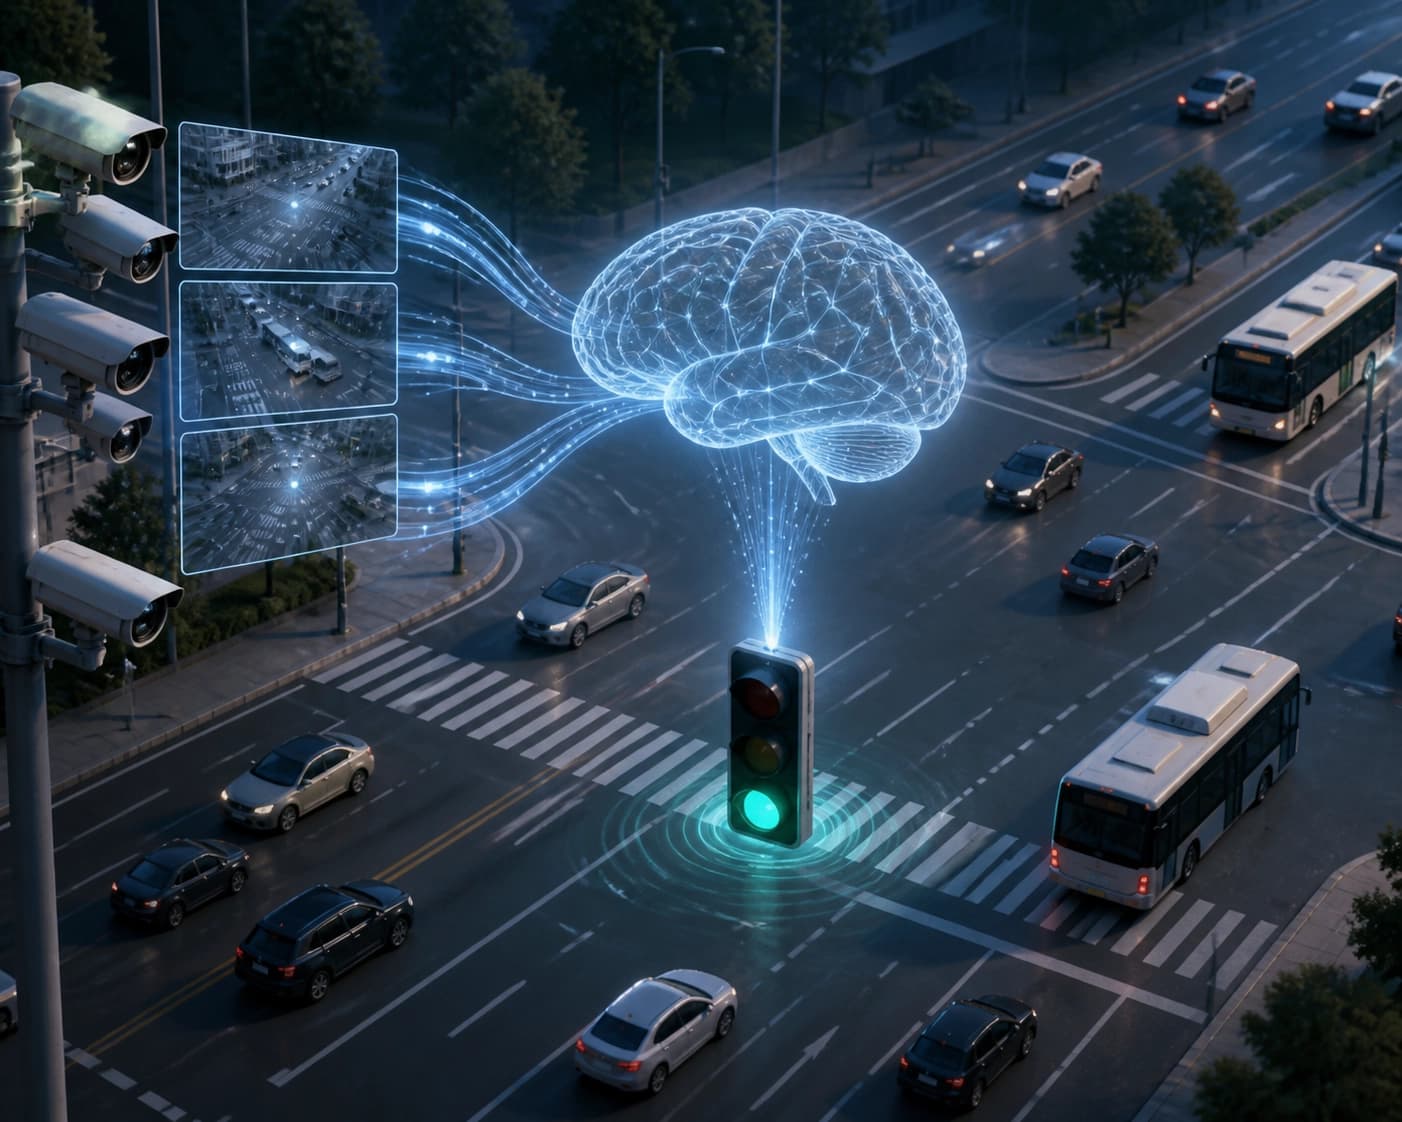
Что такое VLA-модель для управления светофорами
VLALight — vision-language-action модель для управления светофорами. Авторы: Pan Zhang, Siqi Lai, Kemu Dong, Hao Liu. Статья подана 29 сентября 2026 года. Это первая VLA-модель для сквозного управления светофорами по многовидовым видео с придорожных камер.
Модель напрямую преобразует визуальные наблюдения в согласованные действия светофоров. Она использует пространственно-временное рассуждение о нескольких целях. Также она топологически учитывает совместное восприятие на перекрёстках.
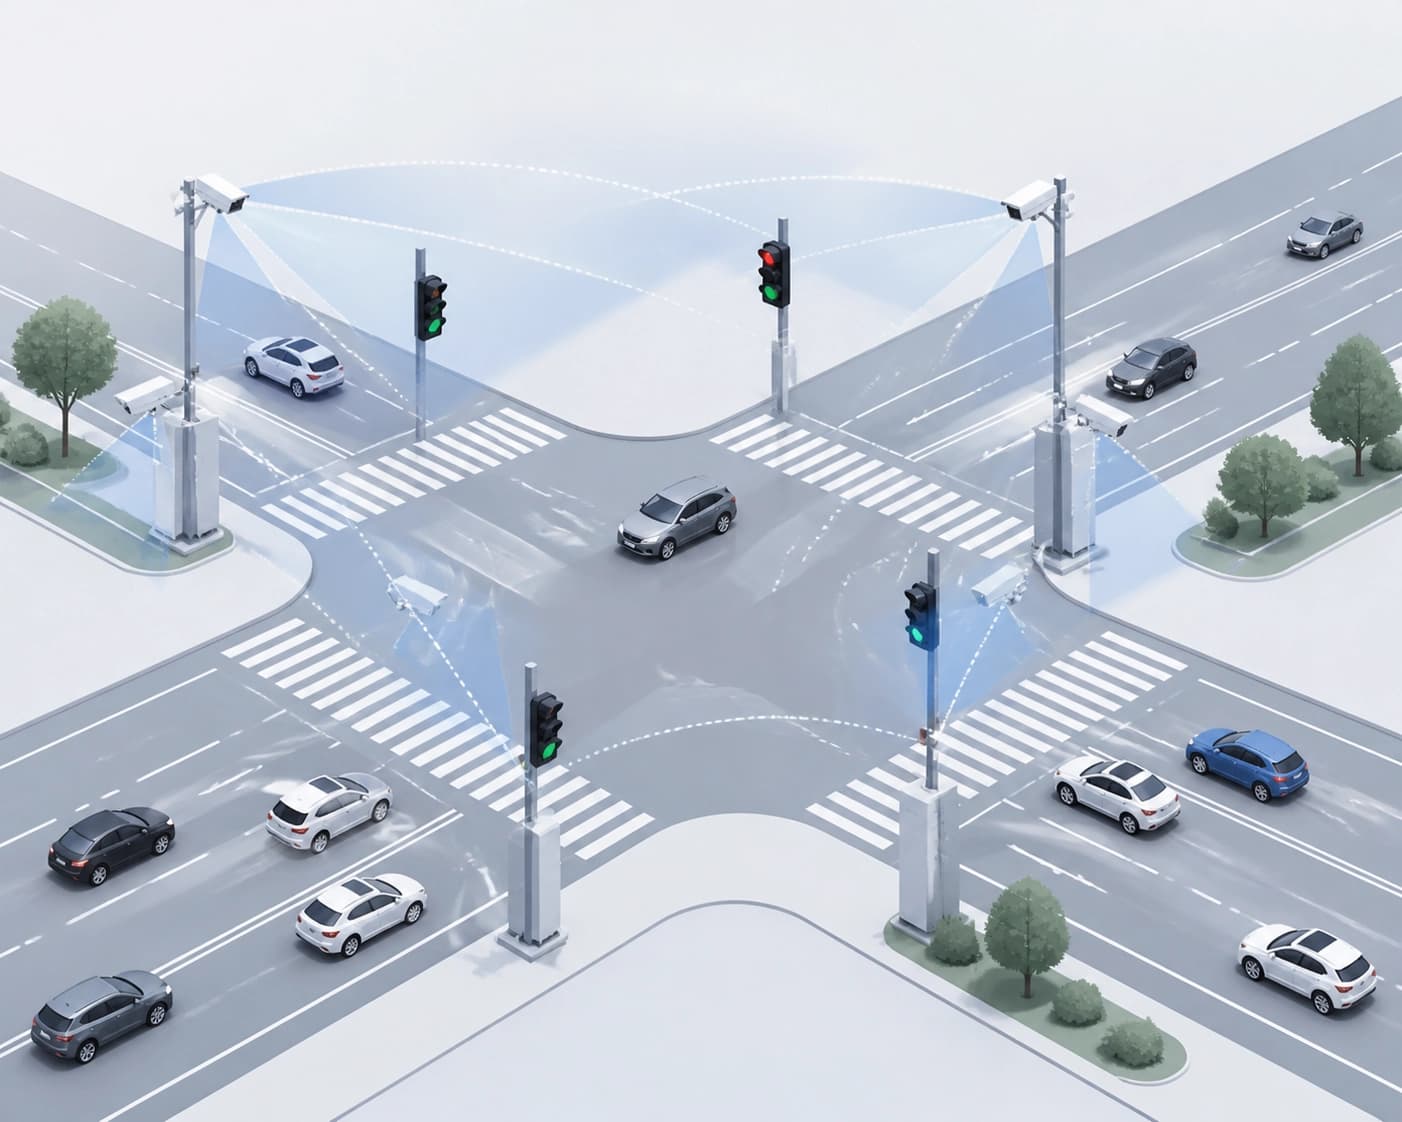
Ключевые свойства подхода:
- Сквозной вывод: визуальные наблюдения превращаются в действия светофоров.
- Многовидовое видео: данные поступают с придорожных камер.
- Пространственно-временное рассуждение: модель учитывает несколько целей.
- Топологический учёт: совместное восприятие на перекрёстках.
Критерий выбора: VLA-подход объединяет восприятие и управление в одной модели. Это отличает его от схем, где эти задачи разделены. Сквозная связь между видео и действиями — главный критерий.
Как обучают VLALight: два этапа
Обучение VLALight включает двухэтапную стратегию. Сначала применяется supervised cold-start. Он развивает визуальное понимание дорожной обстановки и принятие решений о сигналах. Затем включается cooperative agentic reinforcement learning.
Второй этап совместно оптимизирует локальное управление и эффективность транспортной сети в целом. Первый этап отвечает за понимание сцены и сигналов. Второй этап оптимизирует локальное управление и сеть.
| Этап | Задача | Что оптимизирует |
|---|---|---|
| Supervised cold-start | Визуальное понимание дорожной обстановки и принятие решений о сигналах | Начальные навыки модели |
| Cooperative agentic reinforcement learning | Совместная оптимизация | Локальное управление и эффективность сети |
Критерий выбора: смотреть, есть ли в подходе совместная оптимизация на уровне сети. Локальные решения без сетевого контекста ограничивают эффект. Двухэтапность разделяет обучение восприятию и настройку взаимодействия.
Адаптивные режимы рассуждения и стоимость инференса
VLALight использует адаптивные режимы быстрого и медленного рассуждения. Более глубокое рассуждение применяется только тогда, когда даёт достаточную пользу для управления. Модель использует сбалансированные mode-aware rollouts и relative advantage optimization. Модель учится находить компромисс между качеством решений и стоимостью инференса.
| Режим | Условие включения | Эффект |
|---|---|---|
| Быстрый | Глубокое рассуждение не даёт достаточной пользы | Меньшая стоимость инференса |
| Медленный | Глубокое рассуждение даёт достаточную пользу | Более качественные решения |
Критерий выбора: компромисс между качеством решений и стоимостью инференса. Режимы должны переключаться по пользе для управления. Постоянная работа на максимуме глубины увеличивает стоимость.
Что показали эксперименты
Эксперименты прошли на семи наборах данных о реальном транспортном потоке. Они охватывают три городские сети. VLALight превзошла базовые методы. Среди базовых — транспортные модели, обучение с подкреплением, LLM/VLM.
| Класс базовых методов | Роль в сравнении |
|---|---|
| Транспортные модели | Базовая линия |
| Обучение с подкреплением | Базовая линия |
| LLM/VLM | Базовая линия |
Абляционные исследования подтвердили эффективность совместного восприятия, оптимизации на уровне сети и адаптивного рассуждения. Авторы отмечают потенциал VLA-моделей для управления реальными физическими транспортными системами.
Критерий выбора: проверять состав базовых методов и наличие абляций. Эксперименты охватывают реальный поток и три городские сети. Вклад каждого компонента должен быть подтверждён отдельно.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Проверка coding-агентов в интерактивной XR-разработке: итоги GenXR-Bench
Опубликован GenXR-Bench — набор из 112 экспертных заданий для сквозной оценки coding-агентов в интерактивной XR-разработке: от доработки функций и исправления дефектов до создания приложений с проверкой поведения на потребительском оборудовании. У десяти протестированных моделей лучший результат составил 50,9% Pass@1; среди повторяющихся сбоев — обработка асинхронных событий датчиков, привязка объектов к реальному пространству и понимание взаимодействия в физическом контексте.
5 ноября 2026
Гибридная разметка изображений: автоматизация ускоряет обучение моделей компьютерного зрения
Статья описывает, как предварительная разметка алгоритмами сокращает ручную работу и повышает чистоту обучающих наборов, а также почему выборочная верификация человеком остаётся необходимой. Рассмотрены ограничения метода в трудных условиях съёмки и на редко встречающихся типах объектов.
5 ноября 2026
От скалярной награды к фронту Парето: LLM-синтез RTL с многокритериальным подкреплением
Предложен способ обучать языковую модель генерировать не одну схему, а набор RTL-кандидатов с разными компромиссами между площадью, задержкой и энергопотреблением; награда строится по вкладу варианта в гиперобъём фронта Парето. На RTLLM v2 относительный гиперобъём вырос на 13,3 п.п. относительно базовой версии без оптимизации PPA и на 14,4 п.п. относительно одноцелевого обучения с подкреплением.
5 ноября 2026