
От скалярной награды к фронту Парето: LLM-синтез RTL с многокритериальным подкреплением
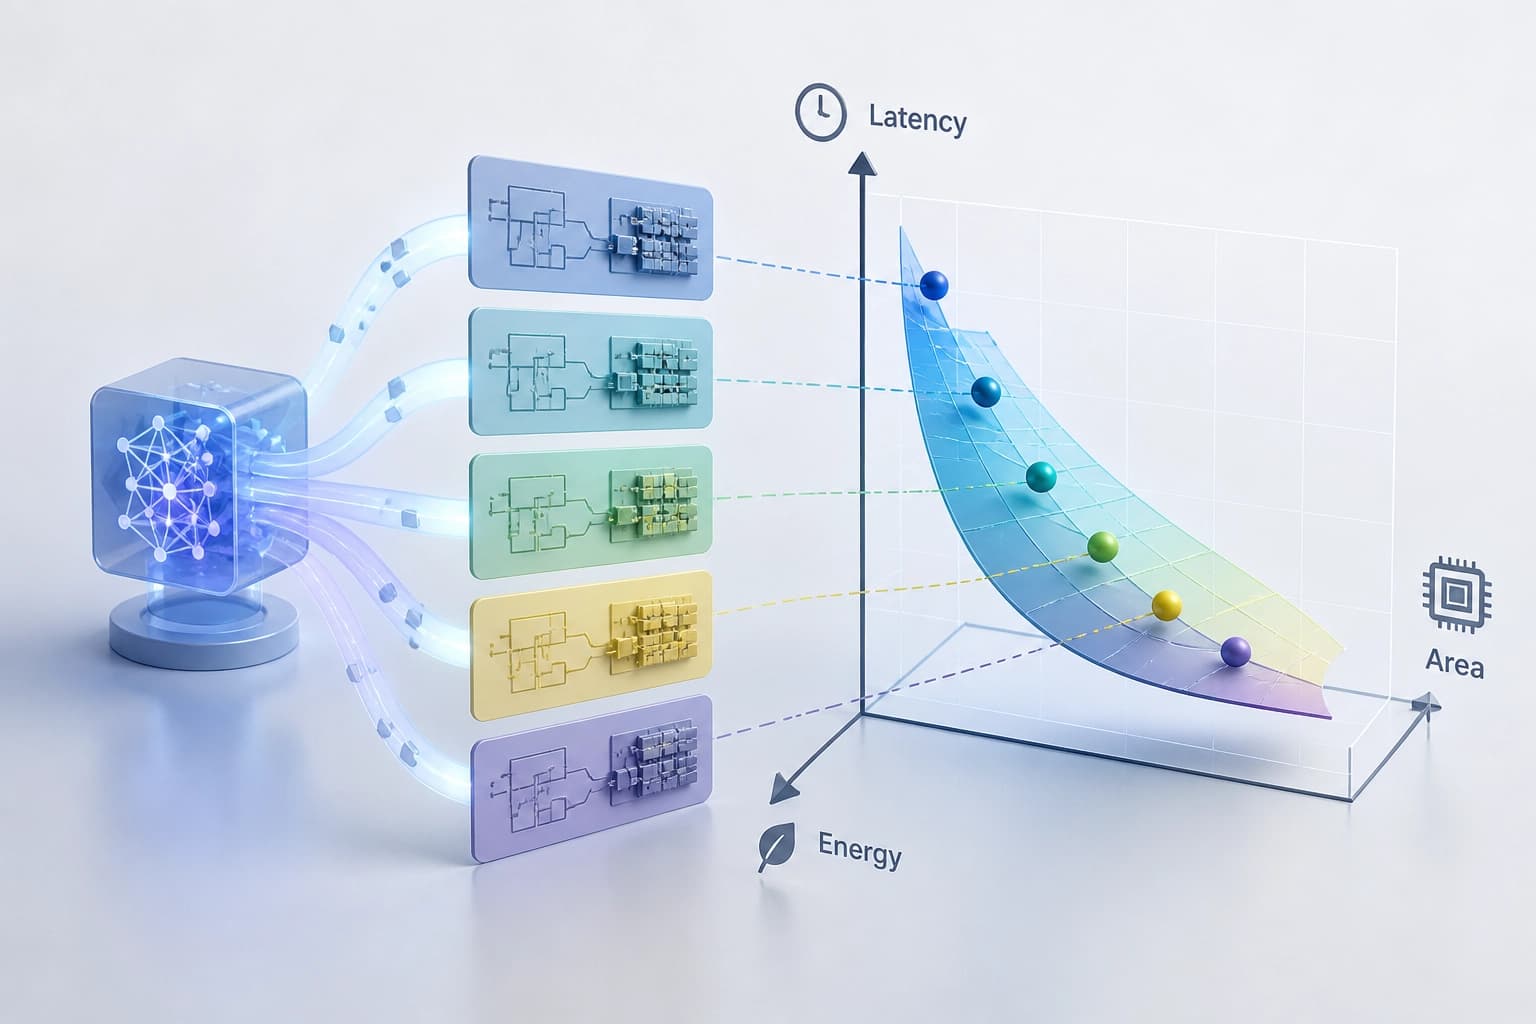
Предложен способ обучать языковую модель генерировать не одну схему, а набор RTL-кандидатов с разными компромиссами между площадью, задержкой и энергопотреблением; награда строится по вкладу варианта в гиперобъём фронта Парето. На RTLLM v2 относительный гиперобъём вырос на 13,3 п.п. относительно базовой версии без оптимизации PPA и на 14,4 п.п. относительно одноцелевого обучения с подкреплением.
Работа и статус
- Название: Pareto-Optimal RTL Code Generation via Multi-Objective Reinforcement Learning with Large Language Models.
- Авторы: Koki Takeshita, Kenji Uebayashi, Hikaru Tomonari, Masaya Tsunokake, Koichiro Yawata, Tatsuya Sasaki, Yusuke Ohtsubo, Kota Dohi, Yasuhiro Sogawa.
- Дата подачи: 16 октября 2026 года.
- Статус: в комментариях указано, что работа принята на COLM 2026.
Препринт доступен как arXiv:2610.26904. Работа относится к генерации RTL с помощью больших языковых моделей. Метод обучает модель выдавать не одну схему, а набор кандидатов. Этот набор оценивают в пространстве PPA.
Вывод: работа принята на COLM 2026 и предлагает многокритериальный подход к LLM-синтезу RTL. Для выбора подхода важен сам сдвиг цели — с одной схемы на набор.
Проблема скалярной награды
Существующие подходы объединяют несколько целей в одну скалярную награду. Из-за этого сложно одновременно получать разнообразные решения, оптимальные по Парето. Разные компромиссы между низким энергопотреблением, малой задержкой и небольшой площадью становятся труднодостижимыми. Скалярная награда фиксирует важность целей до генерации.
Относительная важность целей зависит от требований продукта и ограничений проекта. Заранее сведённая награда не меняется вместе с этими требованиями. Поэтому нужен набор кандидатов с разными компромиссами.
| Подход | Что оптимизирует | Когда выбирается компромисс |
|---|---|---|
| Скалярная награда | Одну схему по сумме целей | До генерации |
| Многокритериальный подход | Набор схем на фронте Парето | После генерации |
Вывод: скалярная награда фиксирует компромисс до генерации. Многокритериальная постановка переносит выбор на этап после генерации.
Что оптимизирует метод
Метод оптимизирует качество и разнообразие всего набора схем. Набор появляется при нескольких генерациях. Оценка идёт в пространстве целей PPA: Power, Performance, Area. Метод не нацелен на качество одной схемы.
Цели PPA связаны компромиссами. Разные схемы дают разные сочетания низкого энергопотребления, малой задержки и небольшой площади. Поэтому метод обучает модель покрывать разные точки фронта Парето. Проектировщик получает несколько кандидатов.
Вывод: метод нацелен на покрытие фронта, а не на один лучший ответ.
Два элемента метода
Конвейер обучения на основе генераций
Конвейер преобразует улучшение покрытия всего множества решений Парето в последовательную задачу генерации схем. Обучение идёт по шагам. Задача генерации получает последовательную структуру.
Награда на основе Hypervolume Contribution
Функция награды HVC измеряет вклад сгенерированной схемы в фронт Парето. Награда отражает не абсолютное качество отдельной схемы, а прирост покрытия. HVC связывает обучение с покрытием фронта.
Вывод: конвейер задаёт последовательность, HVC даёт сигнал за вклад в покрытие.
Результаты на RTLLM v2
Оценка на benchmark RTLLM v2 показала прирост относительного Hypervolume. Относительно базового варианта без PPA-оптимизации прирост составил +13,3 п.п. Относительно одноцелевого RL-метода — +14,4 п.п. Авторы также сообщают о превосходстве по разнообразию схем.
| Сравнение | Прирост относительного Hypervolume |
|---|---|
| Базовый вариант без PPA-оптимизации | +13,3 п.п. |
| Одноцелевой RL-метод | +14,4 п.п. |
Вывод: на RTLLM v2 метод улучшает покрытие фронта и разнообразие. Цифры относятся к относительному Hypervolume, а не к абсолютному качеству каждой схемы.
Практический критерий выбора
Подход выбирают по моменту фиксации компромисса. Скалярная награда требует задать важность PPA до генерации. Многокритериальный подход переносит выбор на этап после генерации. Он даёт набор кандидатов с разными компромиссами.
Оценка метода ограничена benchmark RTLLM v2. Для другого потока проектирования нужна собственная проверка. Переносить цифры прироста на другие условия без проверки нельзя.
Вывод: если требования к PPA меняются от продукта к проекту, многокритериальный подход соответствует задаче выбора после генерации. Если важность целей известна и зафиксирована, скалярная награда соответствует случаю с заранее заданным компромиссом.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Проверка coding-агентов в интерактивной XR-разработке: итоги GenXR-Bench
Опубликован GenXR-Bench — набор из 112 экспертных заданий для сквозной оценки coding-агентов в интерактивной XR-разработке: от доработки функций и исправления дефектов до создания приложений с проверкой поведения на потребительском оборудовании. У десяти протестированных моделей лучший результат составил 50,9% Pass@1; среди повторяющихся сбоев — обработка асинхронных событий датчиков, привязка объектов к реальному пространству и понимание взаимодействия в физическом контексте.
5 ноября 2026
Медицинские LLM узнают о пересмотре рекомендаций, но часто отвечают по прежним правилам
Исследование ChronoEvo на 1709 изменениях клинических рекомендаций показывает: в основной модели 90,8% ответов фиксировали новшество, однако полностью применяли его только 58,5%, а разрыв в 32,3 п.п. сохранялся у 14 моделей. Даже усиление заметности обновлений не дало значимого прироста в полном переносе новых правил в клиническую рекомендацию.
4 ноября 2026
Модель мира для агентов на закрытых LLM: коррекция в точках риска
Предложен PAWM — внешний предиктор, который не дублирует пошаговое наблюдение, а включается при вероятном сбое и уводит агента от ошибочного действия. После SFT на синтетических сценариях и GRPO-кообучения метод дал прирост 24,3% в ScienceWorld и 7,7% в WebArena-Lite для Claude Sonnet 4.5.
4 ноября 2026