Что именно должен планировать ИИ
Городское планирование здесь — задача пространственной оптимизации: нужно выбирать допустимые действия из большого пространства кандидатов.
Практические цели включают стоимость и качество обслуживания.
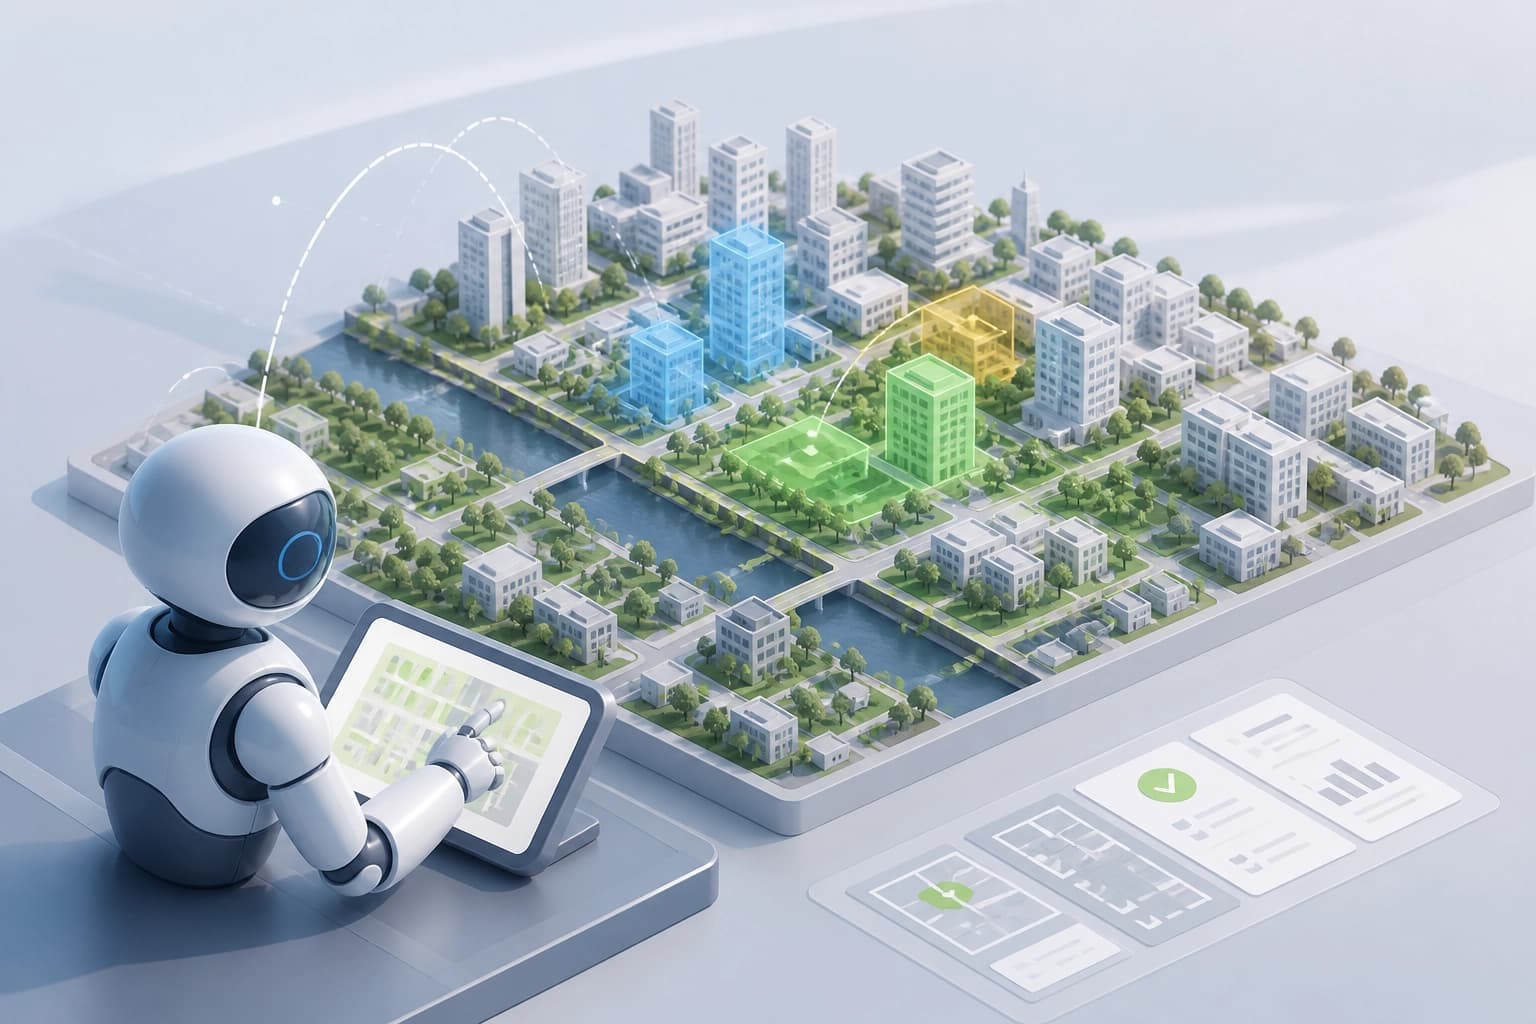
Работа CityPlanner описывает sandbox-агента для исполняемого городского планирования.
Проверяемый сценарий связывает план с оценкой: система запускает оценщик и получает исполняемую обратную связь.
В такой постановке важны допустимые действия, практическая цель и возможность оценить результат.
Критерий проверяемости — среда может оценить созданный план.
Как устроена среда выполнения
В UrbanSandbox агент работает в единой файловой среде.
Он изучает файлы задачи, создаёт план, запускает оценщики и пересматривает решение по обратной связи.
Цикл объединяет работу с данными задачи и проверку плана.
Основные действия агента:
- изучить файлы задачи;
- создать план;
- запустить оценщик;
- пересмотреть решение на основе исполняемой обратной связи.
Среда подходит для сценария, если агент может пройти в ней весь цикл — от изучения задачи до пересмотра плана.
Как разделить обучение
Авторы предлагают atomic-task reinforcement learning: длинные траектории в sandbox делятся на две задачи.
Такое разделение упрощает обучение, отделяя первоначальное построение плана от его доработки.
Каждая задача отвечает за отдельный этап работы с планом.
- BuildPlan — первоначально построить план.
- ImprovePlan — доработать план на основе обратной связи.
Такое разделение уместно, когда обучение объединяет создание плана и его последующую корректировку по результатам оценки.
Что показывают эксперименты
На реальном бенчмарке CityPlanner стабильно превзошёл три группы сравнения:
| С чем сравнивали | Результат |
|---|---|
| Эвристические методы | Агент показал лучший результат |
| Task-specific RL | Агент показал лучший результат |
| Базовые модели LLM-агентов общего назначения | Агент показал лучший результат |
Абляционные исследования подтвердили вклад UrbanSandbox, atomic-task RL и iterative deployment.
Авторы сообщают о выпуске кода и набора данных.
Работа подана 9 сентября 2026 года и находится на рассмотрении EMNLP.
Практический вывод ограничен результатами этого бенчмарка: они поддерживают предложенную схему, но не устанавливают её преимущество для любой городской задачи.
Источник: arXiv:2609.09578.