Почему LLM ошибаются при неполных наблюдениях
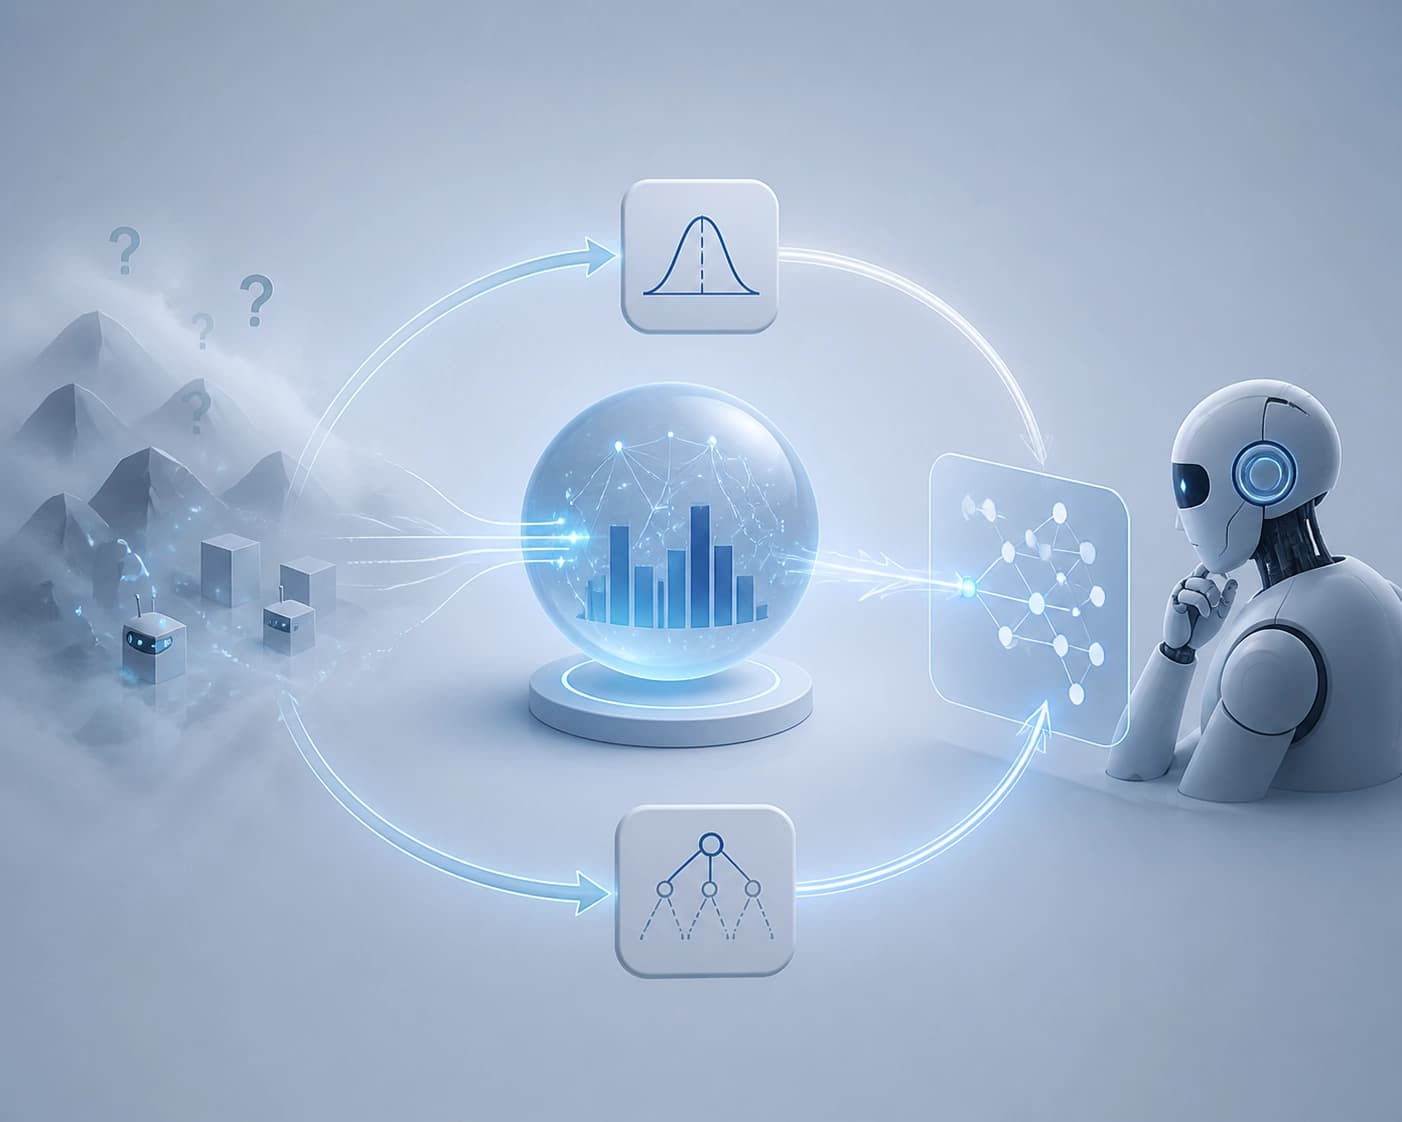
Ошибки LLM-агентов в частично наблюдаемых средах авторы связывают с отсутствием явного распределения убеждений о скрытом состоянии. Обычно агент действует как политика, обусловленная историей действий и наблюдений.
В статье описаны три характерные ошибки:
- преждевременное решение при неоднозначной обратной связи;
- смещение к неверной гипотезе после информативного наблюдения;
- дрейф политики по мере роста истории.
Проблема не только в качестве ответа на отдельный запрос. Агенту не хватает явного представления о том, что он считает возможным скрытым состоянием.
Как устроен внешний байесовский контур
Belief-State Engine (BSE) — модуль вывода вне LLM. Он поддерживает апостериорное распределение Байеса по скрытым состояниям заданной модели POMDP — частично наблюдаемого марковского процесса принятия решений.
На каждом шаге контур работает так:
- BSE обновляет распределение убеждений о скрытом состоянии.
- LLM получает только это распределение.
- Исходный журнал действий и наблюдений остаётся недоступен для LLM.
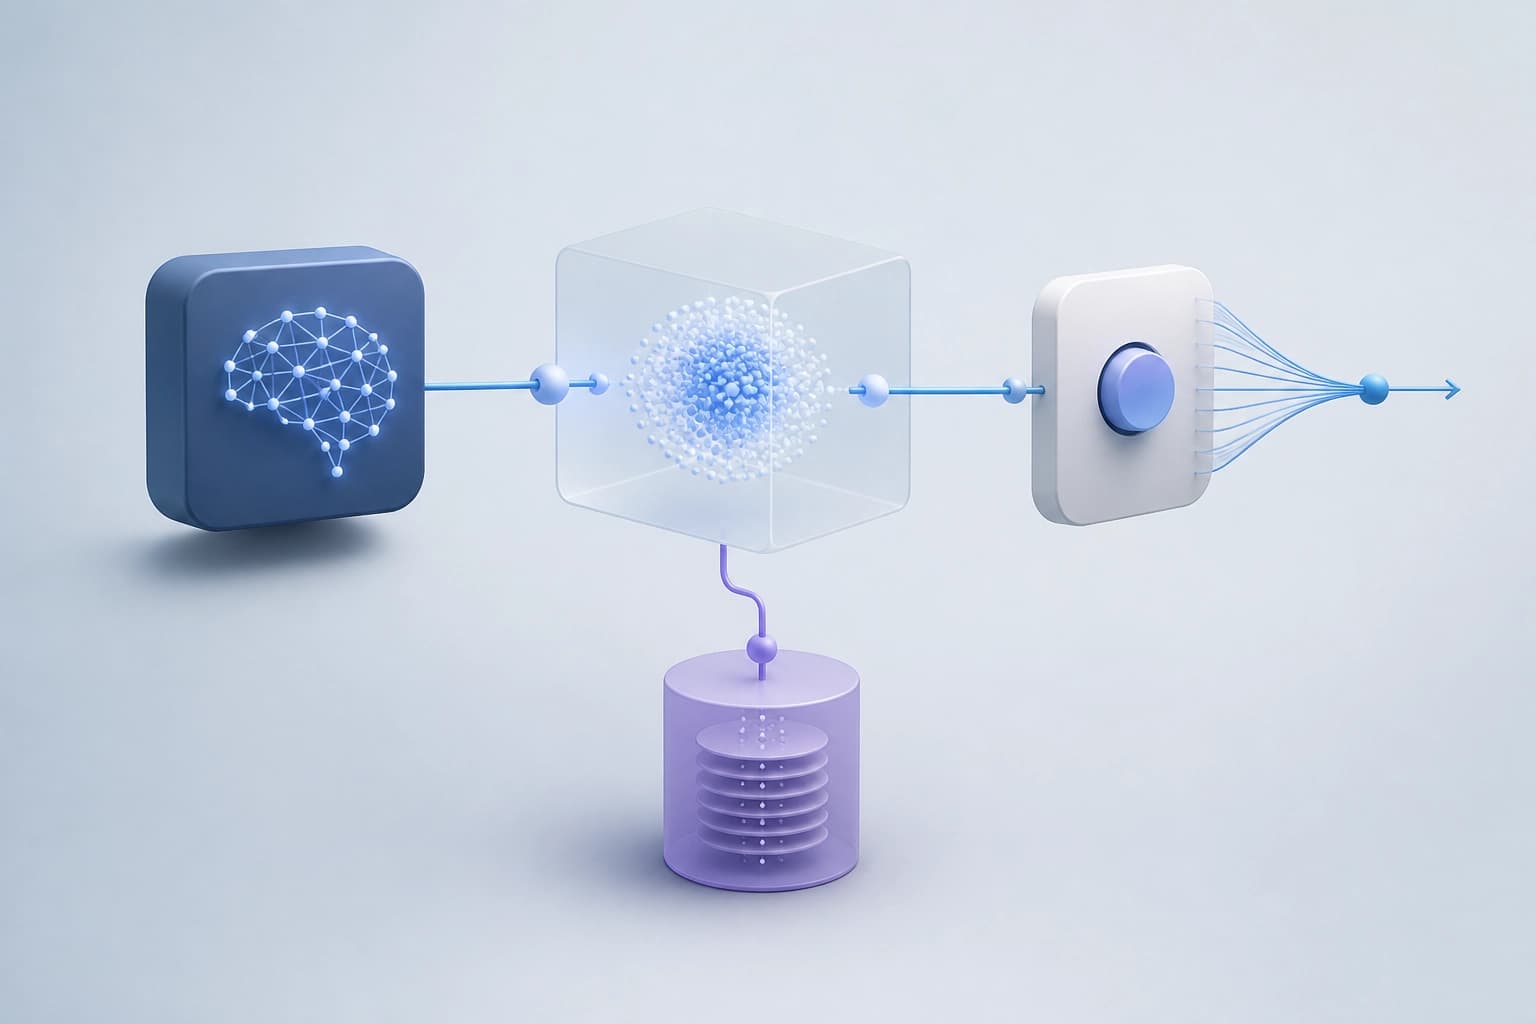
Такой подход отделяет учёт неопределённости от языковой модели. Ключевое условие архитектуры — LLM не получает исходную историю.
Какие гарантии зависят от архитектуры
Авторы задают минимальную спецификацию из четырёх аксиом для согласованного с убеждениями внутреннего состояния. Содержание аксиом здесь не раскрывается.
Авторы доказывают, что связка LLM и BSE образует корректную марковскую политику на belief MDP, индуцированном исходной POMDP. При условии, что LLM никогда не получает доступ к исходной истории, связка наследует гарантии оптимальности Беллмана классической теории POMDP.
Практический критерий: эти гарантии относятся к описанной связке и зависят от ограничения доступа к истории. Их нельзя отделять от условий архитектуры.
Что показала оценка
Архитектуру проверяли на Tiger POMDP и задаче red-team attack-graph. Сравнение включало шесть базовых методов.
| Базовый метод | Результат BSE в обеих областях |
|---|---|
| Reactive LLM | Более высокий task return, лучшая калибровка убеждений и большая согласованность решений |
| Chain-of-Thought | Более высокий task return, лучшая калибровка убеждений и большая согласованность решений |
| ReAct | Более высокий task return, лучшая калибровка убеждений и большая согласованность решений |
| Natural-language belief tracker | Более высокий task return, лучшая калибровка убеждений и большая согласованность решений |
| QMDP | Более высокий task return, лучшая калибровка убеждений и большая согласованность решений |
| POMCP | Более высокий task return, лучшая калибровка убеждений и большая согласованность решений |
В аннотации также заявлено, что эффект не специфичен для одной модели. Десять целевых абляций предназначены для выделения вклада отдельных архитектурных решений.
Когда подход уместно рассматривать
BSE поддерживает распределение по скрытым состояниям заданной POMDP. Поэтому описание задачи в рамках такой модели — центральный критерий применимости подхода.
Оценка в статье охватывает две указанные области. Она не подтверждает перенос результатов на любые задачи с неполными данными.
Что доступно для проверки
К препринту Belief-State Engine: Augmenting LLMs for Principled Planning Under Partial Observability приложены код, спецификации сред, шаблоны промптов и журналы seed.
Статью Arnab Chattopadhayay и Debdipta Halder подали на arXiv 9 сентября 2026 года. Практический вывод следует оценивать с учётом описанных сред, сравнений и условий доступа LLM к истории.