
Архитектура поддержки на миллионах диалогов: разделение поиска, действий и генерации
На примере сервиса бронирования жилья авторы разбирают переход от единой модели к ограниченному оркестратору типизированных операций и генератору, опирающемуся на проверенный контекст; эффекты архитектуры оцениваются отдельно от сопутствующих изменений. В повторно воспроизведённых диалогах выросла точность выбора брони, исчезли ошибки в структурированных действиях и сократились эскалации; оптимизация также уменьшила задержку и затраты на обслуживание модели, тогда как объём передачи диалогов операторам в продакшене существенно не изменился.
Масштаб и границы оценки
Система поддержки крупного маркетплейса жилья обрабатывает миллионы диалогов в месяц. Она работает на 11 языках, а указанный P90 составляет 10 секунд. Эти показатели описывают масштаб системы, но не показывают эффект отдельного архитектурного решения.
| Параметр | Значение |
|---|---|
| Объём | Миллионы диалогов в месяц |
| Языки | 11 |
| P90 | 10 секунд |
При миграции также изменились prompts, alignment и serving. Поэтому авторы относят к архитектуре только эффекты, измеренные на одинаково воспроизведённых диалогах.
Критерий оценки: сравнивать архитектуры на идентичных входных диалогах, а не приписывать им все изменения после миграции.
Как разделены поиск, действия и генерация
Dynamic Response (DR) заменяет смешанного ответчика Qwen3-235B-A22B ограниченным ReAct-оркестратором с типизированными инструментами и меньшим генератором. Генератор строит ответ на основе контекстного контракта, проверенного backend-системой.
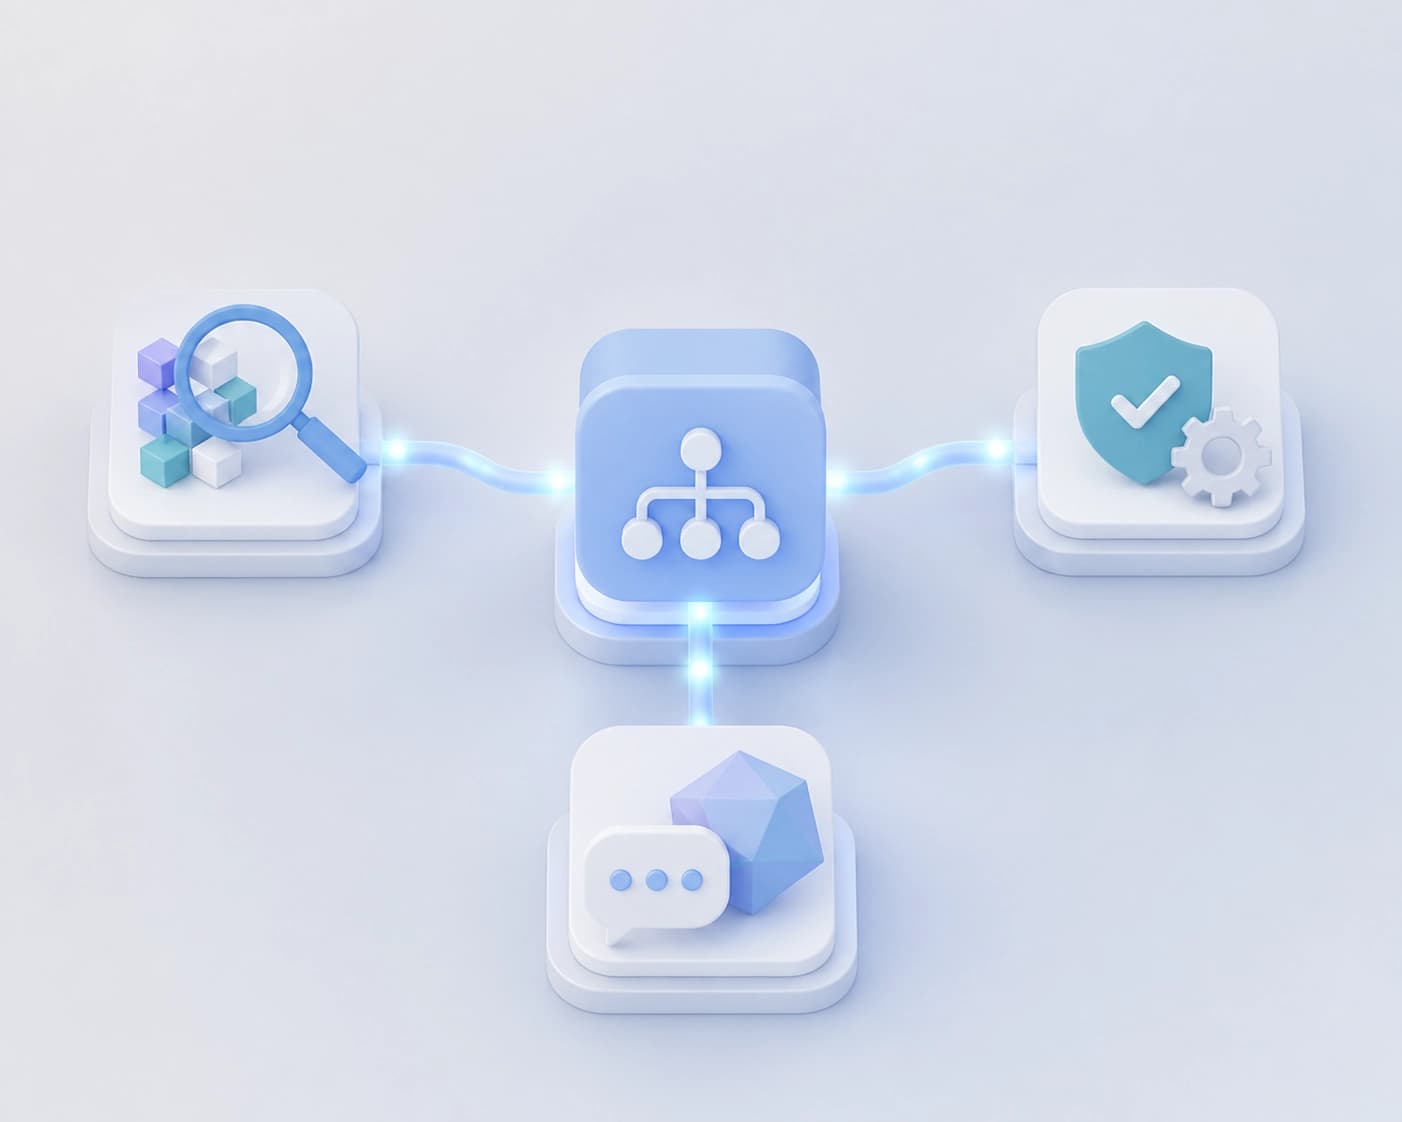
| Часть системы | Роль |
|---|---|
| Поиск | Типизированный выбор сущности, включая выбор бронирования |
| Действия | Типизированные идентификаторы действий и проверка принадлежности |
| Генерация | Ответ по проверенному backend-системой контекстному контракту |
| Оркестрация | Ограниченный ReAct-оркестратор поверх типизированных инструментов |
Такое разделение отделяет выбор сущности и действия от формулировки ответа. Критерий выбора: архитектура подходит, когда системе нужны проверяемые операции, а не только единый генератор ответа.
Что изменилось в выборе сущностей и действий
Типизированный выбор сущности сместил селектор бронирования к приоритету точности. Точность выросла, а полнота снизилась. Проверка принадлежности типизированных ID устранила наблюдавшиеся ошибки в структурированных действиях.
| Метрика | До | После |
|---|---|---|
| Точность выбора бронирования | 8,3% | 89,1% |
| Полнота выбора бронирования | 75,2% | 67,3% |
| Наблюдавшиеся галлюцинации структурированных действий | 2,14% | 0,0% |
Результаты показывают компромисс между точностью и полнотой выбора. Критерий выбора: такой режим уместен, когда важнее избегать ошибочного выбора, чем сохранять прежний уровень полноты.
Как оценивать эскалации и самообслуживание
Низкоуровневый A/B-тест воспроизвёл на replay снижение эскалаций. При этом объём передач оператору в production оставался примерно стабильным.
| Показатель | До | После |
|---|---|---|
| Ответы с жёсткой эскалацией | 5,60% | 3,08% |
| Ответы с мягкой эскалацией | 9,56% | 2,49% |
| Self-solve | — | Направленный сдвиг: +5,1 п. п.; 95% CI: от −2 до +12 |
Снижение эскалаций не сопровождалось сопоставимым снижением объёма передач оператору. Self-solve авторы характеризуют как направленный результат, а не как однозначно установленный рост.
Критерий оценки: отдельно отслеживать ответы с эскалацией, реальные передачи оператору и self-solve.
Что дала оптимизация serving
Оптимизации serving снизили P90 задержки оркестратора с 3,87 до 2,24 секунды. При этом GPU footprint уменьшился примерно на треть.
| Показатель | Изменение |
|---|---|
| P90 задержки оркестратора | 3,87 → 2,24 секунды |
| GPU footprint | Снижение примерно на треть |
| Оценочная годовая стоимость serving моделей при self-hosting | Снижение более чем на порядок |
Эти показатели относятся к serving, а не к качеству выбора сущностей или действий. Критерий оценки: рассматривать задержку, вычислительный footprint и стоимость serving отдельно от метрик ответов.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Проверка галлюцинаций LLM через SQL-представление источников без дообучения
Работа проверяет, способна ли LLM задействовать базовый символический навык — сборку SQL-базы по исходным документам — для привязки к источнику без учителя при детекции галлюцинаций. На RAGTruth и DiaHalu такой нейросимволический конвейер оказывается точнее прямого предсказания и сопоставим с передовыми методами, не требуя тонкой настройки под предметную область.
9 ноября 2026
MathAdv: что скрывает итоговая точность машинных доказательств
Диагностический набор задач по 13 университетским и аспирантским разделам математики оценивает системы машинного доказательства в Lean 4 не только по итоговому результату, но и по владению предметом, качеству неформальных рассуждений и устойчивости к переформулировкам условий. Покомпонентный разбор показывает, что перевод задачи в формальный вид по-прежнему остаётся главным препятствием, а успех сильно зависит от области математики и от способа постановки задачи.
9 ноября 2026
AffordanceWAM: аффордансы как посредник между прогнозом сцены и управлением манипулятором
Работа описывает генеративную модель, которая одновременно прогнозирует будущие RGB-наблюдения, скалярные поля и тепловые карты аффордансов и непрерывные команды робота, используя человеческие видео для расширения разнообразия взаимодействий без аннотаций действий и ретаргетинга. На RoboCasa, CALVIN ABC→D и реальных задачах подход даёт устойчивый выигрыш относительно базовых линий только на RGB и только на роботных данных.
9 ноября 2026