Короткая цепочка рассуждений — не всегда лучшая
Большие модели, обученные «думать вслух», выигрывают за счёт длинных цепочек рассуждений. Чем сложнее задача, тем больше промежуточных шагов модель выписывает, прежде чем дать ответ. Один из механизмов, который принято считать ключевым для такого качества, — саморефлексия: способность оглянуться на уже сделанные шаги, заметить ошибку и переписать ход решения.
Проблема в том, что за эту способность приходится платить. Каждый акт пересмотра — это дополнительные токены на инференсе, а значит, деньги, время и вычислительные ресурсы. При этом до недавнего времени никто толком не объяснял, чем именно управляется решение модели «остановиться и перепроверить себя». Саморефлексия была чем-то вроде чёрного ящика внутри чёрного ящика: известно, что она работает, непонятно — как.
Работа Ge Yan, Chung-En Sun, Linbo Liu и Tsui-Wei Weng (arXiv:2512.13979, принята на COLM 2026) заходит к вопросу с неожиданной стороны — не через промпты и не через дообучение, а через латентные представления модели.
Направление рефлексии внутри модели
Что искали и что нашли
Исследователи применили к саморефлексии аппарат representation engineering — направления, которое изучает не тексты на выходе модели, а её внутренние активации. Логика простая: если модель «решает» рефлексировать, это решение где-то в её представлениях отражено. Значит, его можно найти, описать и — главное — использовать.
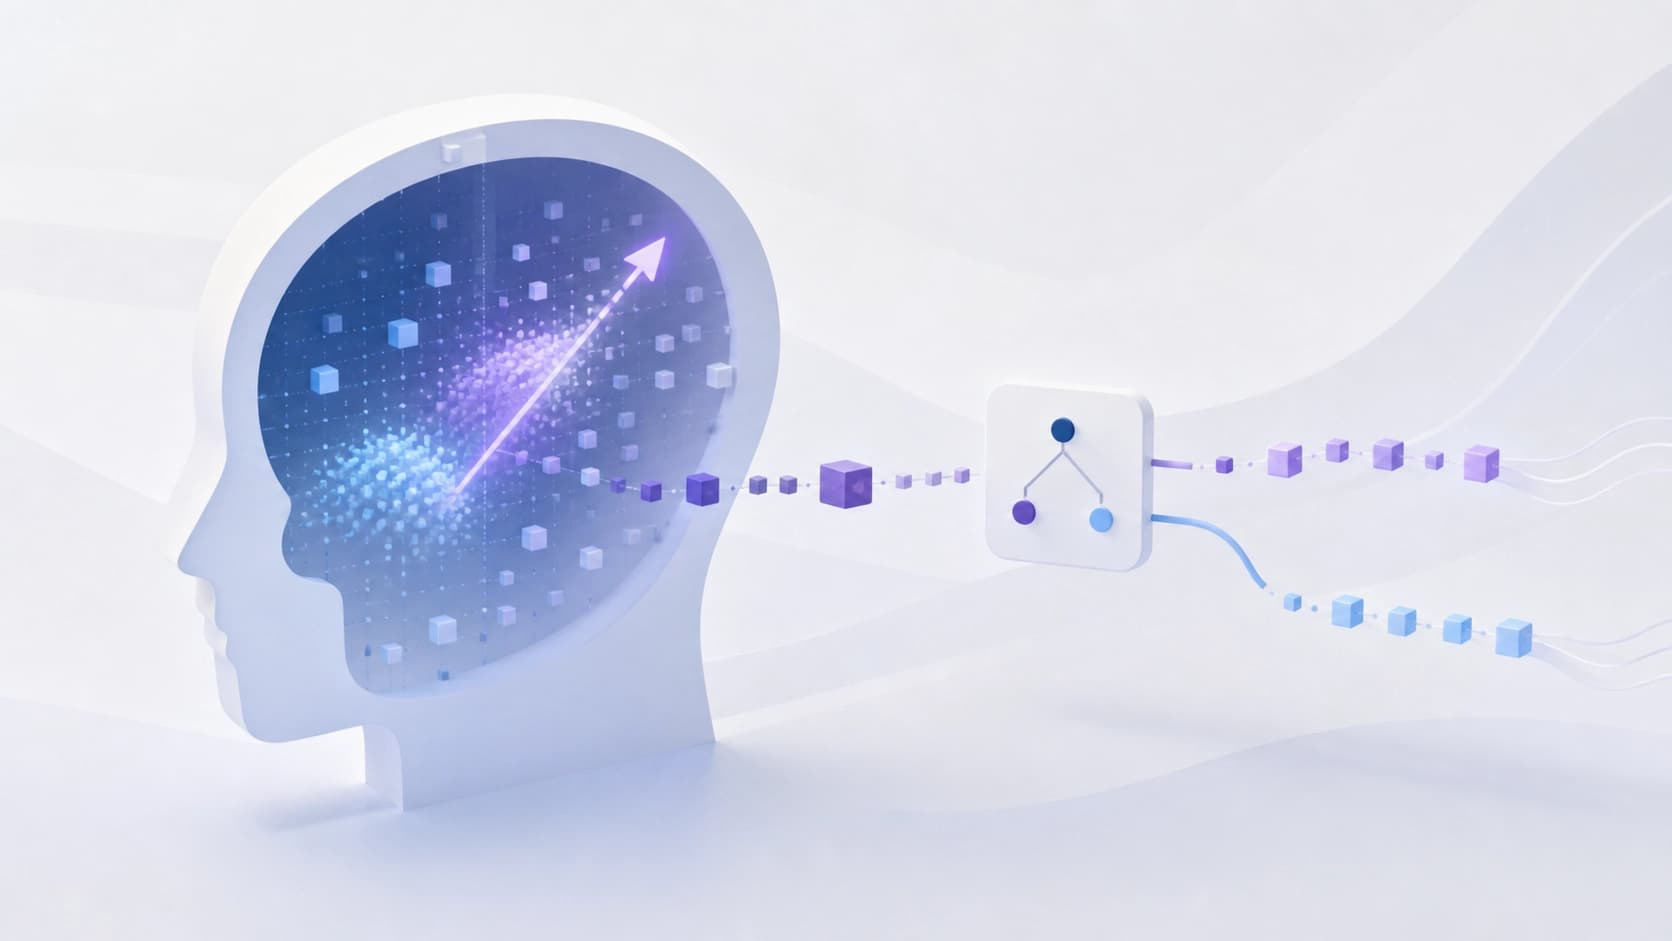
Так и оказалось. В латентном пространстве обнаружилось выделенное направление, вдоль которого шаги с рефлексией отделяются от шагов без неё. По сути, это ось «перепроверять / не перепроверять», и положение точки на этой оси устойчиво различает два типа шагов.
Рефлексией правит неуверенность
Самое интересное наблюдение из статьи: величина активации вдоль найденного направления хорошо предсказывает, правильный ли в итоге получится ответ. Иными словами, рефлексия включается не случайно и не по расписанию — она привязана к внутренней неопределённости модели. Когда модель «чувствует», что скользко, она тормозит и пересматривает; когда всё ясно, идёт дальше.
Это важный сдвиг в картине мира. Рефлексия перестаёт быть отдельной способностью, которую нужно развивать, и оказывается скорее сигналом — индикатором того, что модель сама сомневается в своём шаге.
Как устроен ReflCtrl
Если решение о рефлексии живёт в активациях, на него можно влиять напрямую — вмешиваясь в представления, а не переписывая промпт. На этом строится ReflCtrl: фреймворк, который управляет саморефлексией через стиринг — сдвиг активаций вдоль найденного направления.
Ключевая деталь — когда именно вмешиваться
Наивный подход очевиден: добавлять нужный сдвиг на каждом генерируемом токене. Он и был первым, что приходит в голову, — и именно он плохо работает. Постоянное давление на представления размывает качество генерации: модель теряет связность, потому что вмешательство идёт и там, где оно бессмысленно.
Авторы предлагают пошаговый (step-level) вариант. Вмешательство применяется ровно один раз — в самом начале каждого нового шага рассуждения. Дальше модель генерирует токены этого шага свободно, без помех. Получается тонкая настройка: частота рефлексии меняется, а сам ход мысли внутри шага остаётся нетронутым.
Именно это сочетание — редкое, точечное вмешательство вместо непрерывного — и даёт основной выигрыш.
Что показали эксперименты
Тесты проводились на бенчмарках математического и общего рассуждения. Результаты складываются в довольно неудобный для индустрии вывод: рефлексия часто избыточна.
- Число токенов рассуждения удаётся срезать вплоть до 43,2% от исходного объёма — при сохранении точности.
- Особенно заметен эффект на более сильных моделях: чем лучше модель, тем чаще она перепроверяет себя без нужды.
- Пошаговый стиринг ощутимо обходит традиционный потактный при сопоставимых бюджетах токенов.
Второй и третий пункты связаны. Сильная модель увереннее в своих шагах, поэтому её рефлексия чаще оказывается холостым ходом — а потактный стиринг как раз и страдает от того, что не умеет вовремя остановиться.
Почему это важно за пределами лаборатории
Экономика рассуждения — это не абстракция. Длинные цепочки раздувают счета за инференс, увеличивают задержку и ограничивают, сколько запросов вообще можно пропустить через имеющееся железо. Если почти половину «размышлений» можно убрать без потери качества, это прямая экономия на масштабе.
Есть и менее очевидный слой. Работа показывает, что поведение модели можно настраивать на уровне представлений — мягче и точнее, чем промптами, и дешевле, чем дообучением. Управляемость становится отдельным инженерным измерением: не «что написать в инструкции», а «куда сдвинуть активацию и в какой момент».
Наконец, это вклад в интерпретируемость. Мы всё лучше понимаем, что именно происходит внутри, когда модель останавливается и говорит себе «давай пересмотрю».
Открытые вопросы
Границы применимости пока очерчены не до конца. Стиринг вдоль одного направления — инструмент узкий: он хорошо ловит найденную ось рефлексии, но что делать с другими видами самокоррекции — непонятно. Остаётся и вопрос, насколько найденное направление переносимо между архитектурами: у каждой модели свои представления, и не факт, что вектор, работающий для одной, пригодится для другой.
Не до конца ясен и компромисс между экономией и надёжностью на задачах, где ошибка стоит дорого. Срезать 43,2% токенов при сохранении средней точности — сильный результат, но средняя точность не равна отсутствию редких катастрофических провалов. Искать, как отличить «лишнюю» рефлексию от той единственной, которая спасает ответ, — вероятно, следующая задача в этой линии исследований.