Кролик гонится за тигром: тест, который обнажил слепое пятно
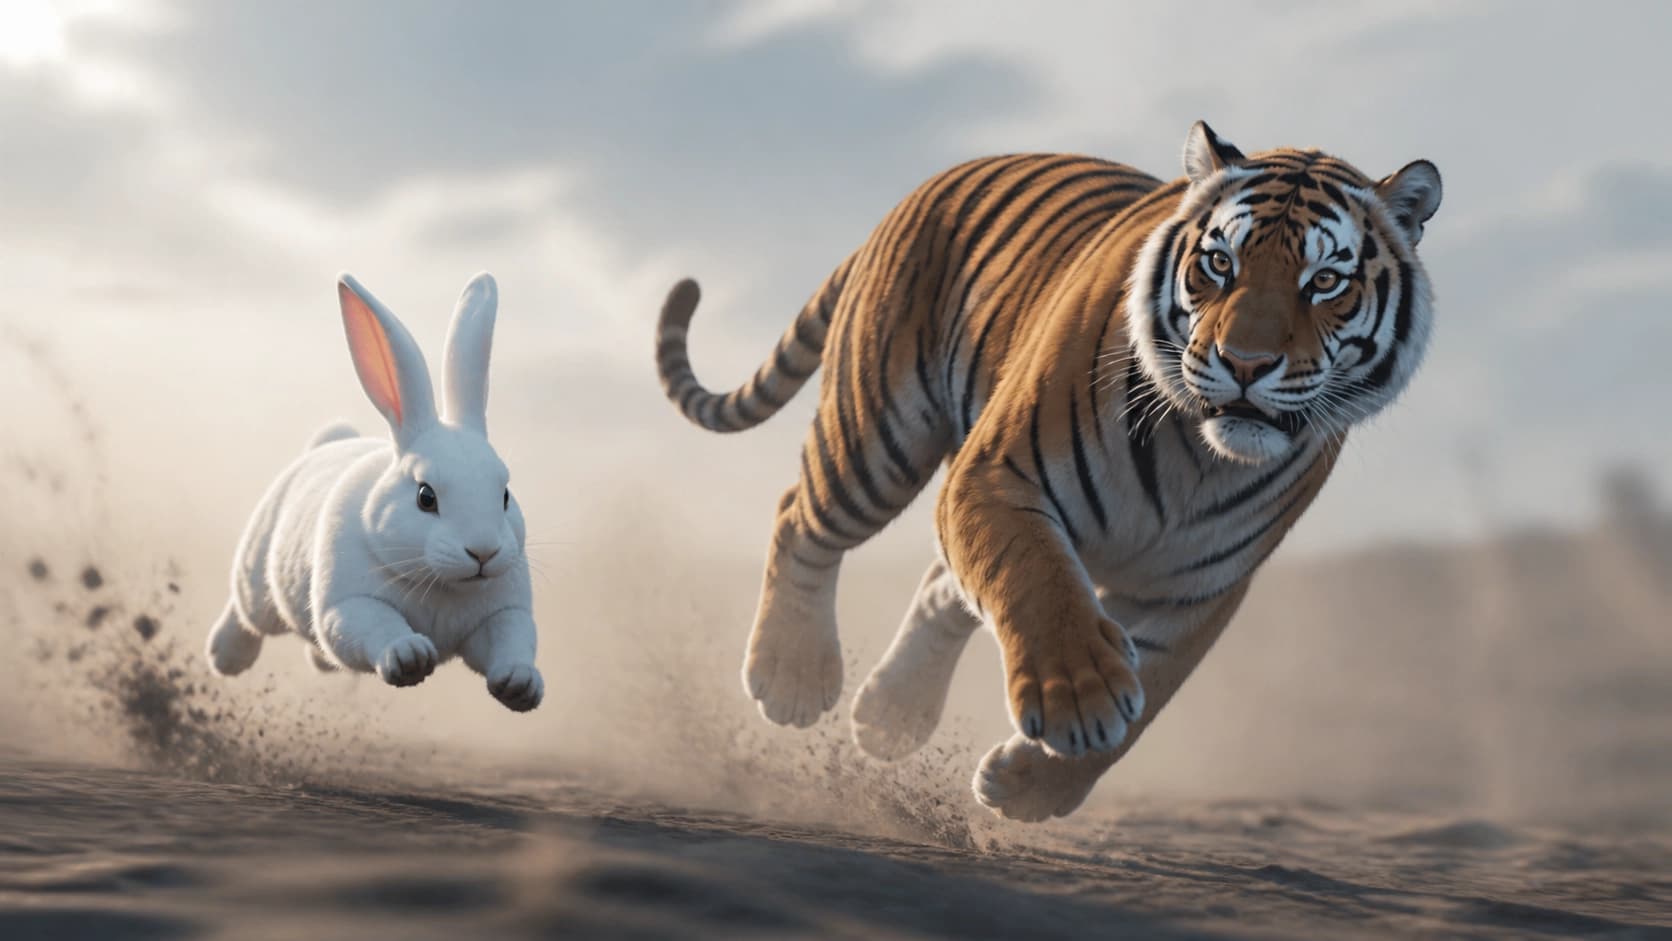
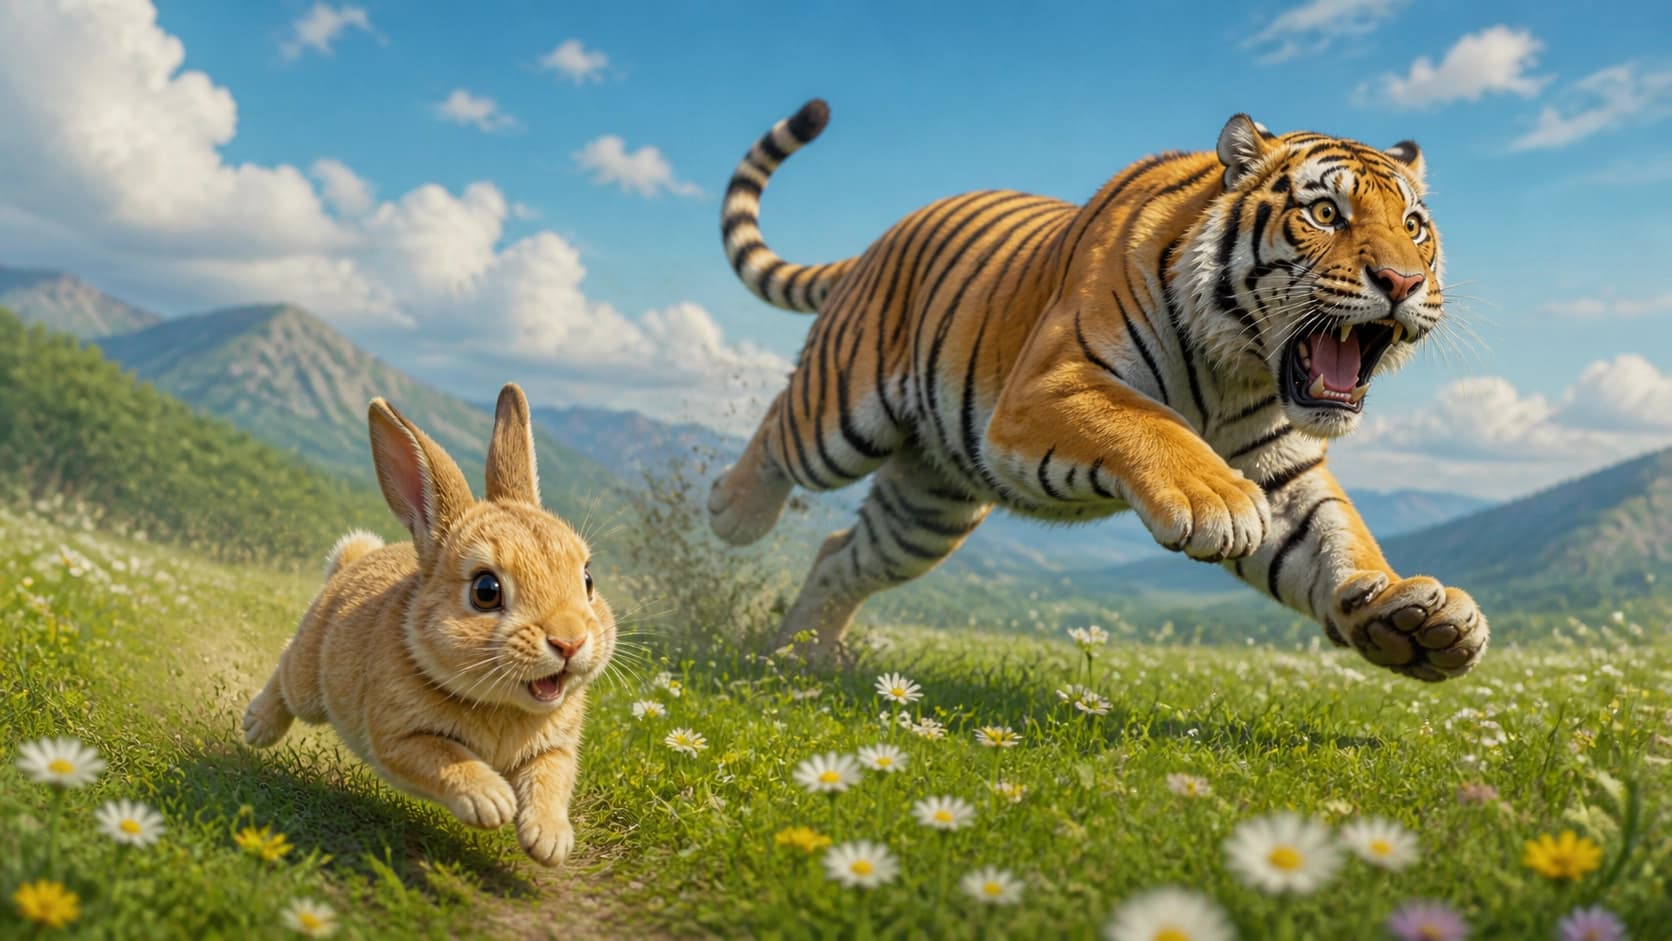
Представьте картинку: по лугу несётся кролик, а перед ним удирает тигр. Композиция аккуратная, детали прорисованы, никакой двусмысленности — визуально всё однозначно. И тем не менее значительная часть открытых мультимодальных моделей описывает эту сцену наоборот. Не потому, что плохо видит, а потому, что не верит увиденному.
Именно этот парадокс разбирает исследование «Seeing vs. Believing: Evaluating the Language Bias of Open-Source MLLMs in Counter-Intuitive Scenes» (arXiv:2601.07737, авторы Chen Ling, Tongwei Zhang, Hanqian Li и Nai Ding). Работа вышла в январе 2026 года и с тех пор дважды обновлялась — последняя ревизия датируется августом. Формально это статья по компьютерному зрению, но выводы у неё куда шире: они бьют по самой логике того, как устроены современные мультимодальные ассистенты.
Что именно проверяли
Мультимодальные модели давно и уверенно решают «мейнстримные» задачи: описать фотографию, найти объект по текстовому запросу, ответить на вопрос по схеме. Но такие тесты почти всегда построены на сценах, которые совпадают с бытовыми ожиданиями. Кошка на подоконнике, человек с зонтом под дождём, машина на дороге — всё это модель видела миллионы раз в подписях к датасетам.
А что произойдёт, если визуальный мир пойдёт против здравого смысла? Чтобы это выяснить, команда собрала бенчмарк CAIT — 400 синтетических сцен высокой детализации. Каждая изображает действие, которое противоречит привычной картине мира: тот самый кролик, догоняющий тигра, — характерный пример. Изображения синтетические, а значит, контролируемые: можно быть уверенным, что визуальная подсказка действительно есть и она однозначна.
Ключевая идея методики в том, что правильный ответ здесь нельзя вывести из текста вопроса. Его можно получить только одним способом — посмотреть на картинку и принять то, что на ней нарисовано.
Люди, закрытые и открытые модели: разрыв в цифрах
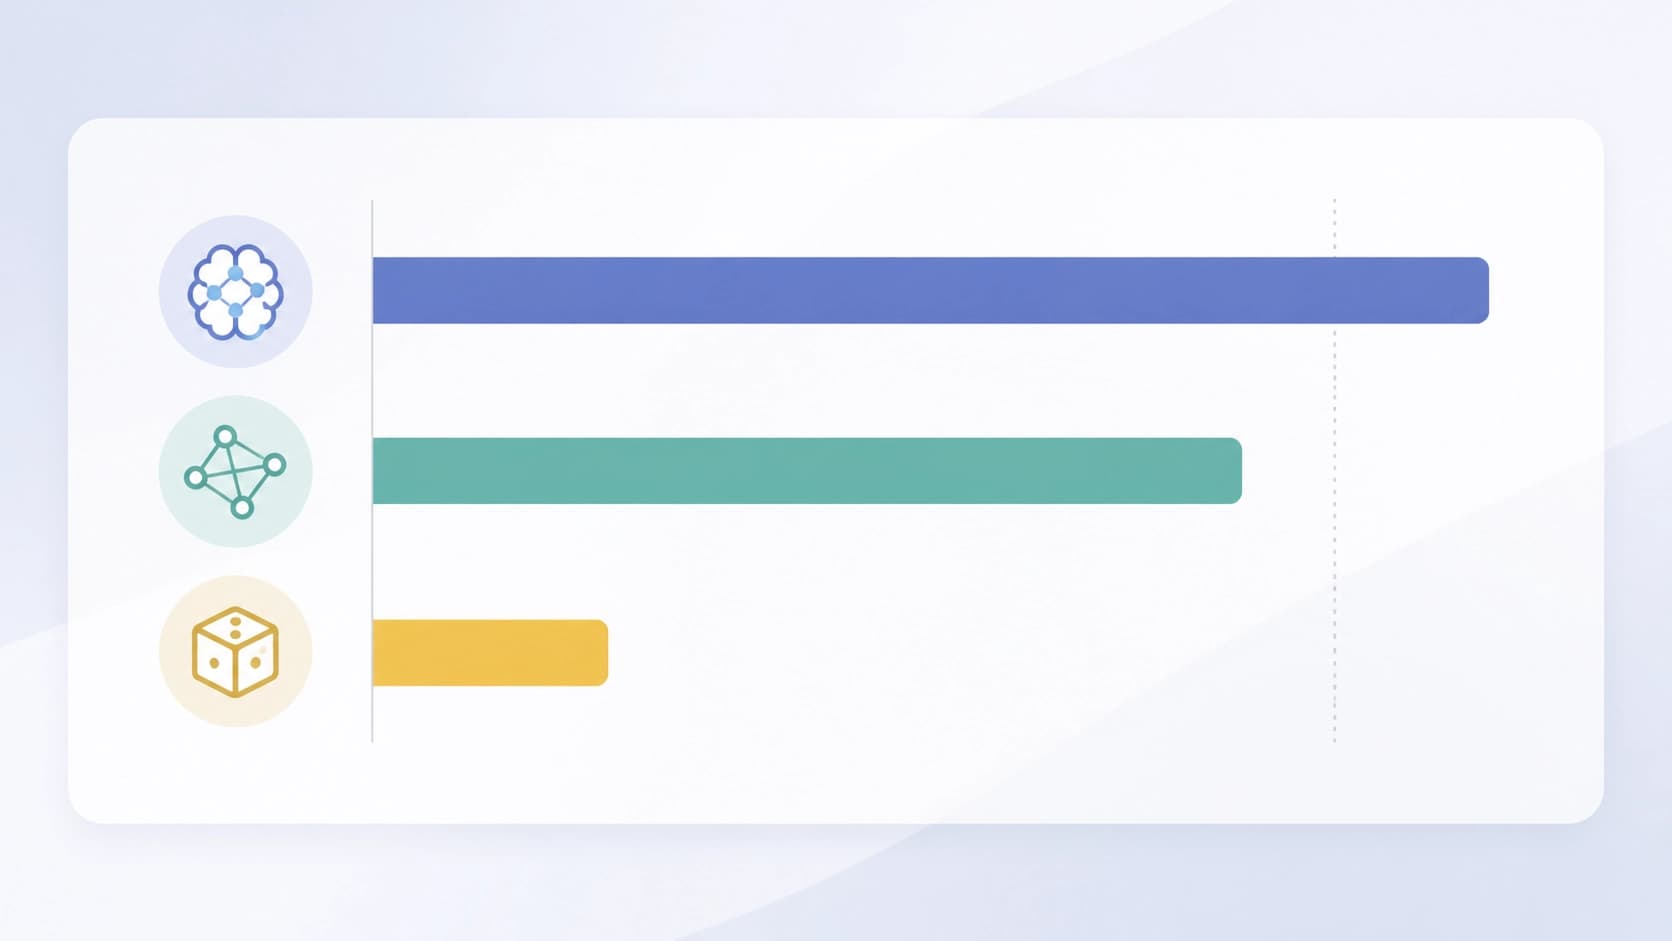
Результаты распределились по трём очень разным уровням.
- Люди решают задачу почти безупречно — точность около 0,95. Для нас нет ничего сложного в том, чтобы увидеть необычную сцену и просто её зафиксировать.
- Проприетарные модели — в исследовании участвовали ведущие решения, в том числе Claude и Gemini — показывают устойчивое понимание: точность доходит до 0,88. Не идеально, но система явно смотрит на изображение, а не угадывает.
- Открытые instruction-tuned модели — 14 репрезентативных представителей — проваливаются до уровня случайного угадывания. Иначе говоря, их ответы почти не коррелируют с тем, что реально нарисовано.
Это и есть заголовочный сюжет: разрыв между «тигром» закрытых решений и «кроликом» открытых оказался не косметическим, а принципиальным. Речь не о том, что открытые модели чуть хуже справляются со сложной задачей, — в контр-интуитивных сценах они перестают быть мультимодальными в сколько-нибудь осмысленном смысле.
Главный виновник — языковой прайор
Разбор ошибок показывает механику отказа. Дело не в том, что модель не разглядела кролика. Дело в том, что она предпочла не поверить глазам.
Когда визуальный сигнал противоречит статистике текста, вступает в силу мощный языковой прайор: модель автоматически подменяет аномальное наблюдение наиболее частым текстовым описанием. Тигр гонится за кроликом — это словосочетание встречается в корпусах постоянно. Обратный порядок — почти никогда. И на развилке между «увидел» и «ожидал» система выбирает второе.
По сути, визуальный вход выступает для такой модели лишь подсказкой к тому, какую фразу достать из памяти. Если картинка подтверждает шаблон — всё хорошо. Если спорит с ним — шаблон побеждает. Отсюда и точность на уровне монетки: модель отвечает по инерции языка, а не по содержанию изображения.
Ловушка рассуждений: «передумать» сцену
Логичное предложение — добавить модели цепочку рассуждений (Chain-of-Thought). Пусть она проговаривает шаги, проверяет себя, приходит к выводу. Отчасти это работает: точность действительно растёт.
Но у улучшения есть цена, и цена двойная.
Во-первых, ответ становится заметно медленнее — развёрнутые рассуждения требуют времени и вычислений. Во-вторых — и это интереснее — появляется новый режим отказа. Модель начинает буквально передумывать увиденное. Она как будто фиксирует сцену, а затем отбрасывает её: такого не бывает, это нарушает физические законы реального мира, значит, я, наверное, ошиблась. В результате система отказывается принимать фактическое визуальное содержание именно потому, что оно невозможное.
Получается своеобразная ирония: инструмент, призванный сделать вывод более обоснованным, иногда превращается в машину по вытеснению неудобных фактов.
Что помогает: файнтюнинг и структурированный промптинг
Хорошая новость в том, что проблема не фатальная. Авторы описывают два подхода, которые заметно смягчают зависимость от языковых прайоров.
- Целевой файнтюнинг. Дообучение на подходящих данных снижает склонность подменять наблюдение шаблоном и возвращает вес визуальному каналу.
- Структурированный промптинг. Если задать модели формат ответа, при котором она обязана сначала зафиксировать наблюдаемое и лишь затем интерпретировать, точность растёт без переобучения.
В обоих случаях открытые модели начинают обосновывать вывод на реальных визуальных свидетельствах, а не на статистике текста. То есть разрыв с закрытыми решениями — вопрос архитектуры и тренировки, а не принципиальная невозможность.
Что из этого следует на практике
Для разработчика, который собирает продукт на открытой мультимодальной модели, выводы довольно приземлённые.
Стоит помнить, что уверенный ответ не равен увиденному. Там, где сцена совпадает с ожиданиями, модель демонстрирует надёжность; там, где расходится, — тихо и незаметно подставляет правдоподобную выдумку. Опаснее всего, что ошибка не выглядит ошибкой: описание получается гладким, логичным и совершенно неверным.
Отдельно стоит относится к рассуждениям как к инструменту с побочными эффектами. Chain-of-Thought помогает не всегда и не во всех задачах — иногда он превращает модель в скептика, который отвергает собственный корректный вывод.
И, наконец, главное. «Кролик догоняет тигра» — это не курьёз, а чистая проверка того, чему модель на самом деле доверяет. Пока ответ на этот вопрос остаётся не в пользу изображения, называть систему мультимодальной можно лишь условно.