
RBS-Attention: ускорение префилла длинных промптов с поиском недооценённых блоков
В статье представлен метод, который дополняет отбор блоков по среднему сходству поиском кандидатов, способных скрывать важные токены. На контексте 128K авторы сообщают об ускорении внимания при префилле до 20,65 раза; на Qwen3-32B результат RULER составил 88,65 против 89,52 у плотного внимания.
Какую часть инференса ускоряет метод
Префилл обрабатывает промпт до начала генерации. Плотный self-attention проходит по всему входу, поэтому длинный контекст увеличивает вычислительную нагрузку этого этапа.
RBS-Attention разреженно выбирает блоки для префилла и может снизить вычислительные затраты. Но центроид блока усредняет релевантность токенов и способен скрыть важный токен среди нерелевантных. Авторы называют этот сбой mean dilution.
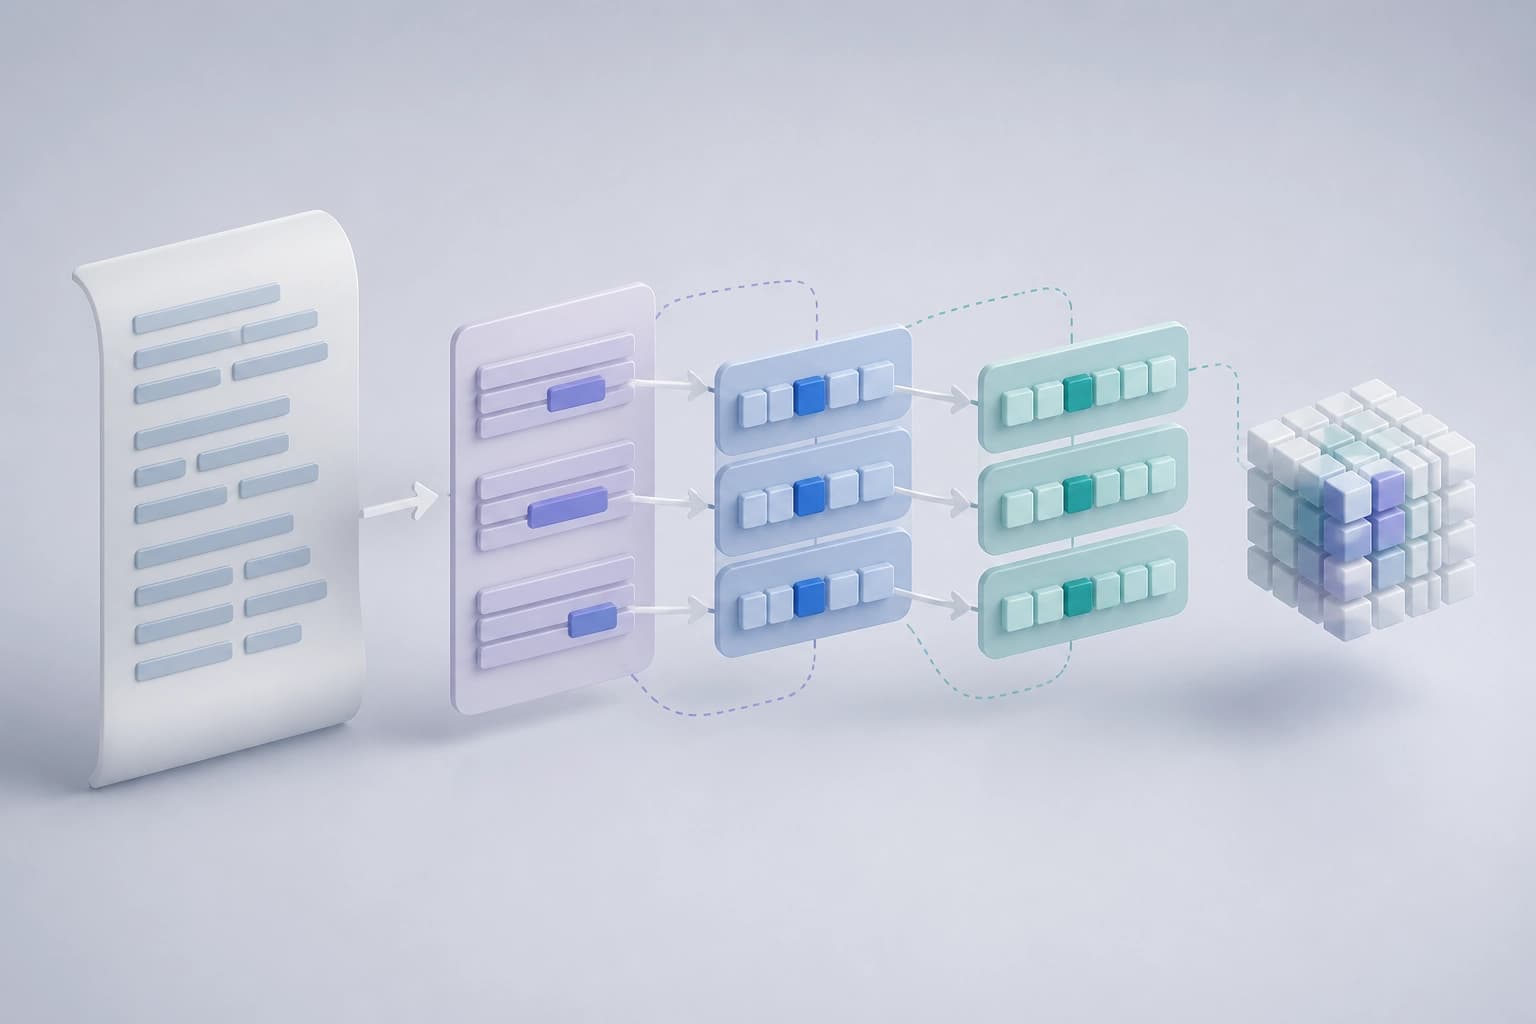
Практический смысл метода — ускорить префилл, не полагаясь только на среднюю релевантность целого блока.
Как устроен выбор блоков
Метод не требует обучения и использует две дополняющие друг друга ветви:
- Базовая ветвь оценивает среднюю релевантность блока через центроид.
- Ветвь восстановления учитывает максимальный радиус key-блока и его распределение, зависящее от промпта, слоя и головы. Так она выявляет блоки с потенциально недооценённой релевантностью.
Каждая ветвь отдельно применяет порог к своему выбору. Затем метод объединяет маски и контролирует вклад блоков восстановления. Выполнение остаётся через регулярный блочно-разреженный FlashAttention.
Такое устройство подходит для сценариев, где центроидный отбор может пропустить отдельные релевантные токены, а блочно-разреженное выполнение нужно сохранить.
Какие результаты показаны для скорости
Замеры проводили на H100 при контексте 128K. Для Qwen3-30B-A3B-Instruct-2507-FP8 статья приводит следующие ускорения:
| Этап | Ускорение |
|---|---|
| Standalone prefill-attention | 20.65× |
| Prefill-attention в vLLM | 11.92× |
| Сквозной time-to-first-token | 5.97× |
Это результаты конкретной конфигурации. Их следует рассматривать отдельно от оценки качества и не переносить на другие модели без соответствующих замеров.
Что известно о качестве и проверках
На плотной модели Qwen3-32B общая точность RULER составила 88.65. Для плотного attention указано 89.52.
Дополнительную оценку качества проводили на LongBench-v2, InfiniteBench и Video-MME. Вспомогательные эксперименты измеряли сохранение релевантных данных, сравнивали селекторы при одинаковой плотности и проверяли разные размеры блоков, пороги и объём памяти.
При выборе метода скорость и качество стоит оценивать раздельно: приведённые результаты RULER не заменяют проверку на задачах, важных для конкретного применения.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Проверка галлюцинаций LLM через SQL-представление источников без дообучения
Работа проверяет, способна ли LLM задействовать базовый символический навык — сборку SQL-базы по исходным документам — для привязки к источнику без учителя при детекции галлюцинаций. На RAGTruth и DiaHalu такой нейросимволический конвейер оказывается точнее прямого предсказания и сопоставим с передовыми методами, не требуя тонкой настройки под предметную область.
9 ноября 2026
MathAdv: что скрывает итоговая точность машинных доказательств
Диагностический набор задач по 13 университетским и аспирантским разделам математики оценивает системы машинного доказательства в Lean 4 не только по итоговому результату, но и по владению предметом, качеству неформальных рассуждений и устойчивости к переформулировкам условий. Покомпонентный разбор показывает, что перевод задачи в формальный вид по-прежнему остаётся главным препятствием, а успех сильно зависит от области математики и от способа постановки задачи.
9 ноября 2026
AffordanceWAM: аффордансы как посредник между прогнозом сцены и управлением манипулятором
Работа описывает генеративную модель, которая одновременно прогнозирует будущие RGB-наблюдения, скалярные поля и тепловые карты аффордансов и непрерывные команды робота, используя человеческие видео для расширения разнообразия взаимодействий без аннотаций действий и ретаргетинга. На RoboCasa, CALVIN ABC→D и реальных задачах подход даёт устойчивый выигрыш относительно базовых линий только на RGB и только на роботных данных.
9 ноября 2026