
Дообучение генеративных моделей изображений: совместный учет предпочтений и рубрик
Статья описывает метод постобучения text-to-image моделей в открытом домене, где сигнал человеческих предпочтений дополняется рубричными проверками соответствия промпту и желаемых свойств. Из результатов следует, что взвешенное усреднение наград проигрывает предложенной схеме, а на снимке Arena дообученные Flux2dev и Ideogram-4 показывают заметный рост Elo.
Задача: открытый домен и два сигнала
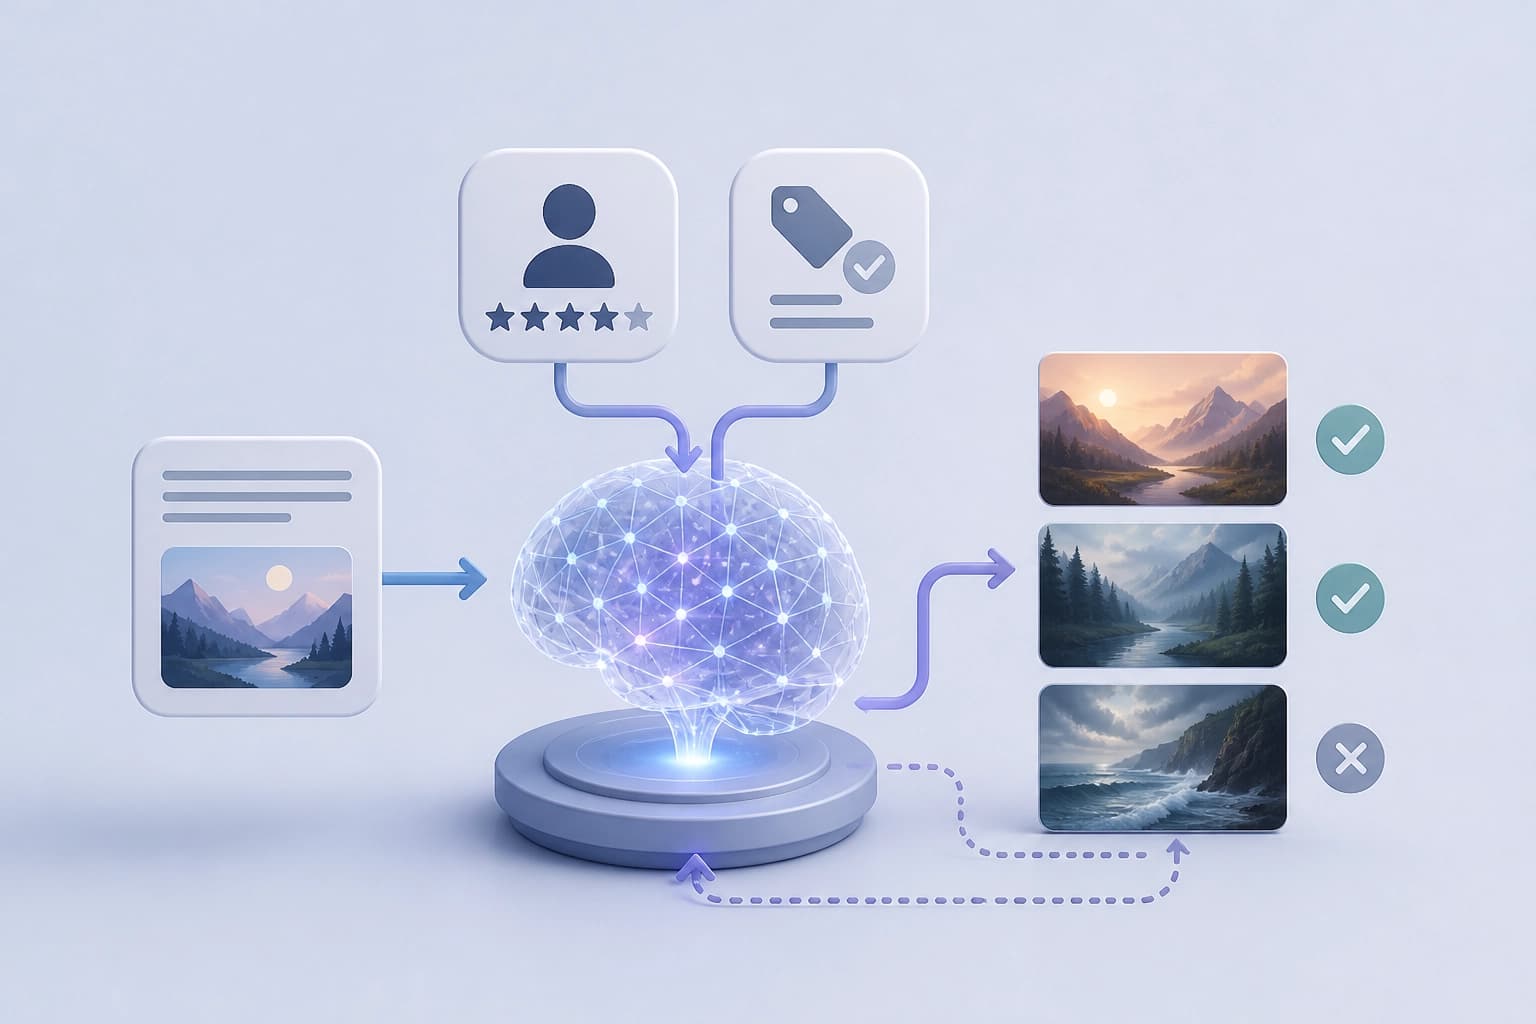
Генерация изображений по тексту в открытом домене требует учитывать разные требования. К ним относятся соответствие промпту и человеческие предпочтения. Один сигнал вознаграждения не покрывает оба типа требований. Работа «Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards» предлагает постобучение на комбинации взаимодополняющих сигналов.
Метод сочетает вознаграждение за предпочтения и вознаграждения на основе рубрик. Первый сигнал отражает человеческие предпочтения. Второй проверяет соответствие промпту и другие желательные свойства. Комбинация закрывает разные части запроса. Вывод: для открытого домена критерий выбора — наличие не одного, а дополняющих друг друга сигналов. Они должны покрывать субъективный выбор и выполнение задания.
Устройство системы вознаграждений
Система включает два основных компонента. Вознаграждение за предпочтения обучают на крупномасштабных данных человеческих предпочтений. Для обучения применяют Bradley-Terry objective. Такой сигнал отражает выбор людей.
Рубрики оценивают соответствие промпту и другие желательные свойства. Они также обеспечивают защиту от reward hacking. Компоненты решают разные задачи и дополняют друг друга.
| Компонент | На что опирается | Что проверяет | Роль |
|---|---|---|---|
| Вознаграждение за предпочтения | Крупномасштабные данные человеческих предпочтений, Bradley-Terry objective | Выбор людей при сравнении результатов | Оптимизация предпочтений |
| Вознаграждения на основе рубрик | Рубрики с критериями | Соответствие промпту и другие желательные свойства | Защита от reward hacking |
Авторы формулируют требование к эффективным вознаграждениям. Они должны широко охватывать намерения пользователей. Они должны быть устойчивыми к эксплуатации в ходе оптимизации.
Вывод: критерий выбора — рубрики должны дополнять предпочтения, а не подменять их. Система без рубрик теряет защиту от reward hacking. Система без предпочтений не опирается на человеческий выбор.
Комбинирование вместо простого среднего
Авторы сообщают о проблеме наивного взвешенного среднего. При оптимизации такое усреднение приводит к неоптимальному поведению. Работа предлагает стратегию комбинирования вознаграждений. Она эффективнее балансирует оптимизацию предпочтений и выполнение рубрик.
| Подход | Что происходит при оптимизации |
|---|---|
| Наивное взвешенное среднее | Поведение становится неоптимальным |
| Стратегия комбинирования | Оптимизация предпочтений и выполнение рубрик балансируются эффективнее |
Стратегия комбинирования становится отдельной частью метода. Вывод: критерий выбора — наличие стратегии комбинирования, а не только набора вознаграждений. Веса сигналов без стратегии не гарантируют нужного поведения.
Результаты в рейтинге Arena text-to-image
В рейтинге Arena text-to-image модель Flux2dev получила Elo на 69 пунктов выше базовой. Модель прошла RL-обучение. Модель Ideogram-4 после постобучения превзошла все модели с открытым исходным кодом. Её Elo составил 1223.5.
Эти данные показывают эффект постобучения в рамках рейтинга. Они не описывают другие сценарии применения.
| Модель | Результат | С чем сравнивают |
|---|---|---|
| RL-trained Flux2dev | Elo на 69 пунктов выше | Базовая модель |
| Post-trained Ideogram-4 | Elo 1223.5 | Все модели с открытым исходным кодом |
Вывод: критерий оценки — смотреть на базовую модель и на условие обучения. Для Flux2dev авторы дают прирост относительно базовой. Для Ideogram-4 они фиксируют позицию среди открытых моделей.
Ограничения снимка рейтинга и данных
Заявления о передовых результатах относятся к снимку Arena от 4 сентября 2026 года. Снимок фиксирует состояние рейтинга на эту дату. Авторы выпустили Arena-T2I-Training. Это подмножество обучающих данных объёмом 1K.
Оно позволяет воспроизвести часть улучшений полного обучения. Часть улучшений остаётся вне подмножества. Для проверки метода важно отделять полный результат от воспроизводимой части.
Вывод: критерий выбора — учитывать дату снимка и границы воспроизводимости. Заявление без этих рамок остаётся неполным.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Бенчмарк Zero2Repo: пределы автономной сборки проекта из пустого каталога
Исследование предлагает оценивать кодирующих агентов на полной сборке репозитория: вход — спецификация, интерфейсный контракт и пустая среда, проверка — скрытые тесты без LLM-судьи. Даже ведущие агенты редко проходят все проверки, а основная доля сбоев приходится на отдельные пропущенные пункты требований.
13 ноября 2026
FedSocket: обмениваемые модели с обязательной исполнимостью у получателя при мультимодальной гетерогенности
Предложен FedSocket — подход, при котором обмениваемая модель обязана быть вычислима на стороне получателя, а разнородные частные модели связывает общий интерфейс предсказаний Q. В статье описаны агрегация с учётом принадлежности, пересылка лишь параметров Q вместе со счётчиками и эксперименты на шести датасетах, демонстрирующие рост точности при недостающих модальностях и преимущество Joint-инференса над независимыми ансамблями.
13 ноября 2026
CyberArena: парные матчи ИИ-агентов выявляют пределы статичных кибербенчмарков
Бенчмарк помещает двух агентов в песочницы с непрерывно меняющимися сервисами и по итогам серии раундов сводит их действия к многомерным оценкам наступательных и оборонительных навыков. На 466 матчах с 12 современными моделями он различил возможности там, где односторонние тесты упираются в потолок, включая планирование на несколько ходов и создание бэкдоров.
13 ноября 2026