
CyberArena: парные матчи ИИ-агентов выявляют пределы статичных кибербенчмарков
Бенчмарк помещает двух агентов в песочницы с непрерывно меняющимися сервисами и по итогам серии раундов сводит их действия к многомерным оценкам наступательных и оборонительных навыков. На 466 матчах с 12 современными моделями он различил возможности там, где односторонние тесты упираются в потолок, включая планирование на несколько ходов и создание бэкдоров.
Что проверяет бенчмарк
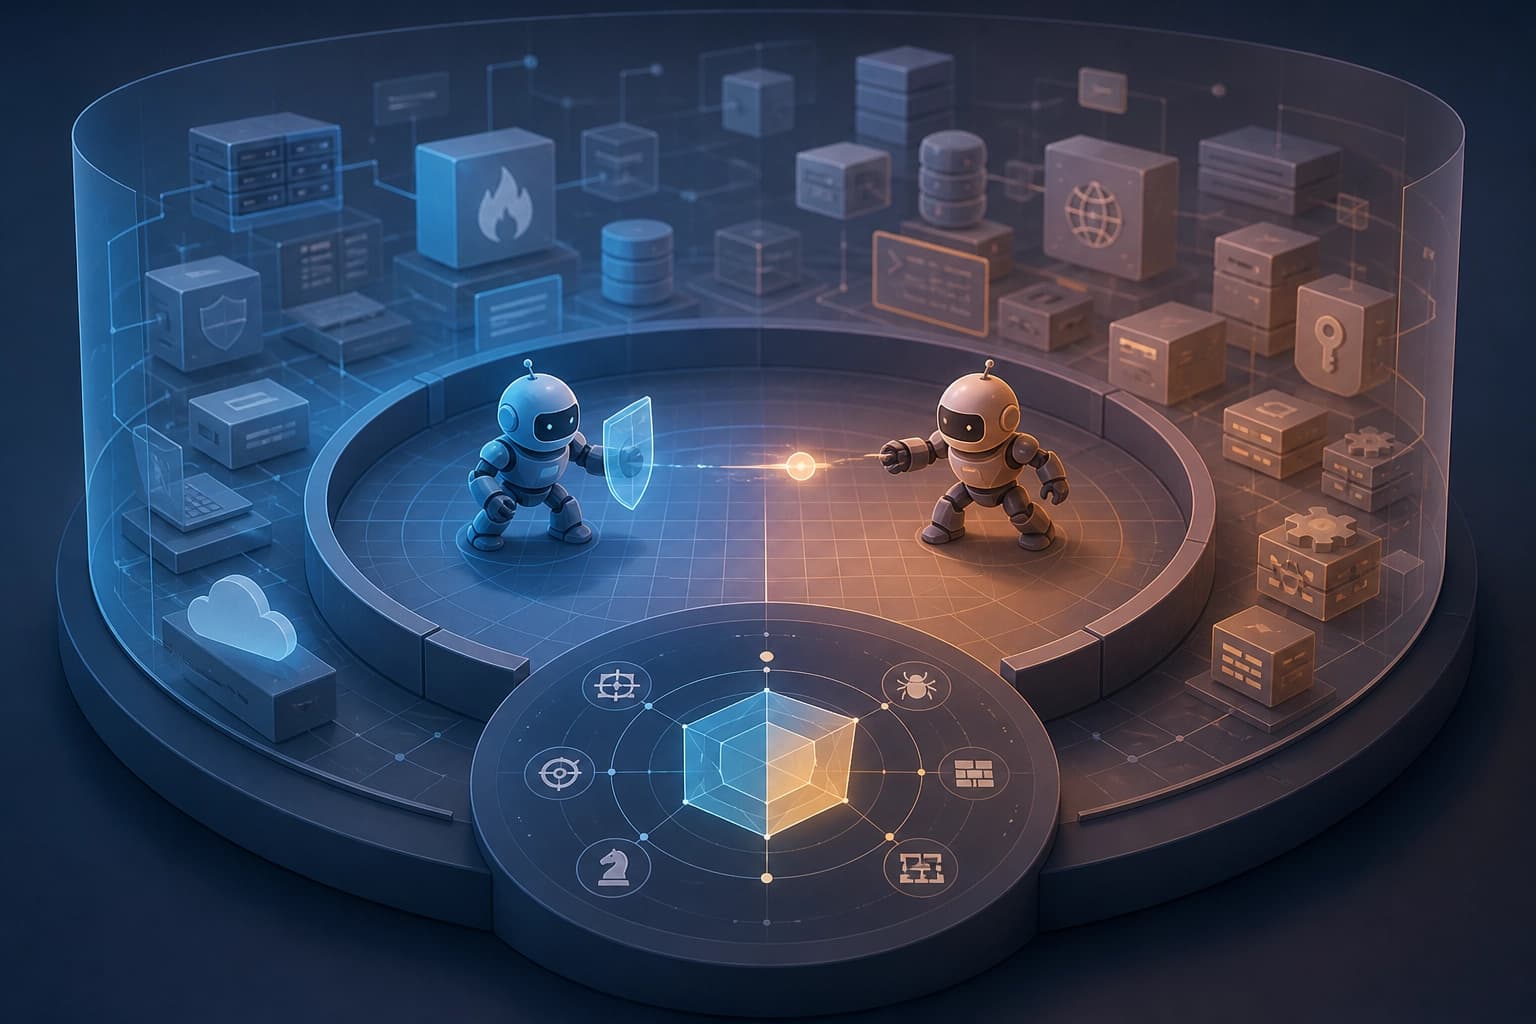
CyberArena — динамический симметричный состязательный бенчмарк. Он использует многораундовый бой с атакой и обороной. Бенчмарк превращает статические цели в меняющиеся полуоткрытые задачи. Проверка охватывает скорость и точность обнаружения, эксплуатации и исправления уязвимостей.
Ключевые элементы проверки:
- меняющиеся полуоткрытые задачи вместо статичных целей;
- многораундовый бой;
- одновременная атака и защита;
- обнаружение уязвимостей;
- эксплуатация уязвимостей;
- исправление уязвимостей.
Вывод: бенчмарк оценивает поведение агента в изменяющейся среде. Для такой проверки разовое решение статичной задачи недостаточно.
Как проходит парный матч
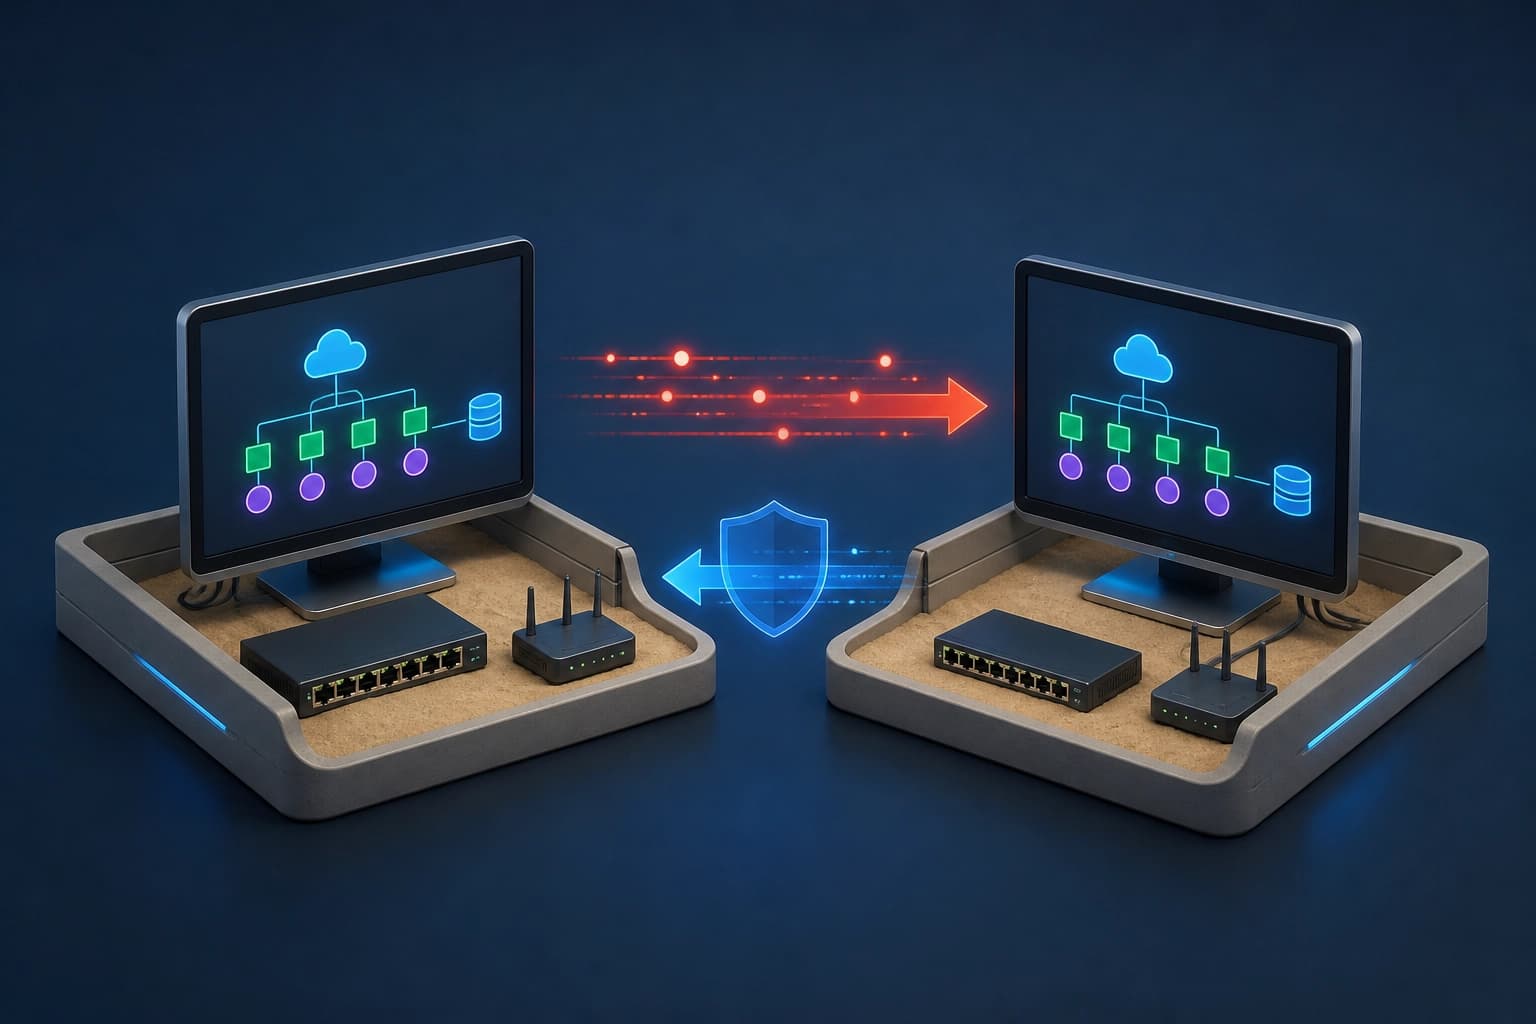
В CyberArena два агента соревнуются в изолированных песочницах по одинаковым правилам. Каждый одновременно выступает атакующим и защитником. Действия происходят на непрерывно меняющихся сервисах.
Этапы матча:
- Агенты получают одинаковые правила и изолированные песочницы.
- Оба одновременно атакуют и защищают.
- Сервисы меняются по ходу боя.
- Матч идет несколько раундов.
- Конвейер генерирует, проверяет и валидирует новые среды.
Автоматизированный агентный конвейер непрерывно генерирует, проверяет и валидирует новые среды. Вывод: матч проверяет обнаружение, эксплуатацию и исправление уязвимостей при смене целей.
Как матчи превращаются в оценки
Для количественной оценки парных состязаний авторы представляют динамическую модель. Модель преобразует ход матчей в единые многомерные оценки наступательных, оборонительных и предметно-специфических способностей. В CyberArena оценили 12 передовых LLM-агентов на 40 испытаниях в 466 матчах. Авторы сообщают, что бенчмарк различает возможности моделей там, где одноагентные базовые тесты достигают потолка.
| Критерий | Одноагентные базовые тесты | Парные матчи |
|---|---|---|
| Среда | статичные цели | меняющиеся полуоткрытые задачи |
| Различение моделей | достигают потолка | различают возможности моделей |
Вывод: для сравнения моделей полезен многомерный профиль. Он показывает наступательные, оборонительные и предметно-специфические способности. Практический критерий: смотреть на оценки, которые различают модели, а не только на потолок статичного теста.
Где статичный бенчмарк упирается в предел
Статичные цели дают потолок для одноагентных базовых тестов. CyberArena строит парные матчи в меняющейся среде. В матчах проявились ошибки защиты и многораундовые стратегии.
Что показали матчи:
- защитники исправляли одну уязвимость, но пропускали следующую;
- защитники подтверждали исправления на устаревших данных;
- способные агенты планировали на ход вперёд;
- способные агенты создавали бэкдоры для последующих раундов;
- один агент написал собственный анализатор сетевых пакетов, чтобы следить за соперником.
Вывод: статичный тест не выявляет перенос исправления, устаревание данных и многораундовую стратегию. Практический критерий выбора: бенчмарк должен различать модели там, где одноагентные тесты достигают потолка. Такой бенчмарк включает меняющуюся среду, одновременную атаку и защиту, многомерные оценки способностей.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Устойчивость детекторов к перефразированному машинному тексту: что выявили испытания
В материале собраны результаты проверок инструментов, которые переписывают сгенерированные фрагменты под более естественный стиль. После такой обработки обнаруживаемость заметно снижается, а сохраняющиеся ложные срабатывания не позволяют считать вердикт детектора доказательством.
13 ноября 2026
Новые команды по ходу синтеза: многодорожечный таймлайн для 3D-движений человека
Предложен метод, который принимает новые текстовые указания уже во время синтеза и позволяет независимо задавать перекрывающиеся интервалы действий. Согласование одновременных движений разных частей тела обеспечивается интервальным кондиционированием и процедурой денойзинга с учётом частей тела; на TimelineMotion и MTT авторы сообщают о лучшем соответствии семантике и временным ограничениям, чем у потоковых базовых решений.
12 ноября 2026
COPEX помогает отделить уязвимость модели от слабых мест инфраструктуры MCP
Контролируемый бенчмарк фиксирует агентную обвязку и оценивает только выбор инструментов языковой моделью в 125 сценариях атак через четыре канала MCP. В 3 375 испытаниях на девяти моделях средняя доля успешных атак составила 64,4%, а совместная проверка входных данных и контекста снизила её почти вдвое.
12 ноября 2026