Почему SFT после RL угрожает рассуждениям
Обучение с подкреплением развивает способности больших языковых моделей к рассуждению. Этот подход стал эффективным для постобучения LLM. Последующий supervised fine-tuning адаптирует пост-RL-модель к новым областям знаний или видам поведения. Такой SFT может серьёзно перезаписать приобретённые способности.
Существующие подходы к уменьшению забывания:
- повторное воспроизведение опыта;
- специализированная инициализация;
- ограниченная оптимизация с проекцией градиента.
Такие методы либо дают ограниченное сохранение способностей, либо требуют значительных дополнительных вычислений. Практический критерий: для пост-RL-модели выбирают метод, который снижает риск перезаписи рассуждений.
Нуль-пространство как ресурс для адаптации
Авторы показывают: активации, связанные с рассуждением, сосредоточены в низкоразмерных подпространствах. Значительная ёмкость остаётся в нуль-пространстве для адаптации. Приближённые нуль-пространства можно надёжно оценить по небольшому числу примеров.
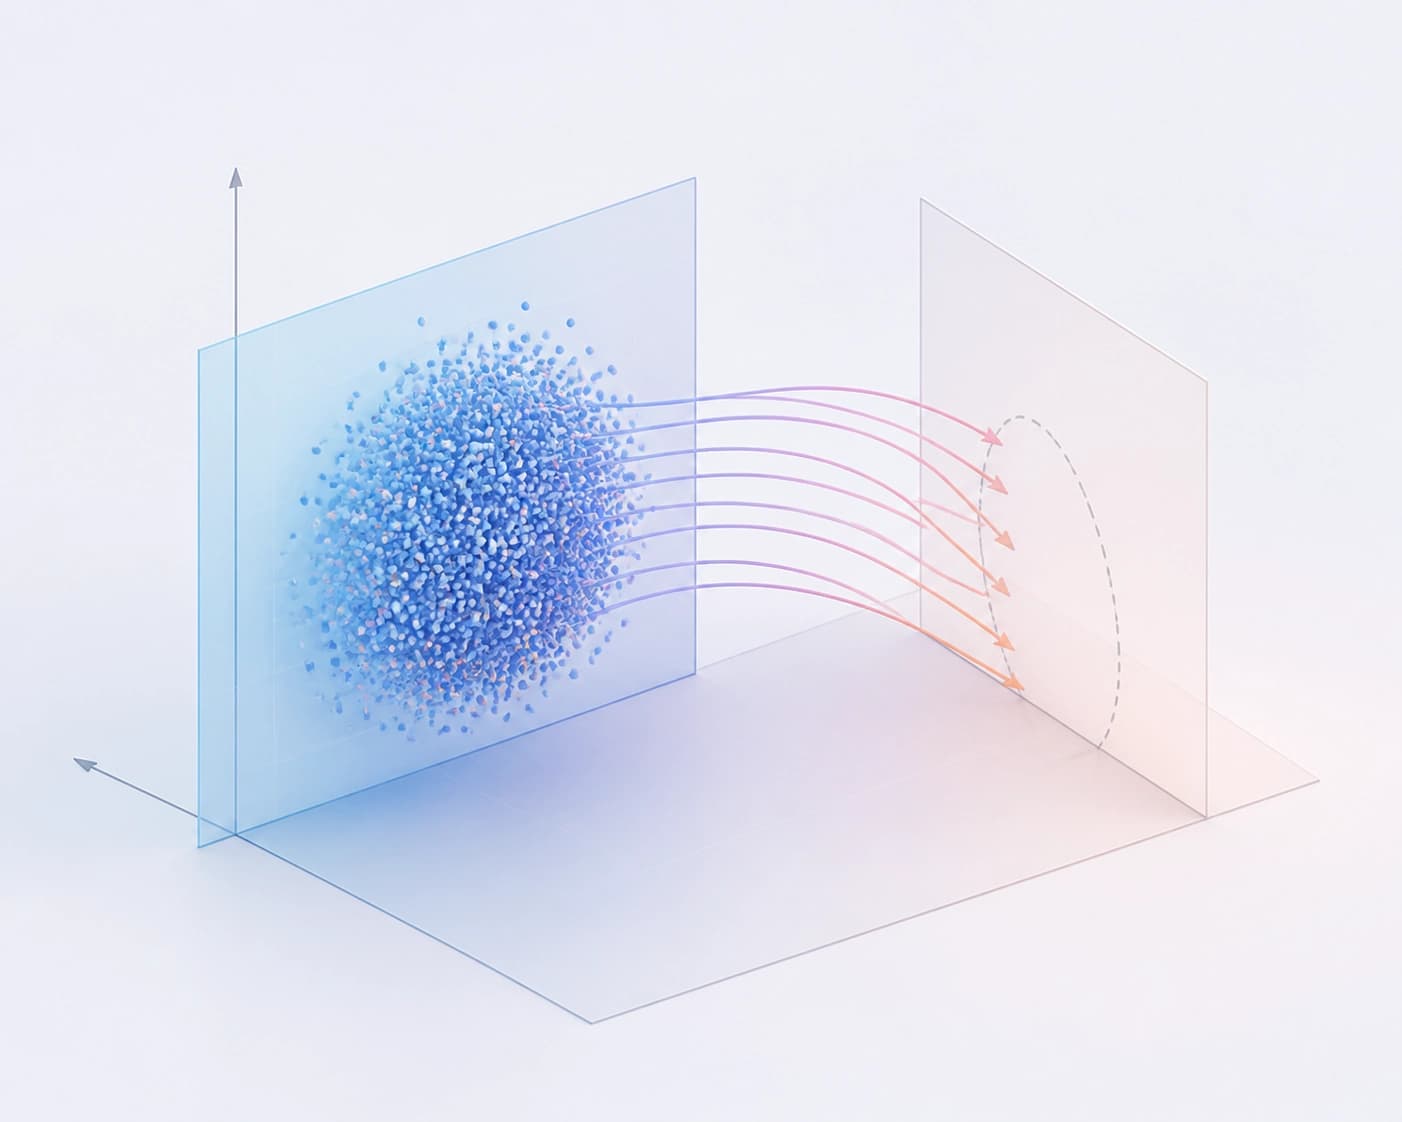
Практический критерий: метод, который строит обновления в нуль-пространстве, использует свободную ёмкость. Он не трогает активации рассуждения.
Устройство NB-LoRA
Null-Basis Low-Rank Adaptation (NB-LoRA) — метод параметрически эффективной адаптации пост-RL LLM. Его предложили в статье arXiv:2609.25618. Метод сохраняет приобретённые способности к рассуждению.
Этапы работы:
- Из активаций рассуждения строят фиксированный приближённый нулевой базис.
- Обновления LoRA перепараметризуют через этот базис.
- Сохранение рассуждений формулируют как ограничение на сохранение скрытых состояний на уровне слоёв.
- Ограничение соблюдают на протяжении тонкой настройки.
Практический критерий: NB-LoRA выбирают, когда нужно провести SFT и сохранить рассуждения пост-RL-модели.
Сравнение с существующими подходами
Таблица сравнивает механизмы и особенности.
| Критерий | Существующие подходы | NB-LoRA |
|---|---|---|
| Механизм | Повторное воспроизведение опыта, специализированная инициализация, ограниченная оптимизация с проекцией градиента | Перепараметризация LoRA через фиксированный приближённый нулевой базис |
| Особенность | Ограниченное сохранение способностей или значительные дополнительные вычисления | Ограничение на сохранение скрытых состояний на уровне слоёв |
Практический критерий: если приоритет — сохранение рассуждений, NB-LoRA даёт встроенное ограничение. Существующие подходы требуют выбора между ограниченным сохранением и дополнительными вычислениями.
Результаты экспериментов и критерий выбора
Эксперименты охватывают несколько обученных с RL LLM и разнообразные последующие задачи. NB-LoRA показывает качество адаптации на уровне стандартной LoRA. Метод сохраняет точность рассуждений около уровня до тонкой настройки. Сохранение переносится на отложенные бенчмарки рассуждений.
Практический критерий: для пост-RL LLM, где SFT угрожает рассуждениям, NB-LoRA — кандидат для проверки на своих задачах.