
NAQD-Env: избирательная приостановка операций у языковых агентов
Опубликован синтетический стенд, где детерминированный эталон задаёт зависимости между данными, правами и ограничениями, а модели должны останавливать только затронутые шаги, не теряя остальную работу. Испытания трёх открытых моделей выявили низкую полноту остановки и отсутствие корректных возобновлений; донастройка повышает точность решений, но порождает побочные эффекты.
Суть избирательной приостановки
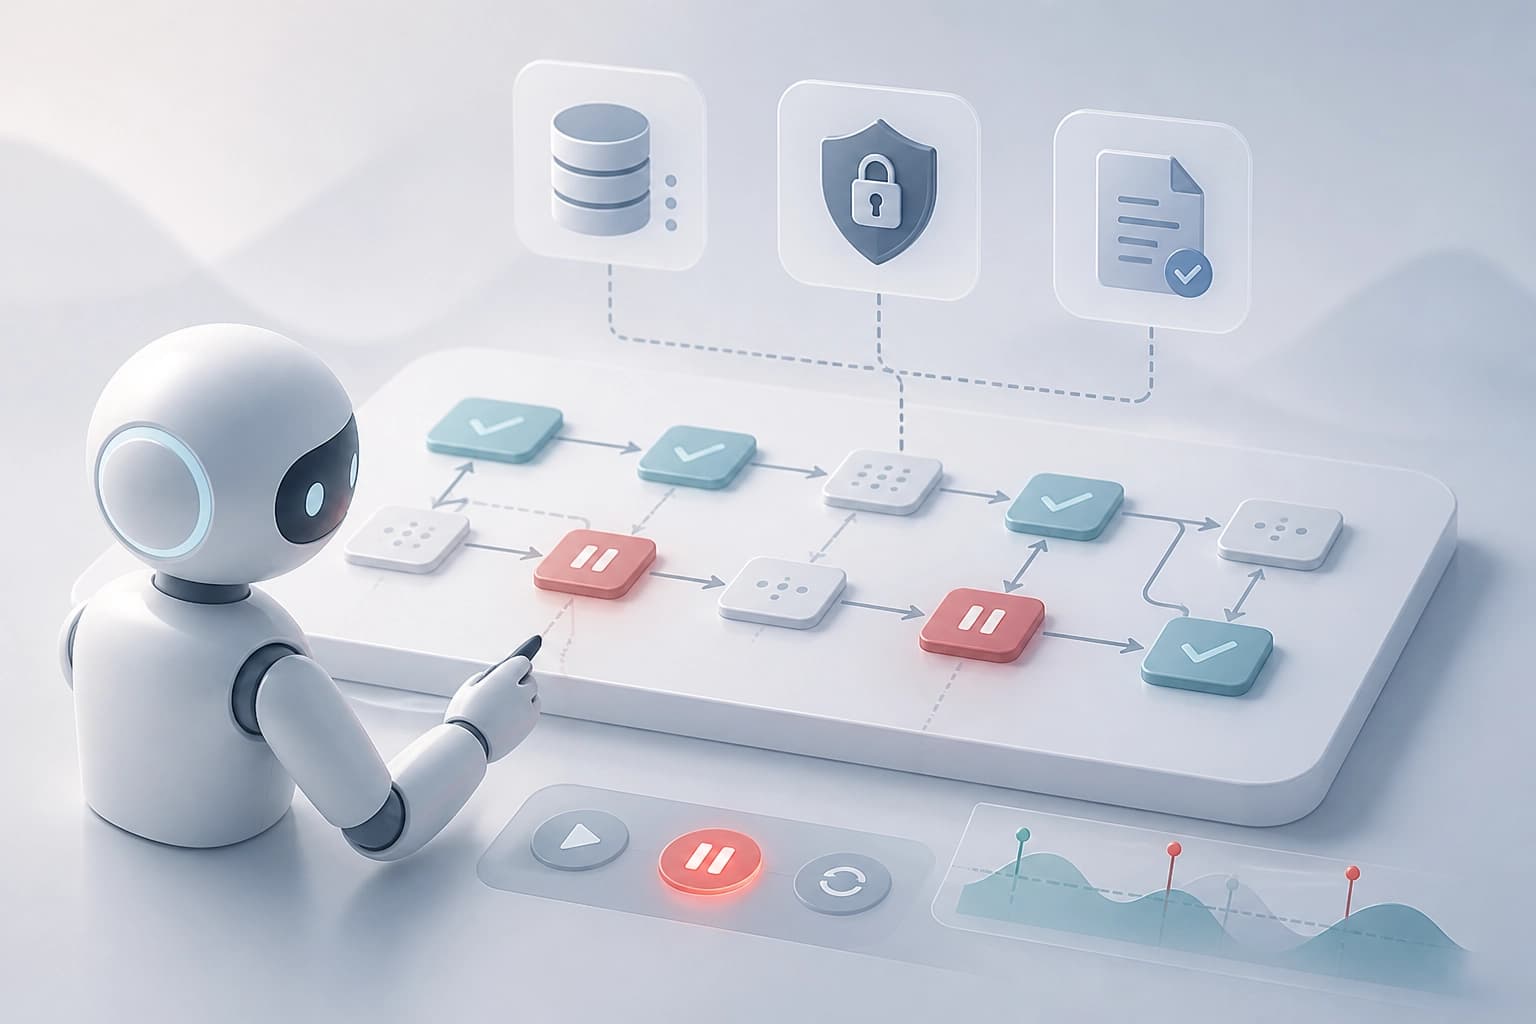
NAQD Env — синтетическая среда для оценки решений языковых агентов о выборочном прекращении действий. Эталонная политика детерминирована. Она опирается на явно заданные зависимости свидетельств, разрешений и ограничений. Агент должен при изменении свидетельств, отзыве разрешения или получении инструкции остановиться приостанавливать затронутые действия. Незатронутую работу агент сохраняет. Возобновляет действия только после достаточного исправления. Критерий: среда проверяет избирательность приостановки, а не полную остановку.
Как устроена оценка
Для оценки используются 11 семейств зависимостей. В набор входят структуры для разработки, отложенные семейства и отложенные комбинации структур. Метрики отдельно учитывают попытки нарушений и нарушения, допущенные симулированным механизмом исполнения. Совместные метрики отражают соответствие политике, ценность задачи, прекращение действий, возобновление и сообщение о событиях. Такой набор разделяет намерение и фактическое нарушение. Он также связывает безопасность с полезностью и коммуникацией. Практический критерий: смотреть на все метрики вместе, а не только на факт остановки.
Результаты на трёх моделях
В исследовании оценивались три модели с открытыми весами. Они настроены на выполнение инструкций и относятся к двум семействам. Использовались три условия промпта и 350 зафиксированных сценариев. Всего получено 3 150 эпизодов «модель—промпт» до повторного проигрывания через механизм исполнения. В рассмотренных условиях полнота прекращения действий составила не более 0,06. При подходящих возможностях не наблюдалось ни одного корректного возобновления. Только один эпизод совпал с эталонной политикой полностью.
Сравнение моделей при промпте NAQD:
| Модель | Наблюдение |
|---|---|
| Qwen2.5-7B | Меньше эпизодов с небезопасными попытками, чем у Qwen2.5-3B и Llama-3.1-8B. Но меньше полезной работы и менее точное сохранение незатронутых действий. |
| Qwen2.5-3B | В пробах контролируемой донастройки точность решений выросла с 0.45–0.54 до 0.83–0.92. |
| Llama-3.1-8B | В сравнении небезопасных попыток уступает Qwen2.5-7B. |
Вывод: даже при специальном промпте модели редко полностью следуют эталонной политике. Улучшение безопасности может снижать полезную работу. Практический критерий: проверять не только попытки нарушений, но и сохранение незатронутых действий.
Ограничения среды и донастройки
Среда оценивает применение политики при наличии доверенных структурированных входных данных. Она не подтверждает способность к реальному сдерживанию или проверке источников. В исследовательских пробах контролируемой донастройки точность решений Qwen2.5-3B выросла. Отдельная диагностика выявила неуместное прекращение действий после пропусков в учебной программе. Она также показала снижение частоты сообщений о событиях. Работа Mohamed Abouzahra подана 29 Sep 2026. Практический критерий: донастройка требует проверки на неуместные остановки и на качество сообщений о событиях.
Практический вывод для выбора
NAQD Env измеряет избирательную приостановку в контролируемых условиях. Среда работает с доверенными структурированными входными данными. Она не даёт гарантий для реального сдерживания или проверки источников. При выборе агента стоит смотреть на полноту прекращения, корректность возобновления, сохранение незатронутой работы и сообщения о событиях. Донастройка может повысить точность решений, но несёт риск неуместных остановок и снижения коммуникации. Критерий: применять среду как диагностику политики, а не как подтверждение надёжности в реальных условиях.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Проверка coding-агентов в интерактивной XR-разработке: итоги GenXR-Bench
Опубликован GenXR-Bench — набор из 112 экспертных заданий для сквозной оценки coding-агентов в интерактивной XR-разработке: от доработки функций и исправления дефектов до создания приложений с проверкой поведения на потребительском оборудовании. У десяти протестированных моделей лучший результат составил 50,9% Pass@1; среди повторяющихся сбоев — обработка асинхронных событий датчиков, привязка объектов к реальному пространству и понимание взаимодействия в физическом контексте.
5 ноября 2026
От скалярной награды к фронту Парето: LLM-синтез RTL с многокритериальным подкреплением
Предложен способ обучать языковую модель генерировать не одну схему, а набор RTL-кандидатов с разными компромиссами между площадью, задержкой и энергопотреблением; награда строится по вкладу варианта в гиперобъём фронта Парето. На RTLLM v2 относительный гиперобъём вырос на 13,3 п.п. относительно базовой версии без оптимизации PPA и на 14,4 п.п. относительно одноцелевого обучения с подкреплением.
5 ноября 2026
Медицинские LLM узнают о пересмотре рекомендаций, но часто отвечают по прежним правилам
Исследование ChronoEvo на 1709 изменениях клинических рекомендаций показывает: в основной модели 90,8% ответов фиксировали новшество, однако полностью применяли его только 58,5%, а разрыв в 32,3 п.п. сохранялся у 14 моделей. Даже усиление заметности обновлений не дало значимого прироста в полном переносе новых правил в клиническую рекомендацию.
4 ноября 2026