Коротко: о чём вообще речь
В августе 2026 года на arXiv появилась работа с почти будничным названием — «Software Defined Dataflow System for Large-scale AI Acceleration». За ним стоит описание ускорителя Maia 200, и это не очередная итерация «ещё больше флопсов на ватт». Главная идея здесь архитектурная: авторы предлагают переставить акценты в том, как вообще устроен ИИ-чип.
Материал подан 25 августа 2026 года в раздел cs.AR, отправитель — Торстен Хёфлер, всего в списке авторов 17 человек (Шерри Сюй и ещё шестнадцать исследователей). Работа размечена сразу по нескольким рубрикам: аппаратные архитектуры, искусственный интеллект, распределённые и параллельные вычисления, новые технологии и машинное обучение. То есть заявка сделана не на «железячную» заметку, а на концепцию, которая касается всего стека.
Данные вместо команд: суть разворота
Классический ускоритель устроен вокруг потока команд. Есть ядра, есть планировщик, есть иерархия кэшей — и вся эта конструкция обслуживает исполнение инструкций. Память в такой модели играет роль обслуживающего персонала: подай данные вовремя, а дальше мы сами.
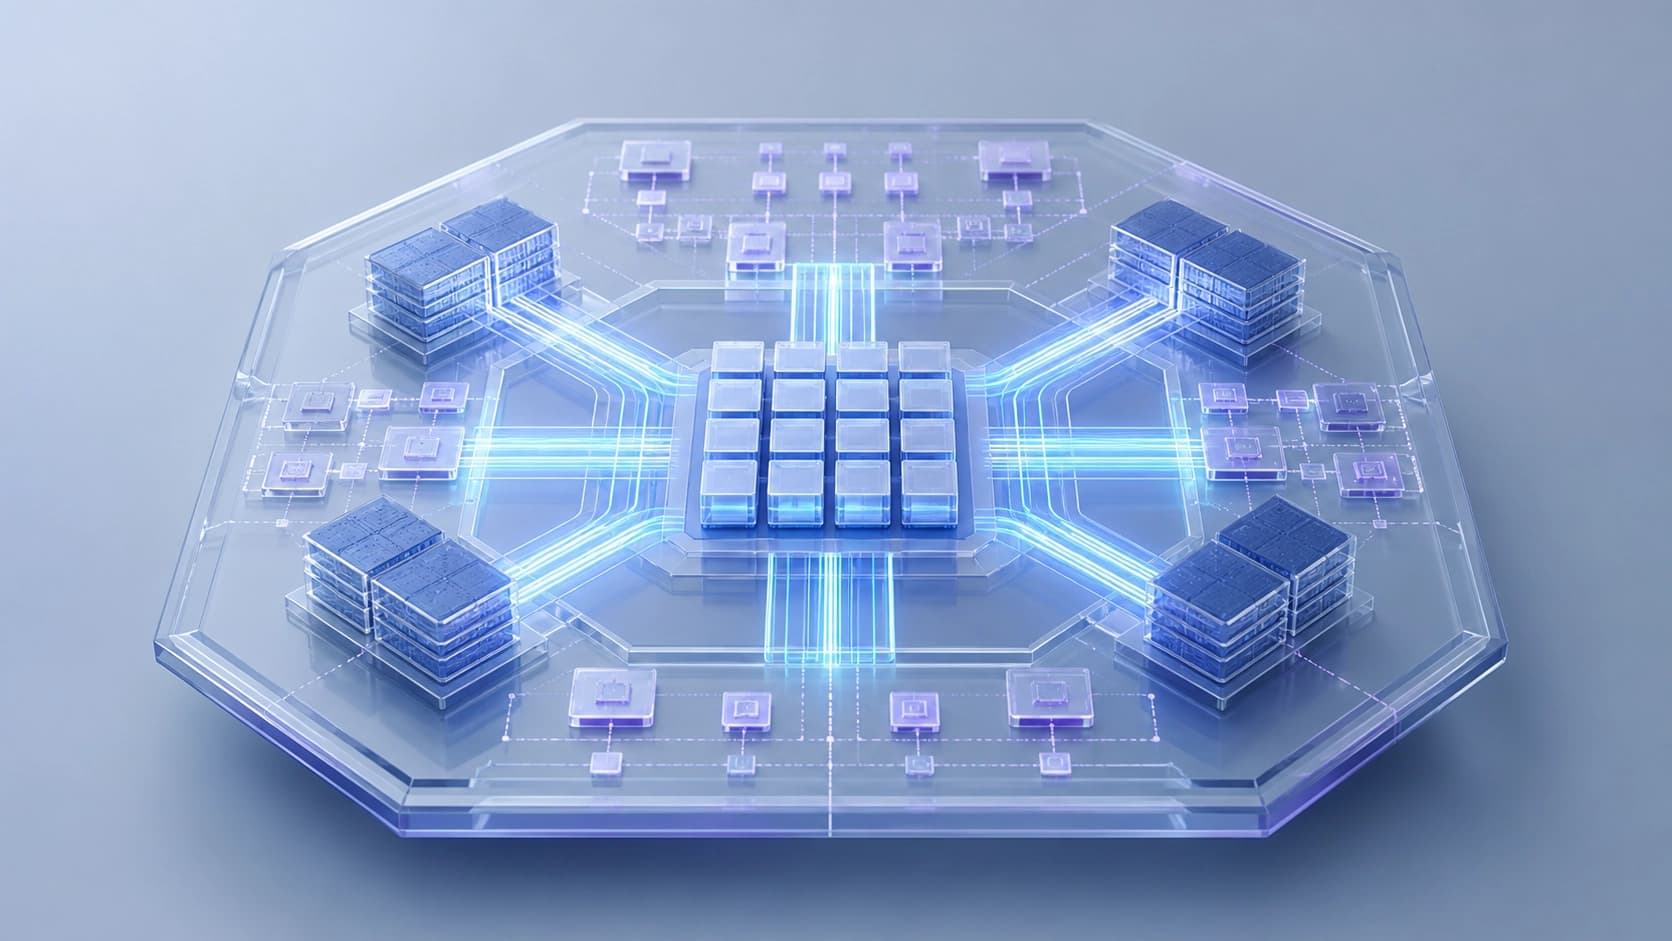
В Maia 200 логика переворачивается. Авторы относят чип к новому классу — Software Defined Locally Accessed Dataflow Architectures, сокращённо SDLA. Ключевое слово здесь «software defined»: dataflow-движки не просто существуют в кремнии, их явно программируют. Программист описывает, как именно должны оркестрироваться специализированные блоки памяти и движки перемещения данных. Управление становится явным, а не побочным эффектом конвейера.
Отсюда и смещение фокуса: не thread-centric, а data-movement-centric. Вопрос «сколько инструкций в такт» уступает вопросу «как быстро и без потерь данные доезжают туда, где их посчитают». Для современных рабочих нагрузок это принципиально разные постановки задачи.
Цифры
Сухие характеристики из аннотации выглядят так:
- 10 145 Tflop/s в формате FP4;
- 5072 Tflop/s в FP8;
- пропускная способность памяти HBM — 7 TB/s;
- тепловой пакет — 750 Вт.
Что эти цифры значат — и чего не значат
Соблазн сразу сравнить 10 145 Tflop/s в FP4 с чем-то знакомым велик, но сравнивать корректно не с чем: авторы не публикуют замеров на конкретных моделях, а разные форматы точности и разные методики замера дают несопоставимые числа. Отдельно стоит держать в голове, что очень низкая точность (FP4) — это всегда компромисс по качеству, и выигрыш в цифрах не равен выигрышу в полезной работе.
Куда интереснее здесь 7 TB/s. Именно эта характеристика рифмуется с главной идеей статьи: если архитектура построена вокруг перемещения данных, то пропускная способность памяти — не второстепенный параметр, а несущая конструкция. И 750 Вт — напоминание, что разговор идёт о стойке, а не о настольной карте.
SDLA и новая таксономия
Чтобы объяснить, чем такой чип отличается от привычных, авторы строят таксономию управления данными. Ориентир для неё — давняя классификация Флинна, которая делила машины по числу потоков команд и данных. Это был удобный язык для эпохи, когда узкое место лежало в исполнении.
Теперь, по мысли авторов, нужен другой язык — про то, как система распоряжается данными. Классификация получается не про «сколько», а про «как организовано». И в этой рамке SDLA занимает отдельную клетку: архитектура, где память и перемещение данных — первоклассные граждане, а не фон.
Практический смысл такой таксономии не в любви к схемам. Она даёт инженерам словарь: можно осмысленно спорить о том, к какому классу относится конкретное железо и какие задачи ему подходят, вместо того чтобы мерить всё одним числом.
Почему это важно для инференса
Инференс — это во многом про то, чтобы прокачать через чип огромные объёмы весов и активаций с минимальными задержками. Чем больше модель, тем сильнее упирается всё в память и в связи между блоками, а не в арифметику. Эффективность здесь определяется тем, насколько хорошо система умеет двигать данные.
Авторы утверждают, что Maia 200 даёт заметную экономию по затратам и энергии, поддерживая массовый параллелизм именно на инференсных нагрузках. Если это подтвердится на реальных задачах, а не только на синтетике, речь пойдёт о другом балансе: не «самый быстрый чип», а «чип, который дешевле прокормить на том же объёме запросов». Для дата-центров, где счёт идёт на мегаватты, это как раз тот аргумент, который перевешивает.
Что осталось за кадром
Аккуратность требует оговорок. Работа — это препринт: arXiv:2608.24664, DOI 10.48550/arXiv.2608.24664, доступны PDF, экспериментальная HTML-версия и исходники TeX. Рецензирование, независимые замеры и воспроизведение результатов — впереди. Обещания про экономию энергии и денег стоит читать как заявление авторов, а не как измеренный факт от третьей стороны.
Второй вопрос — цена перехода. Программируемый dataflow требует другого мышления: разработчику нужно явно описывать маршруты данных, а компиляторам и фреймворкам — научиться это использовать. Пока экосистема не догонит, преимущества железа будут видны не всем и не сразу. Так было с любой архитектурной сменой вех: сначала концепция, потом инструменты, потом массовое принятие.
И всё же главное в этой истории — не конкретные терафлопсы. Важнее сама формулировка: узкое место ИИ-вычислений сместилось туда, где данные путешествуют, а не туда, где выполняются команды. Если эта мысль верна, чипы следующих поколений будут проектировать иначе — и, возможно, именно с этой работы начнётся отсчёт.