Вложенные данные и старая проблема причинного вывода
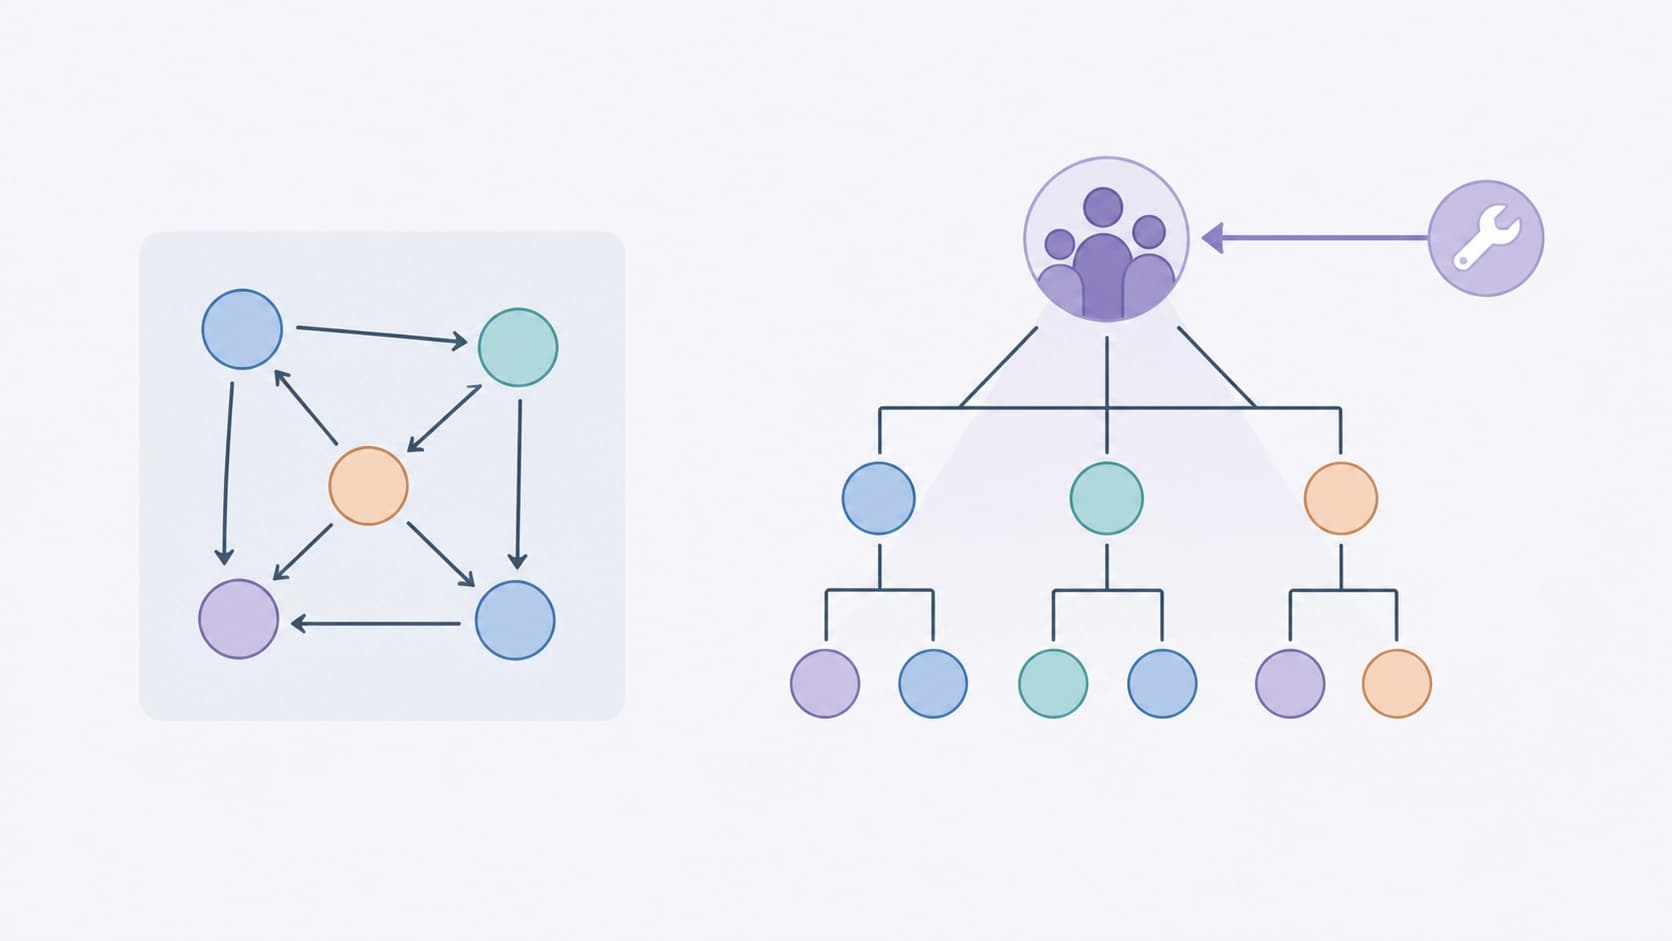
Классические методы причинного вывода неплохо работают, когда наблюдения независимы друг от друга. Но стоит данным получить иерархию — ученики внутри классов, пациенты внутри клиник, сотрудники внутри отделов — и наивная схема начинает обманывать. Общая группа создаёт корреляцию между объектами, которую модель ошибочно принимает за сигнал, а вмешательства, происходящие на верхнем уровне (например, изменение условий в целом классе), вообще некуда «подключить».
Именно об этом новый препринт arXiv:2608.24500 в разделе stat.ML — «Scalable and Versatile Identification for Hierarchical Structural Causal Models: A New Look at Project STAR». Работа вышла 25 августа 2026 года, её подготовила группа из девяти авторов — Janis Aiad, Aghiles Drali, Aymen El Ouadrhiri, Anass Ettahiri, Yasser Oufqir, Simon Patry, David Cortes, Marianne Clausel и Emilie Devijver. Доступны PDF, HTML-версия и исходники TeX; тематика — машинное обучение и искусственный интеллект.
Материал интересен не столько очередной моделью, сколько попыткой собрать полный, воспроизводимый конвейер: от формальной записи графа до конкретного числа, которое можно защищать в статье или отчёте перед заказчиком.
Что предлагают авторы
Речь идёт о пайплайне для иерархических структурных причинных моделей (HSCM). Он открытый и задуман как масштабируемый: одна и та же логика должна выдерживать и маленький учебный пример, и данные с большим числом групп.
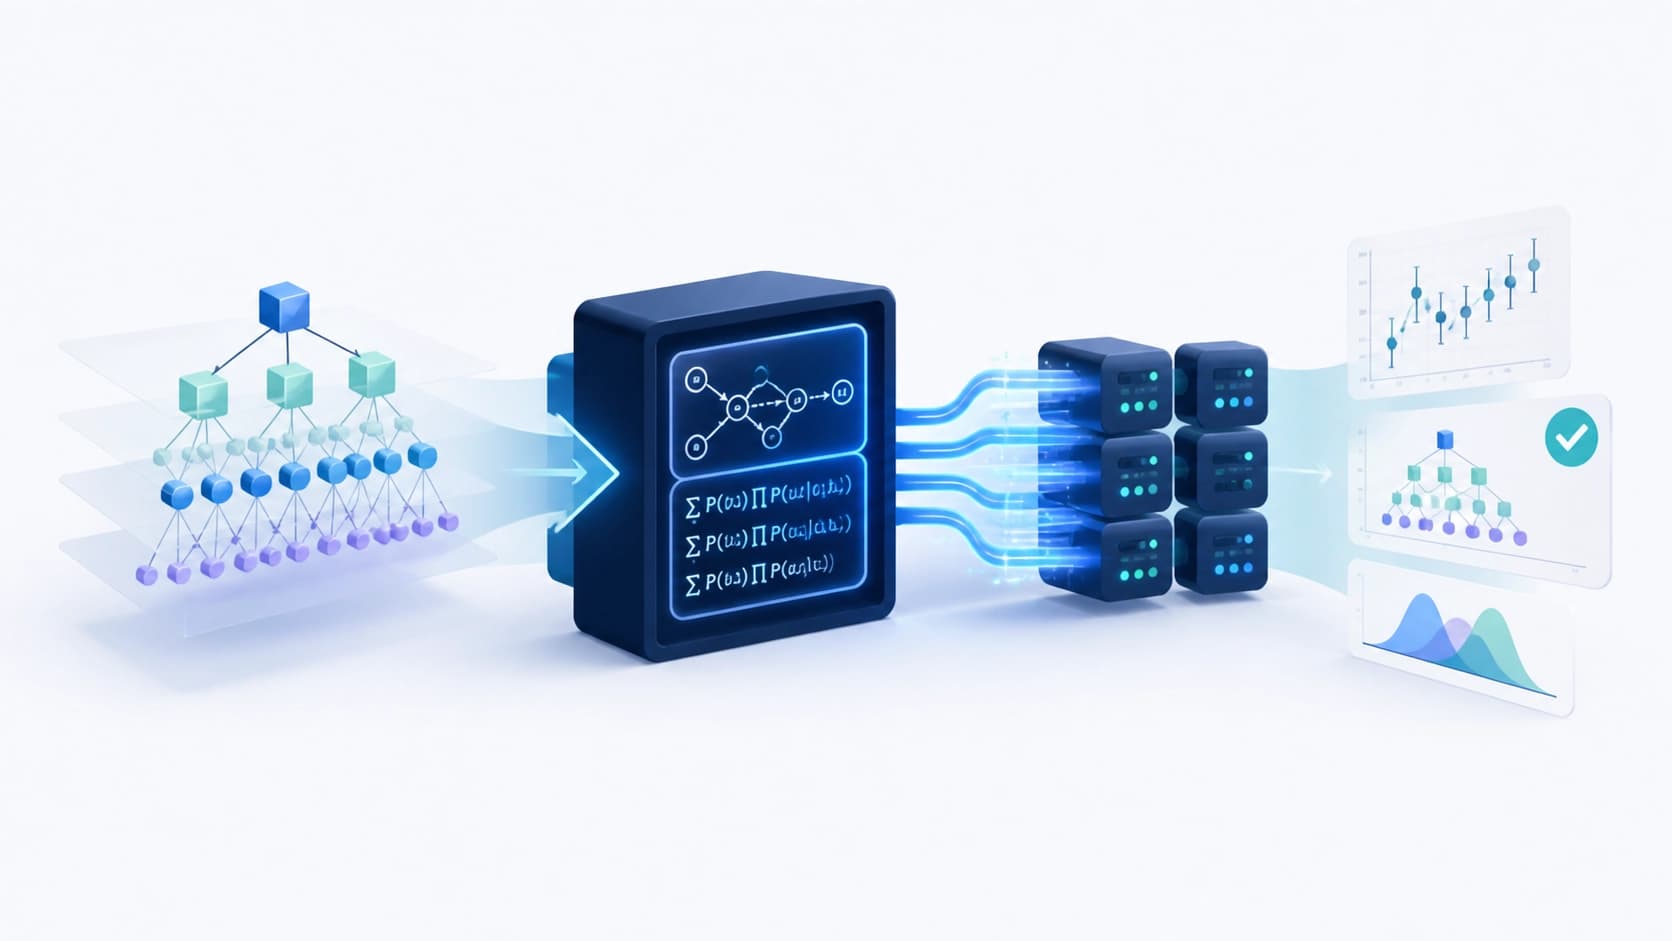
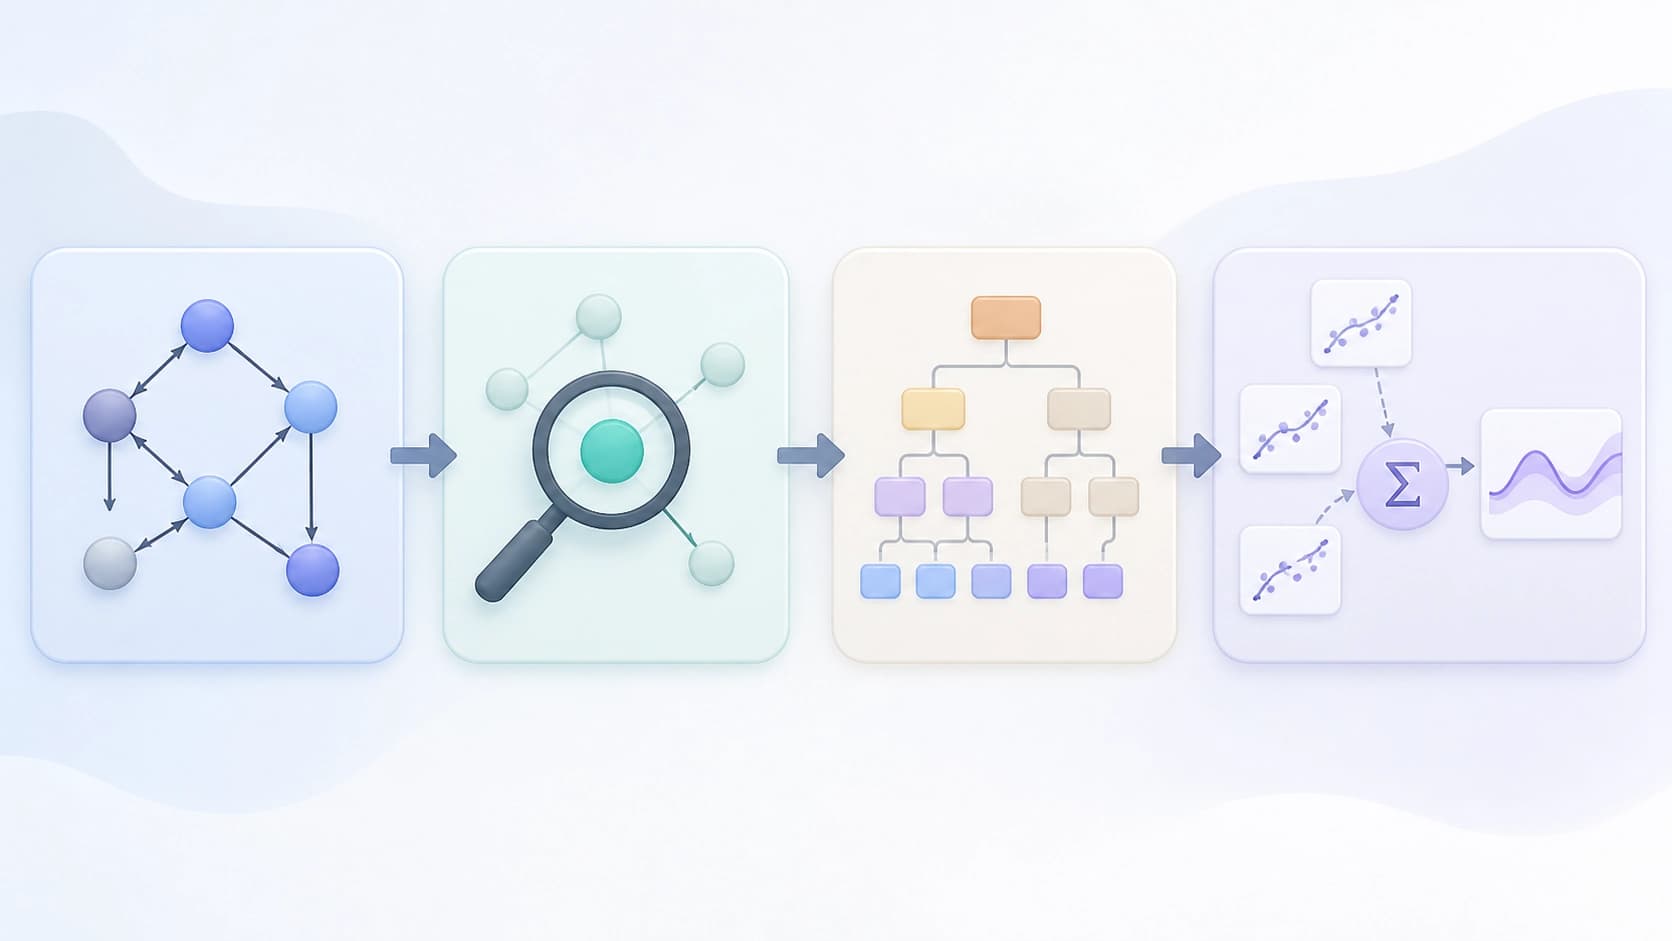
Конструкция собирается из четырёх слоёв:
- графовые преобразования — подготовка структуры, описывающей зависимости между уровнями;
- символьная идентификация через do-calculus в библиотеке pyAgrum — машина сама определяет, какие эффекты вообще выводимы из доступных данных, и выдаёт соответствующее выражение;
- перевод этого выражения в замкнутые формулы HSCM — символьный результат превращается в нечто вычислимое в рамках иерархической модели;
- численное оценивание по уже подогнанным локальным вероятностным моделям.
Логика здесь принципиально двухступенчатая. Сначала выясняется, идентифицируем ли эффект в принципе — это вопрос математики, а не данных. И только потом включается статистика: оценка, погрешность, устойчивость.
Абстрактное синтаксическое дерево как ключ к масштабу
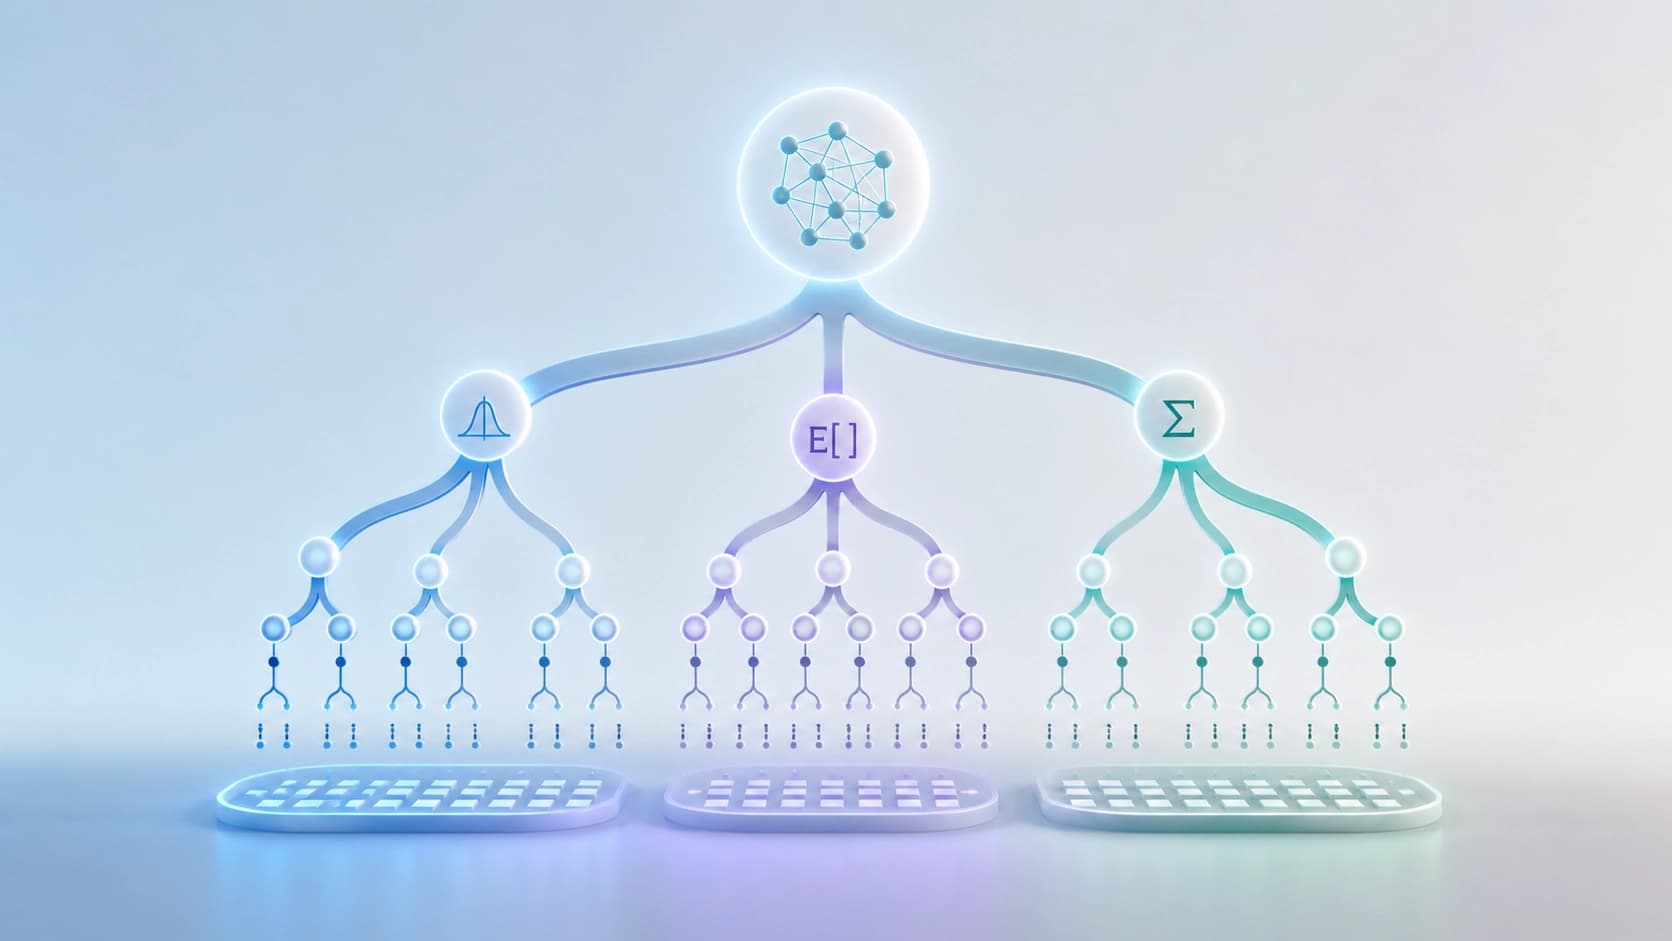
Главная техническая находка работы — адаптированное абстрактное синтаксическое дерево (AST). Идентифицированная формула из pyAgrum не вычисляется «в лоб»: она раскладывается на дерево, а листья этого дерева становятся независимыми подзадачами трёх типов — расчёт плотности, вычисление математического ожидания и маргинализация.
Почему это важно? Полученные подзадачи можно считать параллельно и кэшировать промежуточные результаты. Вместо одного громоздкого выражения, где ошибка на раннем шаге портит всё дальше, появляется набор независимых кусков, каждый из которых проверяем отдельно. По сути, авторы превращают проблему вычислительной мощности в проблему организации вычислений.
Проверка на Project STAR
В качестве содержательного примера взят эксперимент STAR (Student-Teacher Achievement Ratio), проведённый в 1985 году в штате Теннесси, США. Это эталонный иерархический набор данных: он создавался, чтобы оценить влияние размера класса на успеваемость, а наблюдения в нём вложены в классы. Такая структура — идеальный полигон для HSCM, потому что вмешательство здесь естественно происходит на уровне класса, а не отдельного ребёнка.
Прежде чем переходить к реальным данным, авторы проверяют пайплайн на канонических мотивах HSCM и бенчмарк-сценариях, где истинный ответ известен заранее. Это разумный порядок: сначала убедиться, что метод находит правильный ответ там, где его знают, и лишь затем применять к данным, где проверять нечем. Финальное применение — результаты по математике в детском саду в рамках STAR.
Что показали результаты
Выводы получились отрезвляющими, и в этом их ценность.
Во-первых, плоские базовые модели, игнорирующие иерархию, ассоциации восстанавливают — но закодировать вмешательство на уровне класса не способны. Корреляция «меньше класс — выше баллы» и причинный эффект от сокращения класса — разные вещи, и первая не заменяет второй.
Во-вторых, одной символьной идентификации недостаточно. Даже если формула корректно выведена, для практического иерархического вывода нужен работающий численный слой.
Отсюда третий тезис: масштабируемое оценивание и проверки численной устойчивости — не приложение к методу, а его центральная часть. Красивое выражение, которое невозможно посчитать или которое разваливается от малейшего изменения данных, научной ценности не несёт. Поэтому в пайплайне столько внимания уделено декомпозиции вычислений и контролю устойчивости.
Зачем это нужно за пределами STAR
Иерархические данные встречаются куда чаще, чем кажется. Образование, медицина, A/B-тесты с кластеризацией, соцопросы по регионам, промышленные измерения по партиям — везде есть вложенность, и везде есть соблазн её проигнорировать ради простоты.
Ценность работы в том, что она предлагает не отдельный трюк, а воспроизводимую процедуру. Открытый код, автоматическая идентификация через pyAgrum, формальный переход к вычислимым формулам, независимые подзадачи — всё это вместе снижает порог входа: исследователю не нужно самому выводить формулы для каждой новой структуры графа.
Ограничения и здравый смысл
Стоит помнить, что перед нами препринт, а не прошедшая рецензирование публикация: arXiv:2608.24500 в версии v1, DOI 10.48550/arXiv.2608.24500. Результаты на канонических мотивах и одном наборе данных — хорошая проверка, но не универсальное доказательство.
Кроме того, любой причинный вывод опирается на предположения о структуре графа. Пайплайн автоматизирует вычисления и делает их прозрачнее, но не отменяет вопроса «а правильно ли мы вообще описали мир». Если граф неверен, аккуратно посчитанный эффект всё равно останется аккуратно посчитанным заблуждением.
Именно поэтому главный практический итог статьи звучит приземлённо: идентификация без оценивания бесполезна, оценивание без устойчивости — рискованно, а вложенные данные требуют отдельного уровня в модели, иначе вмешательства на уровне групп просто не с чем соотнести.