
FlightLLM: как семантические языковые модели помогают объяснять причины авиационных инцидентов
Новый подход FlightLLM сочетает статистические модели и большие языковые модели, чтобы превращать данные полетов в понятные объяснения действий пилота. Испытания на реальных данных Airbus A320 показали, что метод дает точные классификации и внятные формулировки причин жесткой посадки.
Зачем объяснять авиационные инциденты?
Безопасность полётов напрямую зависит от того, насколько точно мы понимаем причины нештатных ситуаций. Мало обнаружить опасное событие вроде жёсткой посадки — нужно разобраться, какие действия экипажа и параметры полёта привели к такому исходу. Без этого сложно выработать рекомендации и предотвратить повторение ошибок.
Традиционные методы объяснимого ИИ, например карты важности признаков, показывают, какие факторы повлияли на решение, но требуют серьёзных доменных знаний от аналитика. Языковые модели умеют строить связные текстовые описания, но при работе с авиаданными возникают трудности: числовые показатели с датчиков и текстовые отчёты плохо стыкуются, модели слабоваты в классификации, а размеченных данных для дообучения мало.
Что такое FlightLLM?
Авторы исследования предлагают подход FlightLLM, который объединяет сильные стороны статистических алгоритмов и больших языковых моделей. Задача — не только определить, что произошло, но и объяснить, почему. Числовой «эксперт» отвечает за анализ параметров, а языковая модель генерирует понятное человеку объяснение.
Решение состоит из нескольких блоков. Сначала инженерия признаков: к данным с датчиков добавляются статистические характеристики и физически значимые показатели, чтобы сгладить разрыв между числовым и текстовым представлением. Затем модуль семантической дискретизации превращает числовые паттерны в качественные описания вроде «резкое снижение вертикальной скорости». Дополнительно используется CatBoost как статистический эксперт — его прогноз попадает в промпт и служит ориентиром для языковой модели.
Как устроен процесс объяснения?
На вход системе подаются записи полёта. После извлечения признаков и семантической дискретизации числовые данные обретают более «человеческий» вид. Далее CatBoost выдаёт предварительную оценку события, которая вместе со структурированным промптом и авиационными знаниями передаётся большой языковой модели. Промпты построены так, чтобы модель видела и правильные, и ошибочные примеры — это контрастивная few-shot стратегия. В результате модель выдаёт объяснение, которое напрямую указывает на вероятные причины, а не просто перечисляет коррелирующие признаки.
На чём проверяли FlightLLM?
Эксперименты проводились на реальных данных: 704 образца полётов A320. В качестве целевого события выбрали жёсткую посадку.
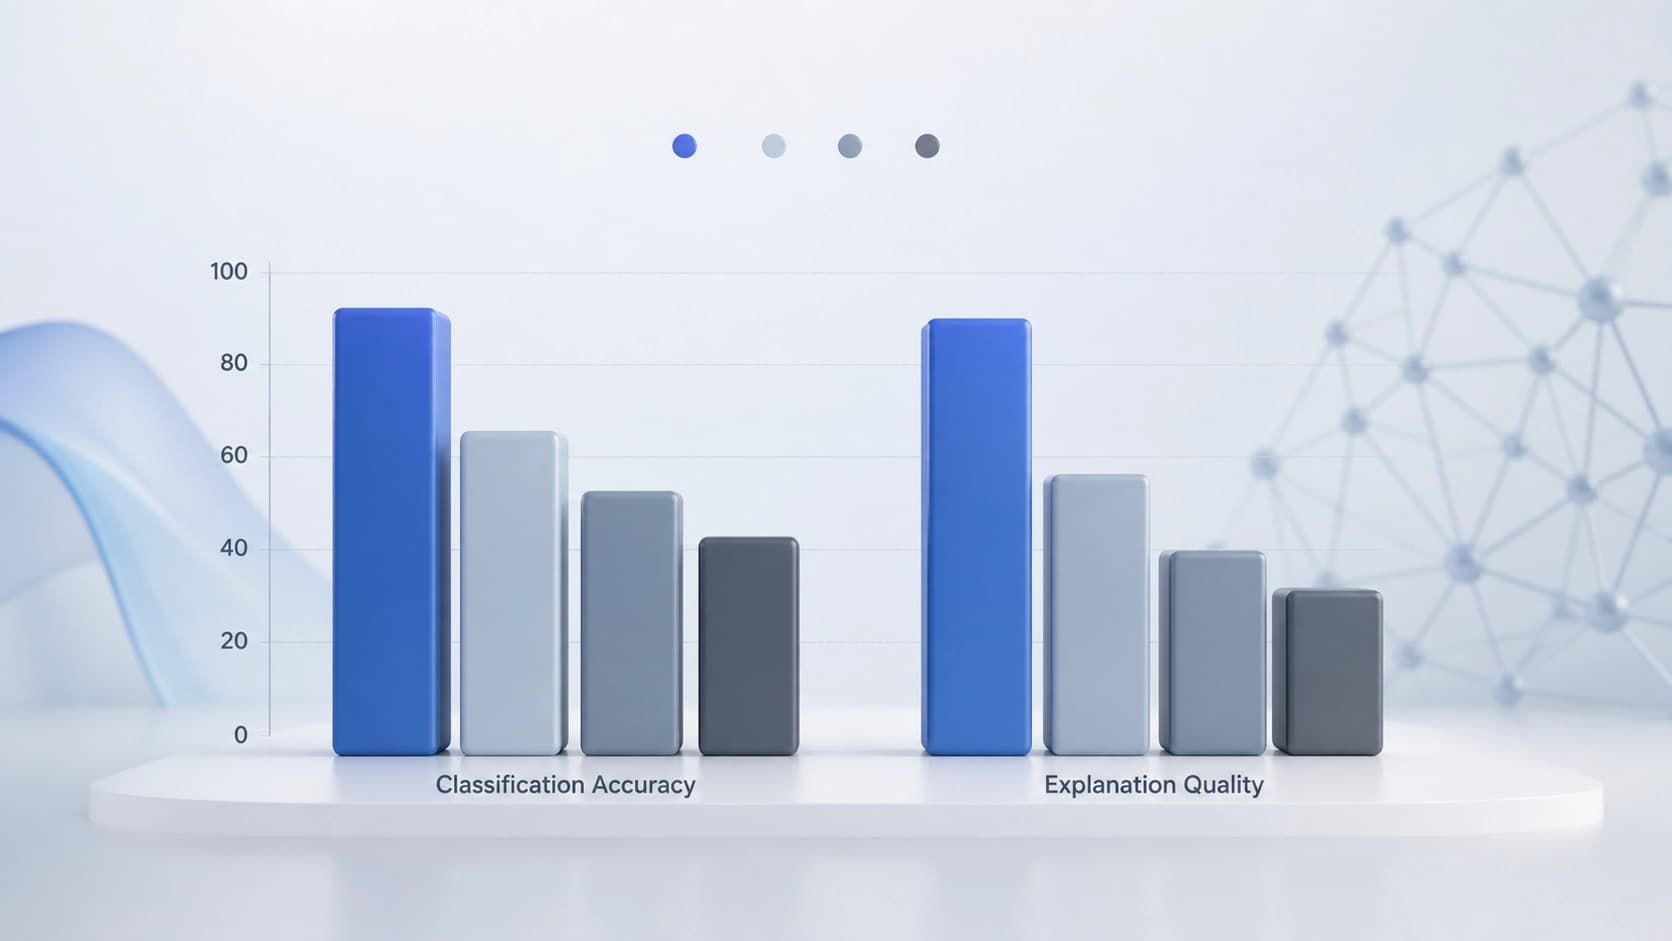
Результаты показали, что FlightLLM достигает конкурентоспособной точности классификации и при этом даёт прямые и логичные объяснения причин инцидентов. То есть метод не только не проигрывает специализированным классификаторам, но и добавляет важную для разбора полётов интерпретацию.
Почему это важно
Объяснимость в авиации — это не роскошь, а необходимость. Пилоты и аналитики получают инструмент, который помогает превращать сырые данные в понятные сценарии развития событий. В будущем такие системы могут стать частью стандартных процедур расследования инцидентов и тренировки экипажей.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Канонические полиномиальные инварианты в диагностике сбоев RL-симуляторов: где они действительно полезны
Работа проверяет, оправдано ли включение физических законов в обучаемые модели динамики: инварианты, извлечённые из траекторий и приведённые к каноническому виду через базисы Грёбнера, дают скромный выигрыш в прогнозах, но оказываются сильны в диагностике — они позволяют локализовать нарушенное ограничение и выявить конкретный ошибочный параметр.
10 ноября 2026
AURA-Eval: как проверить, что LLM-агент распознал риск и изменил следующий шаг
Фреймворк оценивает поведение LLM-агентов не по финальному вердикту, а по реакции на риск в ключевых точках: траектории вызовов инструментов прерываются, после чего модель должна продолжить рассуждение и действие, а панель LLM-судей разбирает обнаружение риска, характер и безопасность шага. На 1249 заданиях, собранных из 157 траекторий R-Judge, у 20 моделей небезопасные действия учащаются при отсутствии безопасного пути, а снятие надзора до выполнения переводит 52,3% изначально безопасных случаев в небезопасные.
10 ноября 2026
Память резервуара Черна — Саймонса: самостоятельная динамика связности и перенос плотности
В статье разбирается, как резервуар сохраняет историю входных сигналов одновременно в распределении плотности и геометрических степенях свободы. Сравнение четырёх механизмов показывает, что ток создаёт отдельную компоненту связности, меняющую последующий отклик плотности, а учёт всех измеренных признаков даёт небольшой прирост в декодировании порядка импульсов.
10 ноября 2026