Проверяемая награда и её слепая зона
Обучение с подкреплением на основе проверяемых вознаграждений стало привычным рецептом для языковых моделей: есть задача с однозначно проверяемым ответом — математика, код, вопросы с коротким ответом — и есть сигнал «решил / не решил». Схема работает, но у неё есть известная слабость. Итоговая награда оценивает результат целиком, а не путь к нему. Модель может получить балл за верный вывод, построенный на выдуманных посылках, и точно так же потерять балл за корректное рассуждение с неудачной финальной формулировкой.
Именно здесь и живёт риск галлюцинаций. Если награда зависит только от финального совпадения, у политики нет стимула быть аккуратной по дороге — достаточно угадать ответ. Один из способов это исправить — добавить фактический контроль на уровне процесса: проверять промежуточные утверждения, а не только итог.
Но у process-level подхода обнаруживается собственная проблема. Проверки фактов собираются и усредняются укрупнённо: сигнал приходит пачкой на весь фрагмент, а достоверность самих проверок никто не оценивает. В результате между тем, что реально проверили, и тем, что реально обновили в политике, возникает зазор.
Две неоднозначности вместо одной проблемы
Авторы работы arXiv:2608.24350 (Qiming Xie, Wenjie Zheng, Xiangqing Shen, Rui Xia) дают этому зазору имя — «шумное фактическое присвоение кредита» (noisy factual credit assignment) — и раскладывают его на два независимых аспекта.
- Неоднозначность локализации кредита. Непонятно, какому именно токену или фрагменту приписывать заслугу или вину. Факт проверили на уровне предложения, а обновление идёт на уровне токена — гранулярности не совпадают, и сигнал размазывается.
- Неоднозначность достоверности кредита. Непонятно, насколько самой проверке можно верить. Одни фактические суждения надёжны и воспроизводимы, другие — шаткие, зависят от контекста или от конкретной формулировки. Без веса доверия они входят в обучение на равных правах.
Второй аспект — самый недооценённый. Обычные схемы обращения с фактическими сигналами ведут себя так, будто все проверки одинаково качественные. На практике это не так, и слабые проверки начинают портить оптимизацию наравне с сильными.
Как устроен FARCA
FARCA расшифровывается как Fact-Aligned Reliability-Aware Credit Assignment — присвоение кредита с опорой на факты и с учётом их надёжности. Это не новая модель и не датасет, а фреймворк оптимизации политики: он перестраивает то, как фактический контроль превращается в обучающий сигнал.
Согласовать гранулярности
Первый шаг — мелкозернистая локализация кредита. Идея простая по формулировке и нетривиальная по реализации: гранулярность проверки фактов нужно привести в соответствие с гранулярностью обновлений политики. Тогда фактический сигнал приходит не «на весь ответ средним числом», а привязывается к конкретным токенам, которые действительно за это утверждение отвечают. Вместо размытого усреднения политика получает точечные указания.
Оценить, насколько проверке можно верить
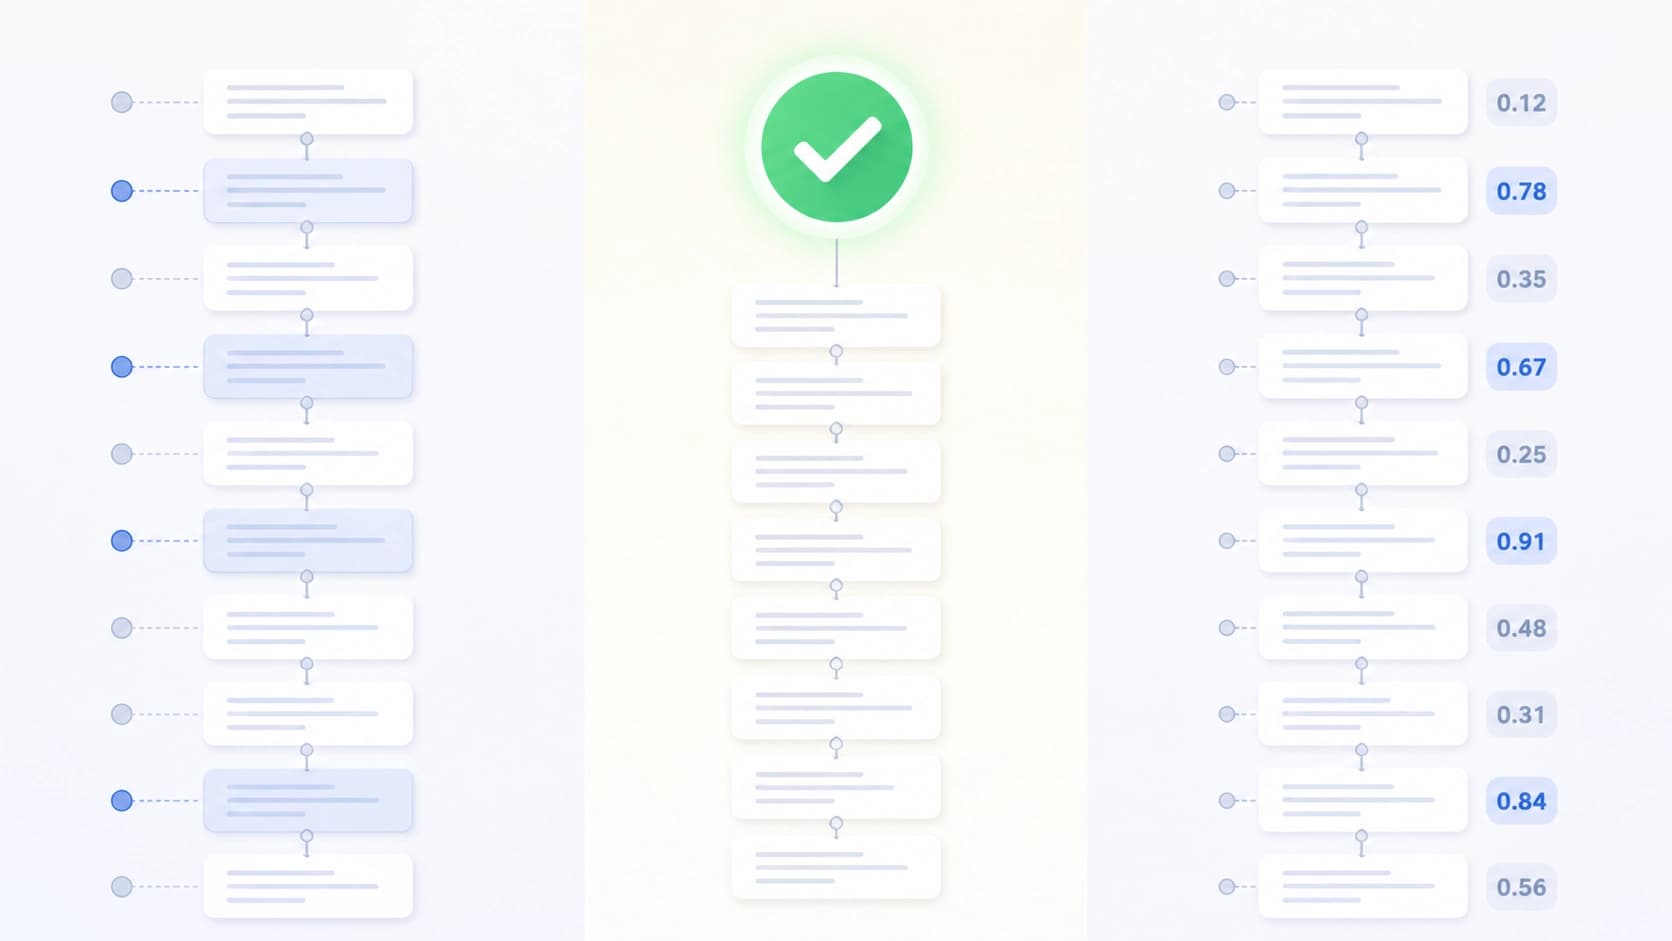
Второй шаг — веса достоверности. Для их вычисления авторы вводят контрафактуальную атрибуцию свидетельств (counterfactual evidence attribution): смотрят, насколько фактическое суждение зависит от ключевого фрагмента-свидетельства. Если убрать или заменить это свидетельство и вердикт меняется — значит, проверка действительно на него опирается, и такой сигнал заслуживает большего доверия. Если вердикт остаётся прежним независимо от свидетельства, суждение, скорее всего, не о том, о чём мы думаем, — и его вес падает.
Полученные веса дальше модулируют фактические вознаграждения и локальные преимущества политики. Практический смысл: потенциально недостоверные сигналы получают меньший голос при обновлении, а не блокируются полностью. Это мягкая фильтрация вместо жёсткого отсева — политика не теряет информацию, но перестаёт слепо ей следовать.
Что показывают эксперименты
Авторы проверяли подход на разных моделях и нескольких бенчмарках, оценивающих фактическое рассуждение. Заявленный результат — заметный рост фактичности при сохранении общих способностей к рассуждению. Последняя часть здесь не менее важна первой: улучшения в фактичности часто покупаются ценой деградации других навыков, когда модель становится осторожнее и одновременно слабее. Здесь этого, по данным авторов, не происходит.
Отдельно стоит отметить, что метод остаётся в парадигме RL с проверяемыми наградами — он не требует отказываться от существующего пайплайна и не заменяет его чем-то принципиально другим. Он встраивается как слой между проверкой фактов и обновлением политики.
Что из этого следует
Главная мысль работы шире одной архитектуры. Разговор о фактичности моделей обычно идёт в логике «проверять или не проверять». Но когда проверки уже есть, ключевой вопрос смещается: как именно их результат превращается в обучение. Ошибка на этом стыке не выглядит как ошибка, она выглядит как обычный шум обучения — и потому легко остаётся незамеченной.
Признание того, что источникам доверяют не одинаково, кажется почти тривиальным на уровне здравого смысла. Но в схемах обучения с подкреплением это до сих пор редкость: сигналы складываются в общий котёл, и разница между надёжным свидетельством и случайной догадкой стирается. FARCA — попытка вернуть эту разницу в формулу. Насколько подход окажется переносимым за пределы задач с проверяемым ответом, где факт нельзя так просто подтвердить или опровергнуть, — открытый вопрос, и он же самое интересное направление для следующих работ.