Почему общий скеч не работает для страниц
Обслуживание больших языковых моделей на длинном контексте упирается в key-value (KV) cache. Кэш читается целиком на каждом шаге декодирования. Attention keys являются locally low-rank, хотя globally high-rank. Фиксированный low-rank sketch, общий для страниц, доказуемо слеп к страничным направлениям.
При том же размере summary собственный базис страницы ранжирует страницы и сохраняет носители гораздо лучше. Общий скеч не видит эти направления. Покейный спектральный summary решает проблему.
Спектральная сводка на каждую страницу
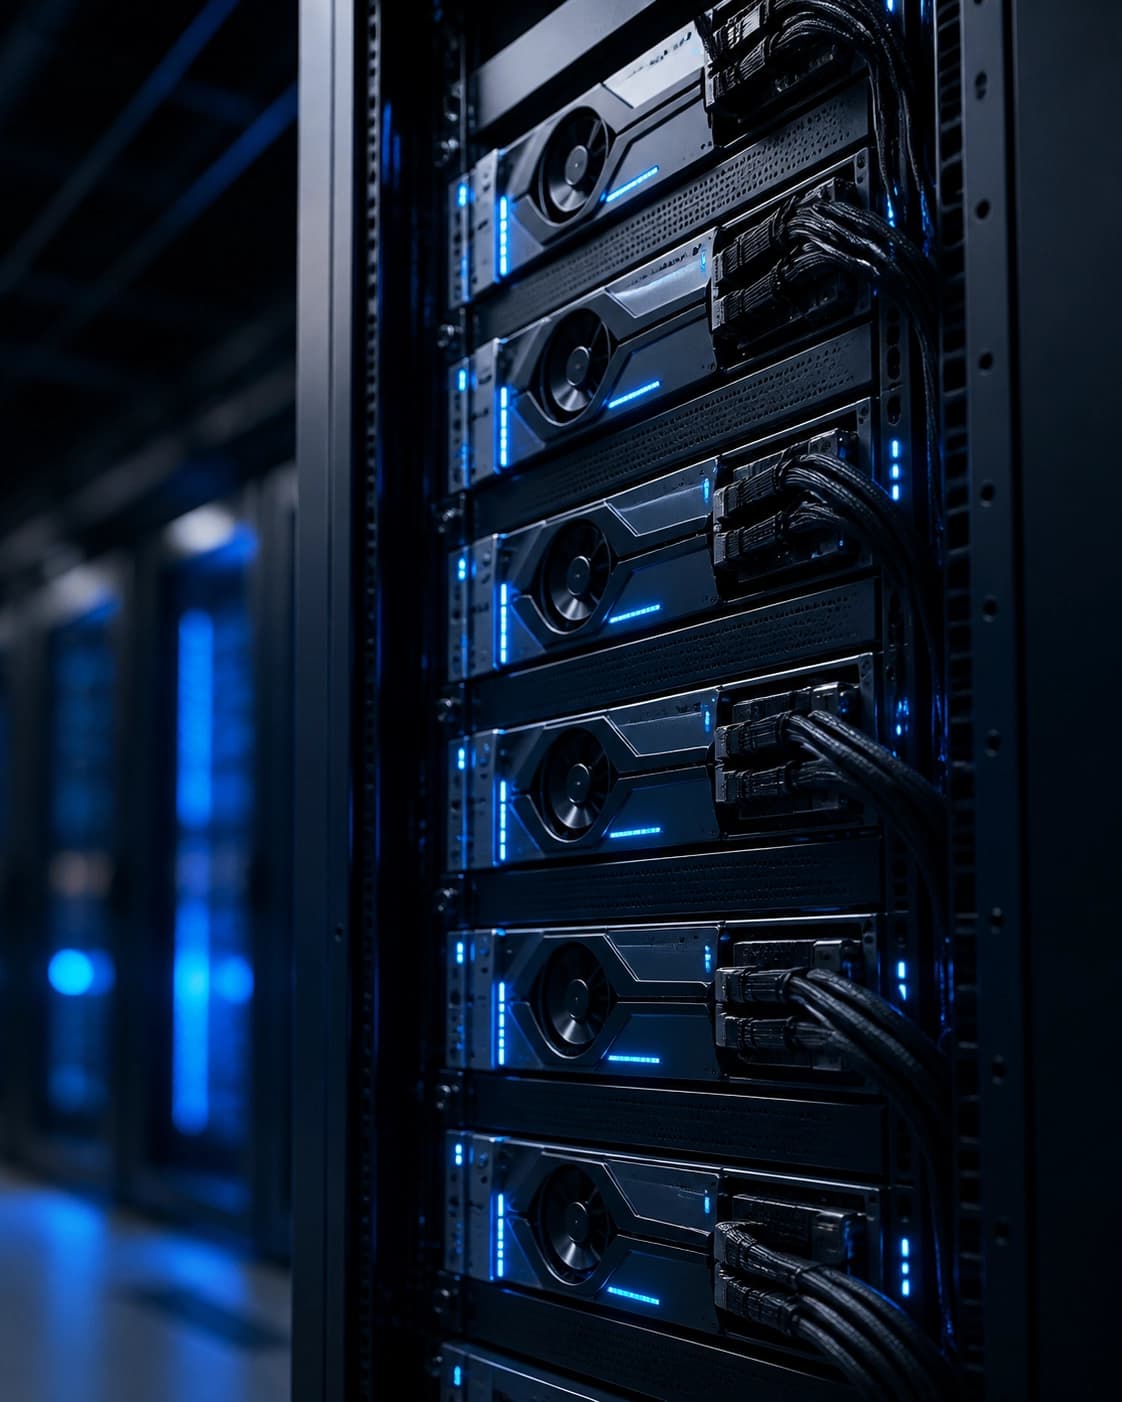
LOCKS даёт каждой странице собственный rank-r spectral summary. Сводка резидентная: одна десятая кэша при r=8 и одна двадцать пятая при r=2. Метод реконструирует внутристраничные логиты. Он оценивает массу внимания каждой страницы через log-sum-exp. Затем обрабатывает только верхние страницы.
Ключевые элементы:
- Название: Page-Local Compact Key Summaries for Efficient Long-Context Decoding.
- Сводка: rank-r spectral summary для каждой страницы.
- Резидентность: одна десятая кэша при r=8, одна двадцать пятая при r=2.
- Реконструкция: внутристраничные логиты.
- Оценка: масса внимания страницы через log-sum-exp.
- Отбор: только верхние страницы.
Вывод: сводка занимает долю кэша, но сохраняет страничные признаки. Отбор страниц идёт по спектральным данным.
Отбор блоков без чтения ключей
Сам отбор не читает ключи или значения кандидатов. Выбор идёт только по спектральной сводке. Сводка сканируется полностью на каждом шаге. Чтение KV на шаг падает в 10–25 раз в указанном диапазоне рангов.
Задержка декодирования на токен уменьшается вдвое. При 1M токенов на одном H200 NVL ускорение составляет 2.0× при r=8. Это сравнение с плотным вниманием. Отбор не зависит от чтения ключей кандидатов.
Качество на длинных задачах
LOCKS сохраняет качество на нескольких типах задач. На long-document QA (LongBench-v1; Llama-3.1-8B) результат остаётся в пределах одного пункта от полного кэша. На retrieval-dense RULER метод следует точному LSE-оракулу, читающему каждый ключ, вплоть до самых малых бюджетов. На long-form reasoning (AIME26, MATH-500; Qwen3-4B) качество держится дальше всех в режиме малых бюджетов. Селекторы и компрессоры рассуждений на основе вытеснения там отступают.
При бюджете 2048 токенов LOCKS совпадает с агрегированным качеством FullKV на контексте 100K+ (GLM-4-9B-Chat-1M). При этом метод обрабатывает 2% токенов.
| Условие | Результат |
|---|---|
| Long-document QA (LongBench-v1; Llama-3.1-8B) | в пределах одного пункта от полного кэша |
| Retrieval-dense RULER | следует точному LSE-оракулу до малых бюджетов |
| Long-form reasoning (AIME26, MATH-500; Qwen3-4B) | держит качество дальше всех в малых бюджетах |
| 2048-токенный бюджет, 100K+ контекст (GLM-4-9B-Chat-1M) | совпадает с FullKV, обрабатывает 2% токенов |
Вывод: на перечисленных задачах подход сохраняет качество дольше, чем селекторы и eviction-based компрессоры.
Внедрение и критерий выбора
Подход поставляется как drop-in плагин для немодифицированного vLLM. Пакетное декодирование работает в полных CUDA-графах. Модификация vLLM не требуется.
Критерий выбора: длинный контекст, ограниченный бюджет токенов, потребность снизить чтение KV и задержку декодирования. Если задача требует отбора блоков без чтения ключей кандидатов, подход подходит.