Полное дообучение перестало быть разумной опцией
Фундаментальные модели для электроэнцефалографии обучают без разметки — на контрастивных задачах или на восстановлении замаскированных фрагментов сигнала. Логика такая: модель набирается общих закономерностей ритмов, артефактов и переходов между состояниями, а затем её доучивают под узкую задачу вроде поиска эпилептических разрядов. В теории это даёт представления, которые переносятся между клиниками и аппаратурой. На практике всё сложнее: клинические архивы записей слишком непохожи друг на друга, и качество переноса заметно проседает.
Вторая проблема — экономика. Классический файнтюнинг обновляет все веса, а значит требует серьёзных вычислительных ресурсов на каждую новую задачу. В отделении без GPU-кластера такой сценарий просто не запускается. Отсюда и вопрос, вокруг которого построена работа arXiv:2608.24727: можно ли обойтись малой долей параметров и при этом не потерять в качестве?
Девять процентов: что именно настраивают
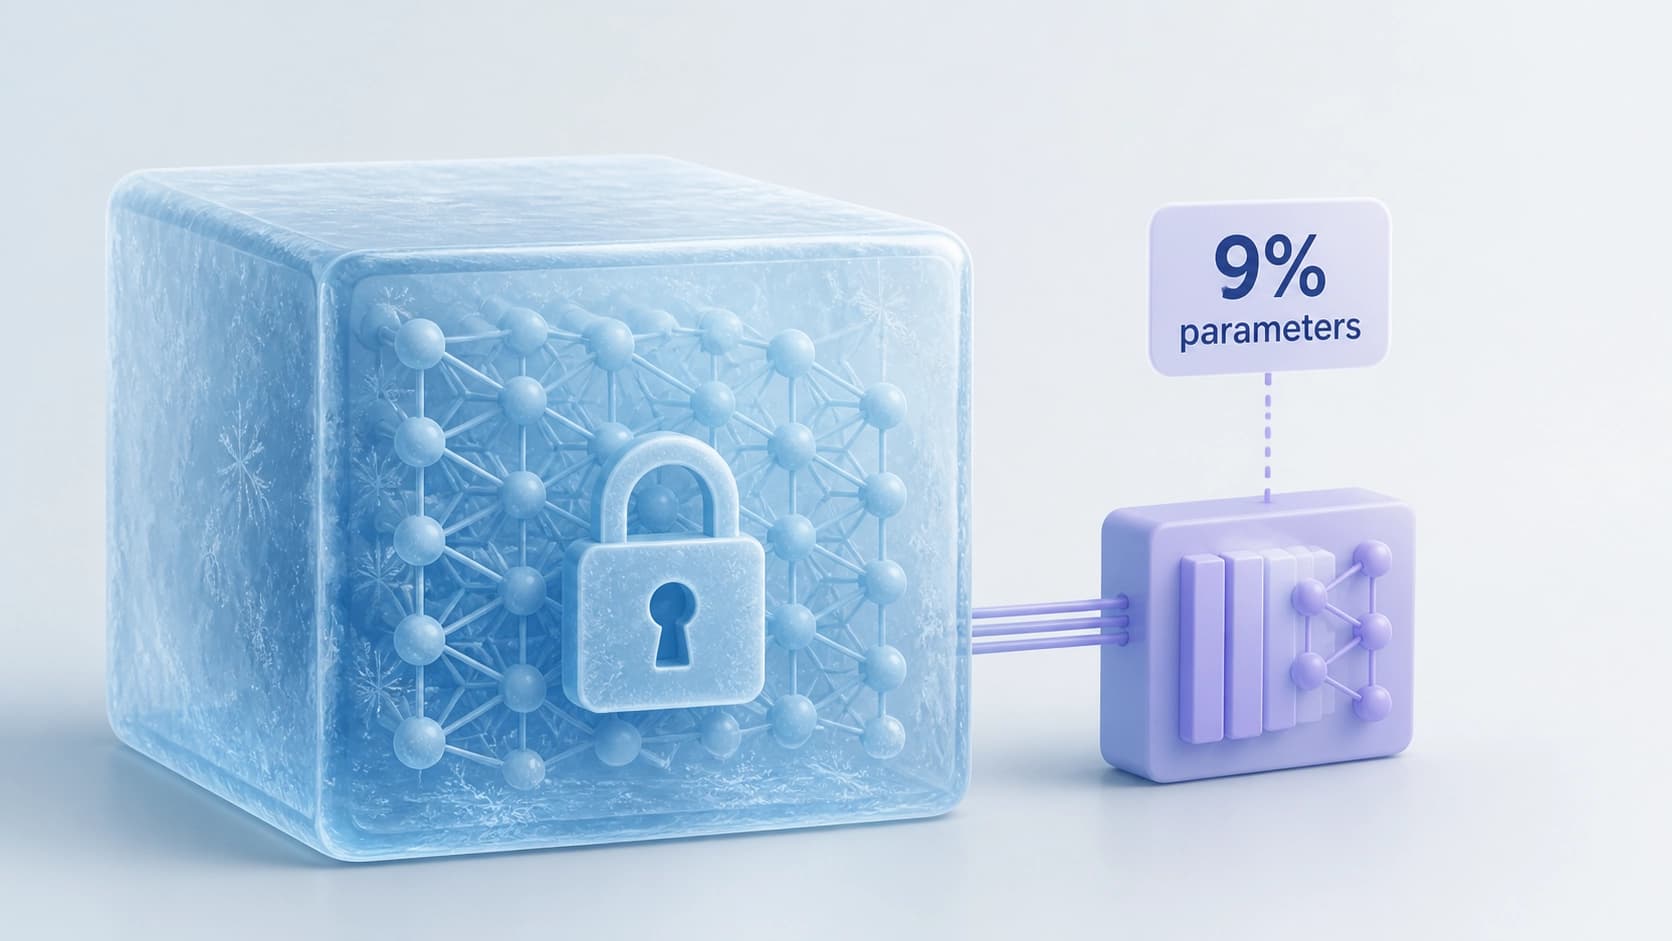
Авторы препринта — Meghal Dani и Stefanie Liebe. Они проверяют режим, в котором обучаемыми остаются примерно 9% весов, а остальная часть модели заморожена. Адаптация идёт в самообучающемся ключе: модель не просто подгоняют под метки класса, а выравнивают внутренние представления под целевую задачу. Текст выложен 25 августа 2026 года (версия v1), отнесён к разделам cs.LG и cs.AI, DOI — 10.48550/arXiv.2608.24727. Код открыт для воспроизведения.
Смысл не в том, что получилась «урезанная» модель. Это другой режим эксплуатации: тяжёлый предобученный энкодер остаётся неизменным, а под каждую новую задачу настраивается компактная надстройка. Для клиники такое разделение принципиально — дорогое предобучение делается один раз, дешёвая адаптация повторяется сколько угодно раз.
Две модели с разными целями предобучения
Чтобы результат не зависел от одной удачной архитектуры, в эксперименте участвуют две SOTA-модели: BIOT с контрастивной целью и CBraMod, обученная восстановлению замаскированных участков. Если приём срабатывает в обоих случаях, речь идёт не о совпадении, а о свойстве подхода.
Три клинических набора и два режима проверки
Оценка ведётся на TUAB (обнаружение аномалий), TUEV (классификация событий) и CHB-MIT (детекция приступов). Замеры делают дважды — in-distribution и out-of-distribution, то есть проверяют не только на «своих» данных, но и на сдвинутом распределении.
Что показали результаты
- Против линейного зондирования самообучающаяся адаптация даёт устойчивый прирост — вплоть до 20-кратного по AUCPR. Это не «чуть лучше», а разница в порядке величины, и она особенно заметна там, где редкий класс важнее общего accuracy.
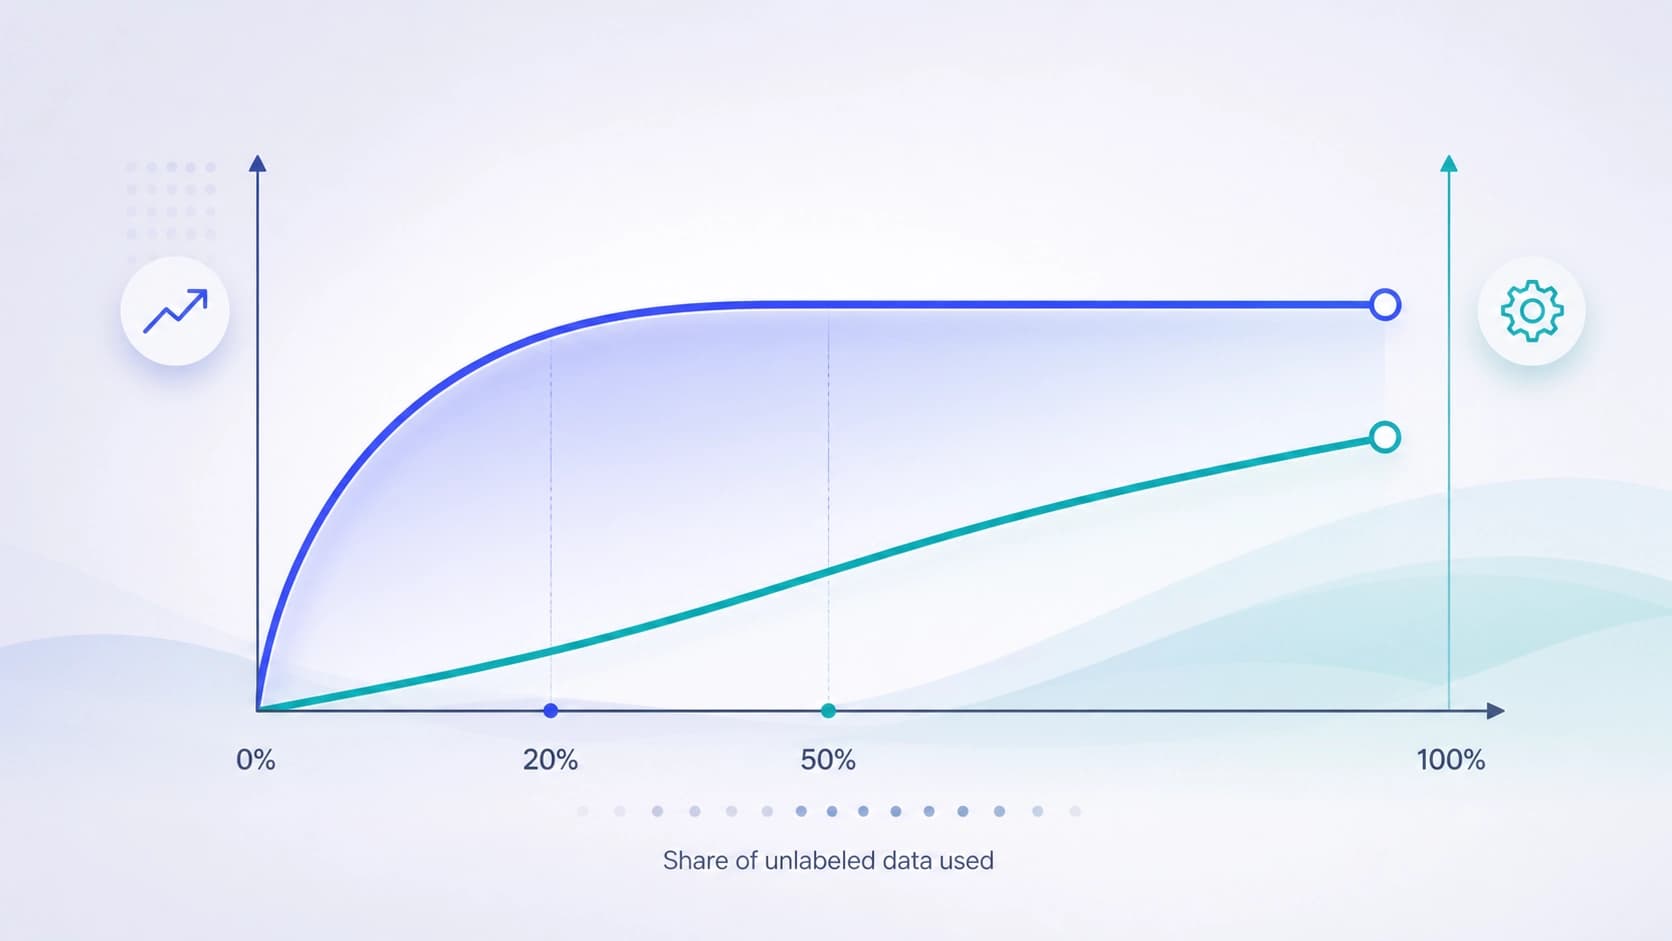
- При фиксированном вычислительном бюджете пик достигается всего на 20–50% доступных неразмеченных записей. Остальной корпус прироста уже не добавляет.
- Если общее число окон сигнала зафиксировано, результат не зависит от того, сколько пациентов в него вошло. Значит, работает не «уникальность людей», а временная разнообразность фрагментов: разные состояния, режимы и артефакты внутри записи.
Последний пункт переворачивает привычную логику сбора данных. Интуитивно кажется, что чем больше разных пациентов, тем надёжнее. Здесь же выходит, что при жёстком лимите на количество окон можно набрать данные у меньшего числа людей — важно лишь следить за разнообразием их сигнала во времени.
Почему это меняет расклад для клиники
До сих пор внедрение EEG-фундаментальных моделей упиралось не в качество представлений, а в бюджет: чтобы получить от модели пользу, нужно было позволить себе полное дообучение и большой размеченный корпус. Работа показывает, что этот барьер можно снизить с двух сторон одновременно — по вычислениям и по данным. Девять процентов весов и половина неразмеченного архива вместо ста процентов и всего объёма.
Для больницы это означает более реальный сценарий: модель предобучается централизованно, а на месте под конкретную задачу настраивается на скромном оборудовании. Меньше зависимости от того, кто собрал больше записей, и меньше затрат на хранение и обработку лишних часов сигнала.
Что стоит держать в голове
Не стоит читать результат как «девяти процентов всегда достаточно». Это конкретный режим из конкретного эксперимента, а не универсальный рецепт для любой архитектуры и любого набора данных. Сами авторы оговаривают: обобщение EEG-моделей остаётся ограниченным, особенно на разнородных клинических корпусах. Параметр-эффективная адаптация не отменяет проблему переноса — она лишь снижает цену входа в него.
Практический вывод проще, чем кажется: разговор смещается из плоскости «стоит ли вообще связываться с фундаментальными моделями для ЭЭГ» в плоскость «как развернуть их в отделении». А это уже вопрос инженерии и организации процесса, а не только машинного обучения.