
Устойчивость детекторов к перефразированному машинному тексту: что выявили испытания
В материале собраны результаты проверок инструментов, которые переписывают сгенерированные фрагменты под более естественный стиль. После такой обработки обнаруживаемость заметно снижается, а сохраняющиеся ложные срабатывания не позволяют считать вердикт детектора доказательством.
Как перефразирование меняет текст и сигналы детекторов
Очеловеченный ИИ-контент — это машинный текст, который перефразировали так, чтобы он звучал естественнее. Инструменты меняют выбор слов, длину предложений и тон. Некоторые добавляют неровный ритм или многократно переписывают текст. Такие изменения меняют сигналы, на которые опираются детекторы: предсказуемость слов и вариативность длины предложений.
- выбор слов;
- длина предложений;
- тон;
- неровный ритм;
- многократная переписка.
Вывод: перефразирование меняет именно те признаки, по которым детекторы отличают машинный текст.
Что показали испытания перефразированного текста
Испытания проверяли, сохраняют ли детекторы устойчивость после перефразирования. Исследование 2025 года охватило 19 инструментов для очеловечивания и перефразирования.
| Испытание | Результат |
|---|---|
| Исследование 2025 года, 19 инструментов | Многие детекторы не распознают очеловеченный текст. |
| Google Research | Модель перефразирования сохраняет смысл и в значительной степени избегает обнаружения. |
| Перефразирование ChatGPT с помощью QuillBot | Точность детектора на тексте ChatGPT упала до 49%. |
| Другой тест | Перефразирование ChatGPT обходило каждый детектор как минимум в половине случаев. |
| Stanford, литературный язык | Выявление ИИ-текста снизилось со 100% до 13%, когда ChatGPT попросили использовать более литературный язык. |
Вывод: устойчивость детекторов к перефразированному машинному тексту низкая.
Что детекторы улавливают в тексте
Детекторы опираются на признаки, которые не всегда связаны с машинным происхождением текста. Исследователи Carnegie Mellon установили: текст базовых моделей часто казался написанным человеком для GPTZero и Pangram. Текст моделей, дообученных следовать инструкциям, — нет. Команда считает, что детекторы отслеживают скорее следы обучения модели, чем надёжный признак машинного письма.
- базовые модели: текст часто кажется человеческим для GPTZero и Pangram;
- модели, дообученные следовать инструкциям: текст так не кажется;
- вывод команды: детекторы отслеживают следы обучения.
Stanford проверил семь детекторов на 91 эссе авторов, для которых английский не родной. Средний уровень ложных срабатываний составил 61,3%. Более 91% эссе отметил хотя бы один инструмент. Эссе авторов, для которых английский родной, получили показатели, близкие к нулю. Исследователи связывают разницу с простым и предсказуемым выбором слов, который детекторы принимают за машинный текст.
Вывод: сигнал детектора не равен машинному происхождению текста, поэтому оценка требует контекста.
Заявленная точность и реальные ограничения
Независимые и авторские тесты дают разные оценки точности. Условия проверки меняют результат.
- Обзор независимых тестов: точность Turnitin, GPTZero и Originality.ai составляет 70%–85%. У этих инструментов сохраняется проблема ложных срабатываний.
- Turnitin заявляет о точности 98% и уровне ложных срабатываний менее 1%. Заявление действует только для документов, в которых ИИ создал более 20% текста.
- OpenAI закрыла собственный классификатор в июле 2023 года. Классификатор выявлял только 26% текста, который создал ИИ.
- Авторы исследования 2025 года обучили модель на очеловеченных образцах. Модель выявляла очеловеченный текст при низком уровне ложных срабатываний. Она сохраняла эффективность при попытках её обмануть. Авторы самой модели получили результаты; нужны независимые тесты.
Вывод: заявленная точность зависит от условий, а независимые тесты показывают пределы обнаружения.
Практическая оценка детектора
Эксперты рекомендуют считать оценку детектора подсказкой, а не доказательством. Для проверки можно учитывать историю черновиков, задавать короткие устные вопросы и сравнивать с работами, которые выполнили в классе. Авторам и издателям эксперты советуют запрашивать источники, интервью и оригинальные данные.
- история черновиков;
- короткие устные вопросы;
- сравнение с работами, которые выполнили в классе;
- источники, интервью и оригинальные данные для авторов и издателей.
Практический критерий: детектор служит сигналом к дополнительной проверке, а не единственным основанием для вывода.
Часто задаваемые вопросы
Похожие материалы
Все материалы
FedSocket: обмениваемые модели с обязательной исполнимостью у получателя при мультимодальной гетерогенности
Предложен FedSocket — подход, при котором обмениваемая модель обязана быть вычислима на стороне получателя, а разнородные частные модели связывает общий интерфейс предсказаний Q. В статье описаны агрегация с учётом принадлежности, пересылка лишь параметров Q вместе со счётчиками и эксперименты на шести датасетах, демонстрирующие рост точности при недостающих модальностях и преимущество Joint-инференса над независимыми ансамблями.
13 ноября 2026
CyberArena: парные матчи ИИ-агентов выявляют пределы статичных кибербенчмарков
Бенчмарк помещает двух агентов в песочницы с непрерывно меняющимися сервисами и по итогам серии раундов сводит их действия к многомерным оценкам наступательных и оборонительных навыков. На 466 матчах с 12 современными моделями он различил возможности там, где односторонние тесты упираются в потолок, включая планирование на несколько ходов и создание бэкдоров.
13 ноября 2026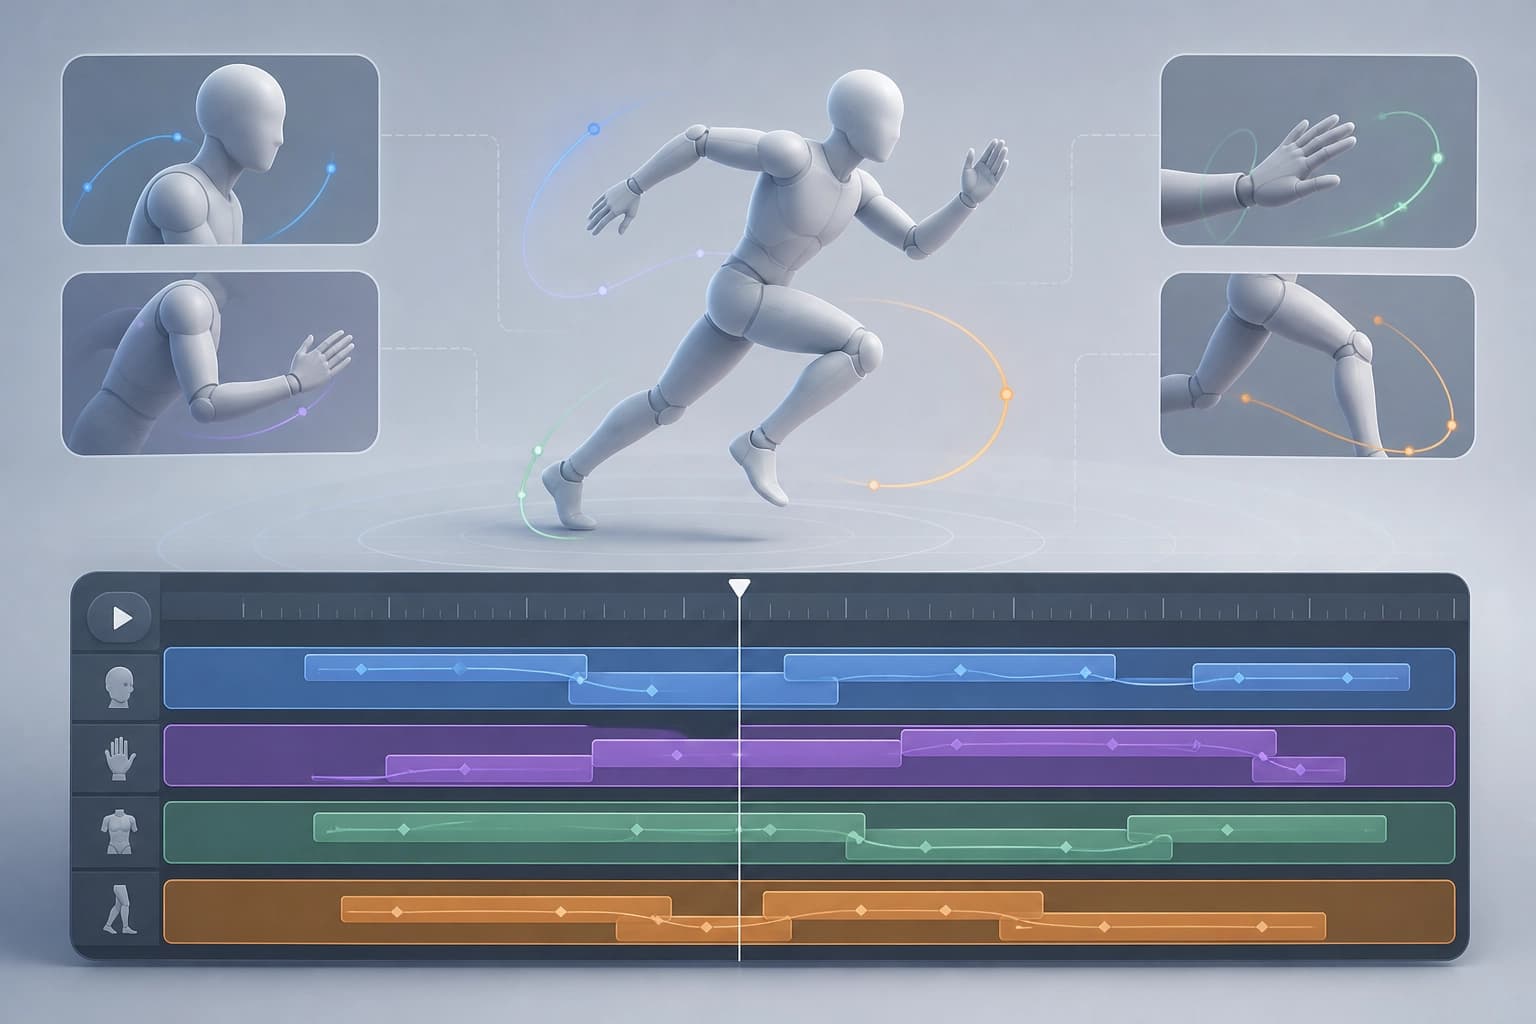
Новые команды по ходу синтеза: многодорожечный таймлайн для 3D-движений человека
Предложен метод, который принимает новые текстовые указания уже во время синтеза и позволяет независимо задавать перекрывающиеся интервалы действий. Согласование одновременных движений разных частей тела обеспечивается интервальным кондиционированием и процедурой денойзинга с учётом частей тела; на TimelineMotion и MTT авторы сообщают о лучшем соответствии семантике и временным ограничениям, чем у потоковых базовых решений.
12 ноября 2026