
ChannelFlow-Tools: настраиваемый пайплайн для создания датасетов трёхмерных обтеканий под задачи машинного обучения
Авторы представили открытый конвейер, который автоматически генерирует геометрию препятствий, выполняет гидродинамическое моделирование и превращает результаты в тензоры для обучения нейросетей. Система проверена на воспроизводимость и качество данных, а полученный набор позволил успешно обучить несколько суррогатных моделей.
Зачем нужен ещё один пайплайн для датасетов
Подготовка данных для обучения моделей, предсказывающих трёхмерное обтекание тел, обычно упирается не в нейросеть, а в рутину: нужно сгенерировать геометрию, построить расчётную сетку, провести симуляцию и привести результаты к единому формату. Всё это сложно воспроизводить автоматически, поэтому готовые датасеты получаются дорогими и плохо масштабируются.
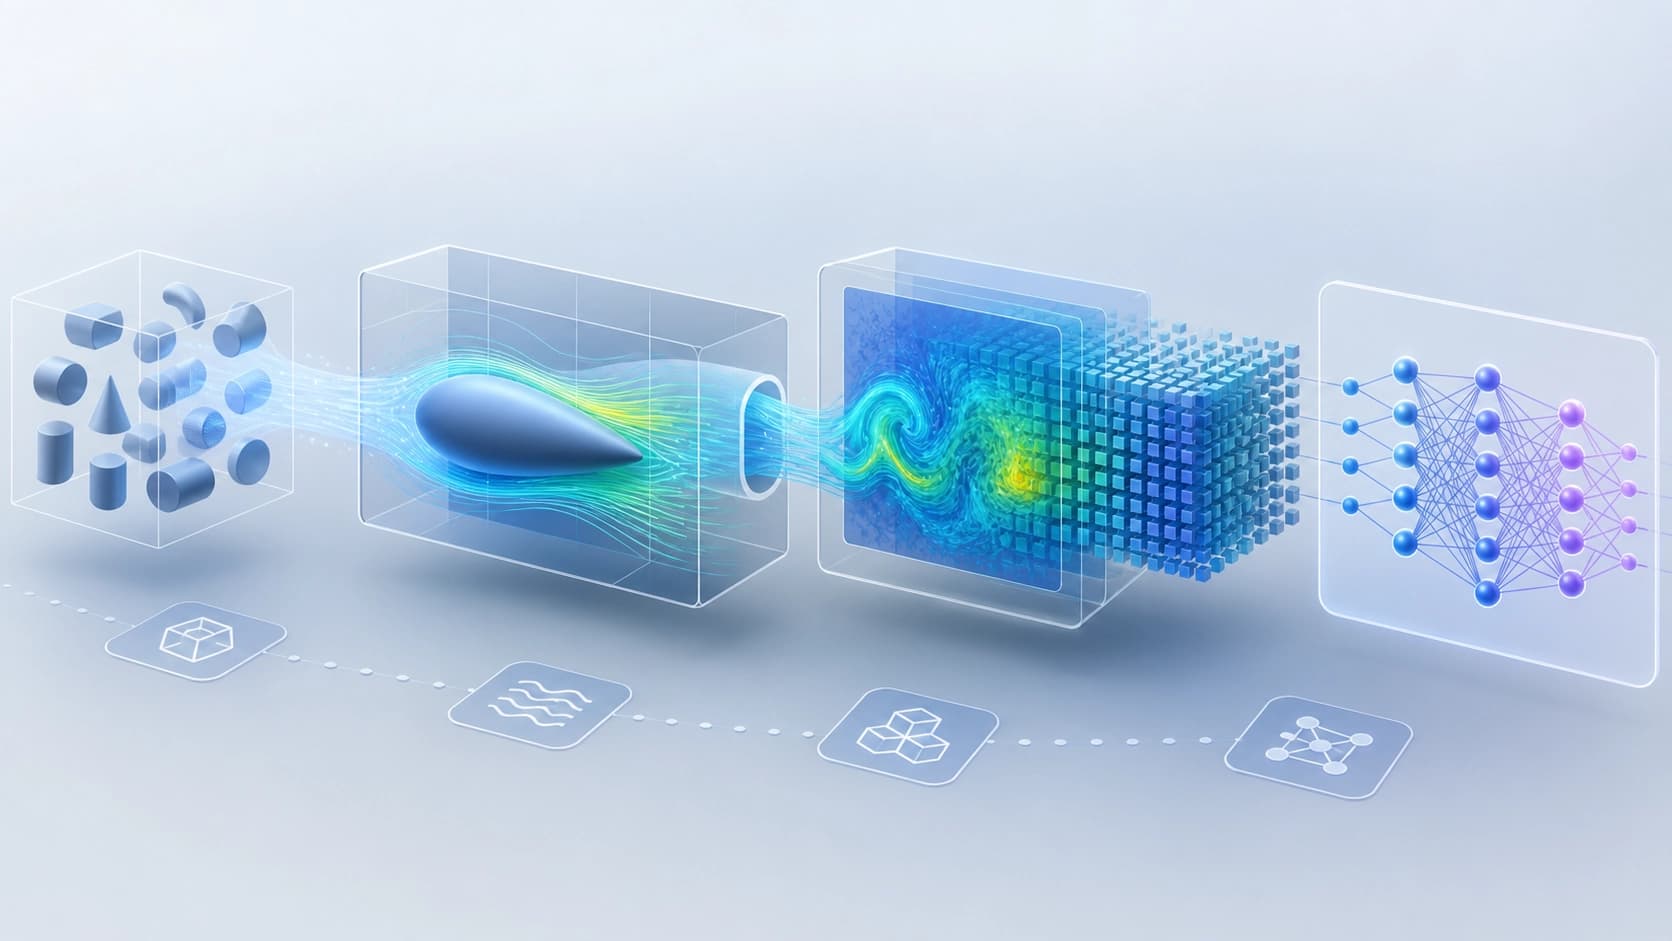
Открытый инструмент ChannelFlow-Tools предлагает другой подход: собирать наборы данных не по одному примеру, а целым конвейером — от процедурной генерации препятствий до упаковки трёхмерных полей течения в тензоры, пригодные для обучения. Судя по описанию проекта на arXiv, основная цель авторов — убрать ручные операции и сделать процесс настолько воспроизводимым, насколько это возможно.
Что происходит внутри конвейера
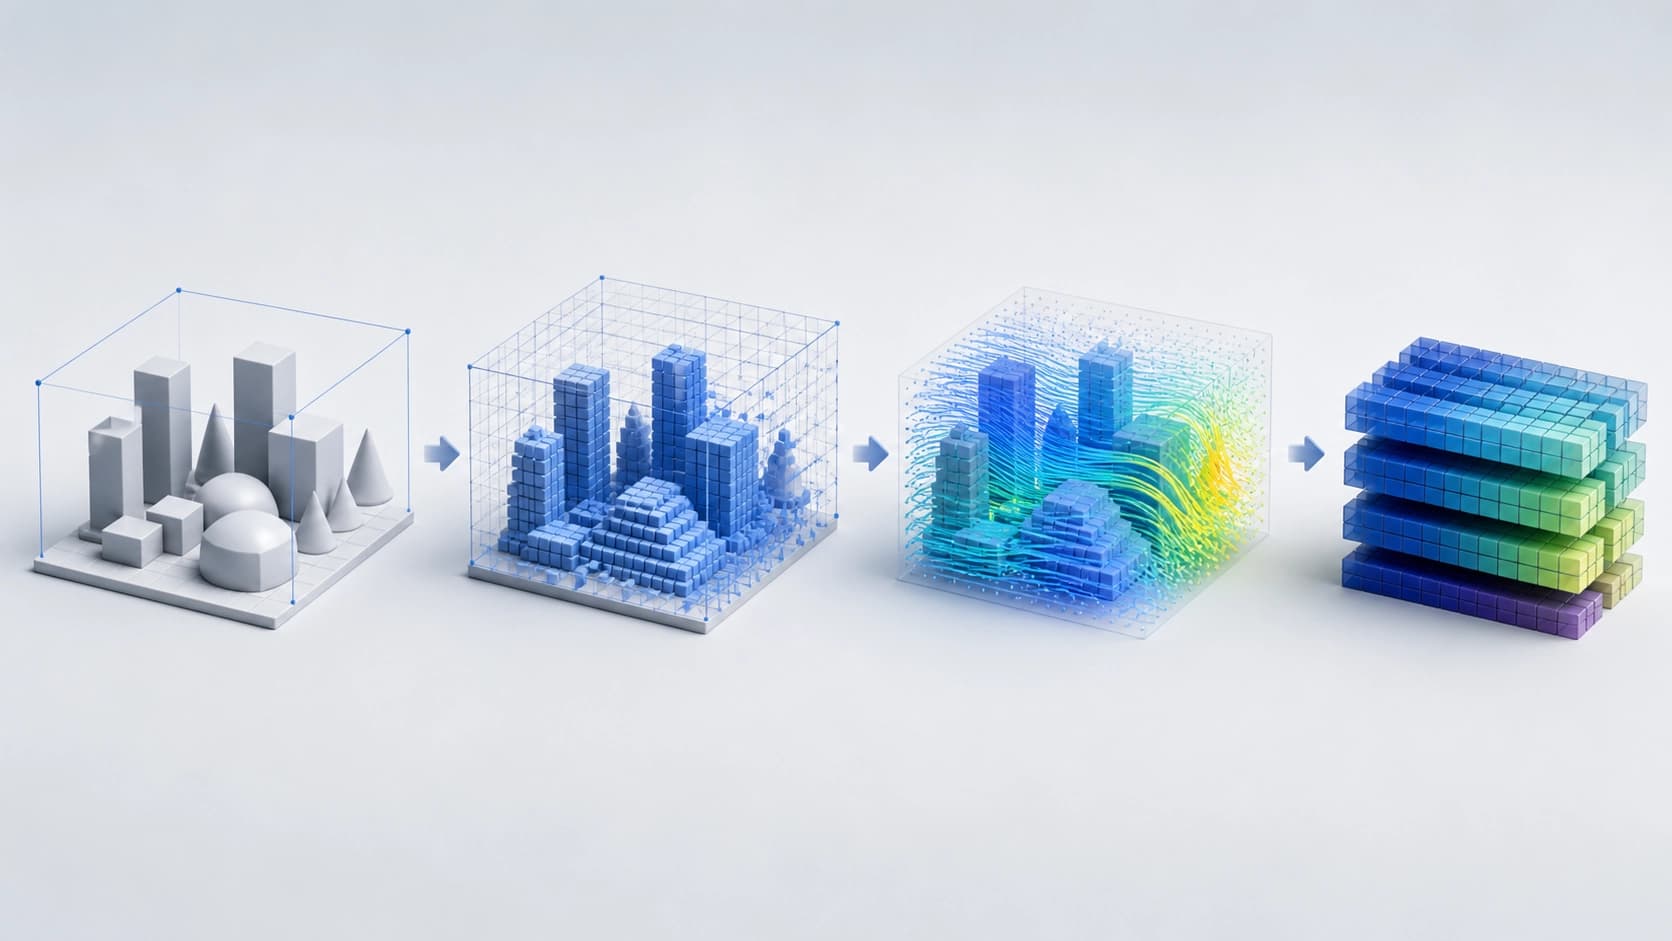
Типичная задача выглядит так: в канале размещается препятствие, и по входным условиям потока нужно предсказать трёхмерное поле скорости и давления вокруг объекта. Особенность ChannelFlow-Tools в том, что он автоматически перебирает геометрические варианты из шести семейств форм. Вместо ручного подбора объектов используется процедурная генерация, которая может выдавать большое разнообразие препятствий с контролируемыми параметрами.
Дальше геометрия переводится во воксельное представление на основе полей расстояний со знаком. Такое представление удобно для свёрточных моделей и не требует непосредственной работы с нерегулярной расчётной сеткой. После этого запускается решёточно-больцмановское моделирование — способ численного решения гидродинамических уравнений, который хорошо ложится на параллельные вычисления. Наконец, результаты симуляций и исходные маски геометрии складываются в тензоры, готовые для нейросетевых архитектур.
Весь процесс управляется конфигурационными файлами. Это значит, что параметры генерации, условия симуляции и формат выходных данных можно задавать декларативно, а не «зашивать» в код. По заявлению авторов, этап генерации геометрии воспроизводим байт-в-байт: одинаковые конфигурации дают одинаковые объекты независимо от повторного запуска. Для физического симулятора полная битовая воспроизводимость сложнее, но по крайней мере процедурная часть проекта сделана строго.
Проверка данных не «на глаз»
Создать датасет — половина дела. Прежде чем использовать его для обучения, авторы провели несколько уровней валидации. Среди них — сквозная проверка целостности расчётных сеток, аналитические тесты знаковых функций расстояния и сравнение с известным бенчмарком обтекания сферы. Также проверялась байтовая целостность данных после всех преобразований.
Такая аудитория важна не только для качества отдельного сэмпла, но и для уверенности в том, что весь корпус данных консистентен. Если модель обучается на выборке из тысяч симуляций, даже редкие сбои в геометрии или упаковке могут превратиться в систематическую ошибку.
Работают ли данные на практике
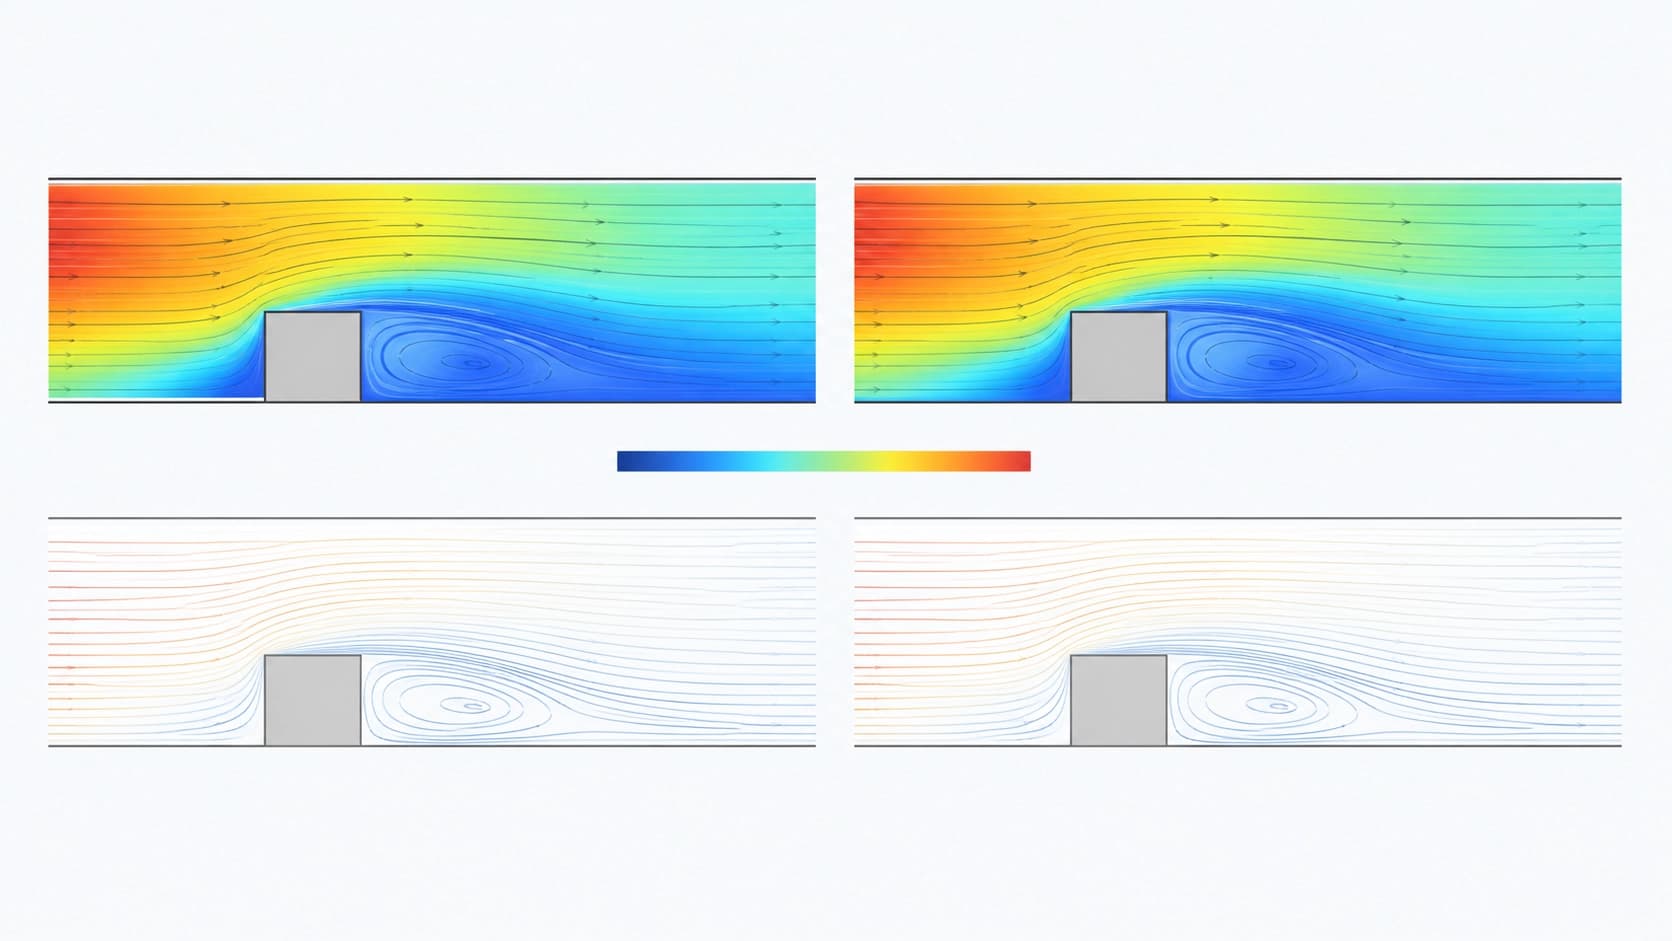
Чтобы продемонстрировать пригодность получившихся датасетов, авторы обучили три суррогатные модели: 3D U-Net, FNO и U-FNO. Каждая из них училась предсказывать поле течения по известной геометрии и параметрам потока. Выборка для обучения состояла из 450 симуляций с приведённым числом Рейнольдса примерно от 1000 до 10 000.
Сам по себе факт низкой ошибки на обучении мало что говорит. Более интересный результат — поведение моделей на тестовых сплитах, которые выходят за пределы обучающего распределения: другие семейства форм и не встречавшиеся ранее числа Рейнольдса. По словам авторов, предсказания остаются физически интерпретируемыми. Это косвенно подтверждает, что структура данных, собранная конвейером, передаёт моделям реальные закономерности течения, а не только «запоминает» примеры из обучающей выборки.
Итог
Судя по доступным материалам, ChannelFlow-Tools закрывает важный пробел между CFD-решателями и машинным обучением. Вместо отдельных скриптов для предобработки проект предлагает настраиваемый, проверяемый и воспроизводимый пайплайн. Это делает его полезным инструментом для исследователей, которые работают с трёхмерными обтеканиями и хотят больше внимания уделять архитектурам моделей, а не сборке очередного датасета.
Статья доступна в arXiv под номером 2509.15236; в списке авторов — Shubham Kavane, Lukas Schröder, Kajol Kulkarni, Fernando Gonzalez и Harald Koestler.
Часто задаваемые вопросы
Похожие материалы
Все материалы
AURA-Eval: как проверить, что LLM-агент распознал риск и изменил следующий шаг
Фреймворк оценивает поведение LLM-агентов не по финальному вердикту, а по реакции на риск в ключевых точках: траектории вызовов инструментов прерываются, после чего модель должна продолжить рассуждение и действие, а панель LLM-судей разбирает обнаружение риска, характер и безопасность шага. На 1249 заданиях, собранных из 157 траекторий R-Judge, у 20 моделей небезопасные действия учащаются при отсутствии безопасного пути, а снятие надзора до выполнения переводит 52,3% изначально безопасных случаев в небезопасные.
10 ноября 2026
Память резервуара Черна — Саймонса: самостоятельная динамика связности и перенос плотности
В статье разбирается, как резервуар сохраняет историю входных сигналов одновременно в распределении плотности и геометрических степенях свободы. Сравнение четырёх механизмов показывает, что ток создаёт отдельную компоненту связности, меняющую последующий отклик плотности, а учёт всех измеренных признаков даёт небольшой прирост в декодировании порядка импульсов.
10 ноября 2026
STAR: адаптивная нормализация временного контекста и графа сервисов для сквозного инцидент-менеджмента
Фреймворк STAR учит представления по метрикам, журналам и трассировкам, применяя обучаемую нормализацию с учётом многомасштабной временной динамики и структуры зависимостей между сервисами. На двух реальных наборах данных такой контур обеспечивает устойчивый рост качества выявления аномалий, сортировки отказов и поиска корневых причин относительно современных базовых методов.
10 ноября 2026