
Центральное управление памятью в мультиагентном ИИ: персонализация с меньшими издержками
Авторы предлагают системный слой общей памяти: агенты сохраняют структурированные сведения, а система контролирует их отбор, защиту данных и передачу моделям. В испытаниях на AIOS этот подход улучшил персонализацию относительно внешнего хранилища и RAG, а по сравнению с передачей полного контекста снизил задержку на 15–61% при сопоставимых результатах у двух из трёх моделей.
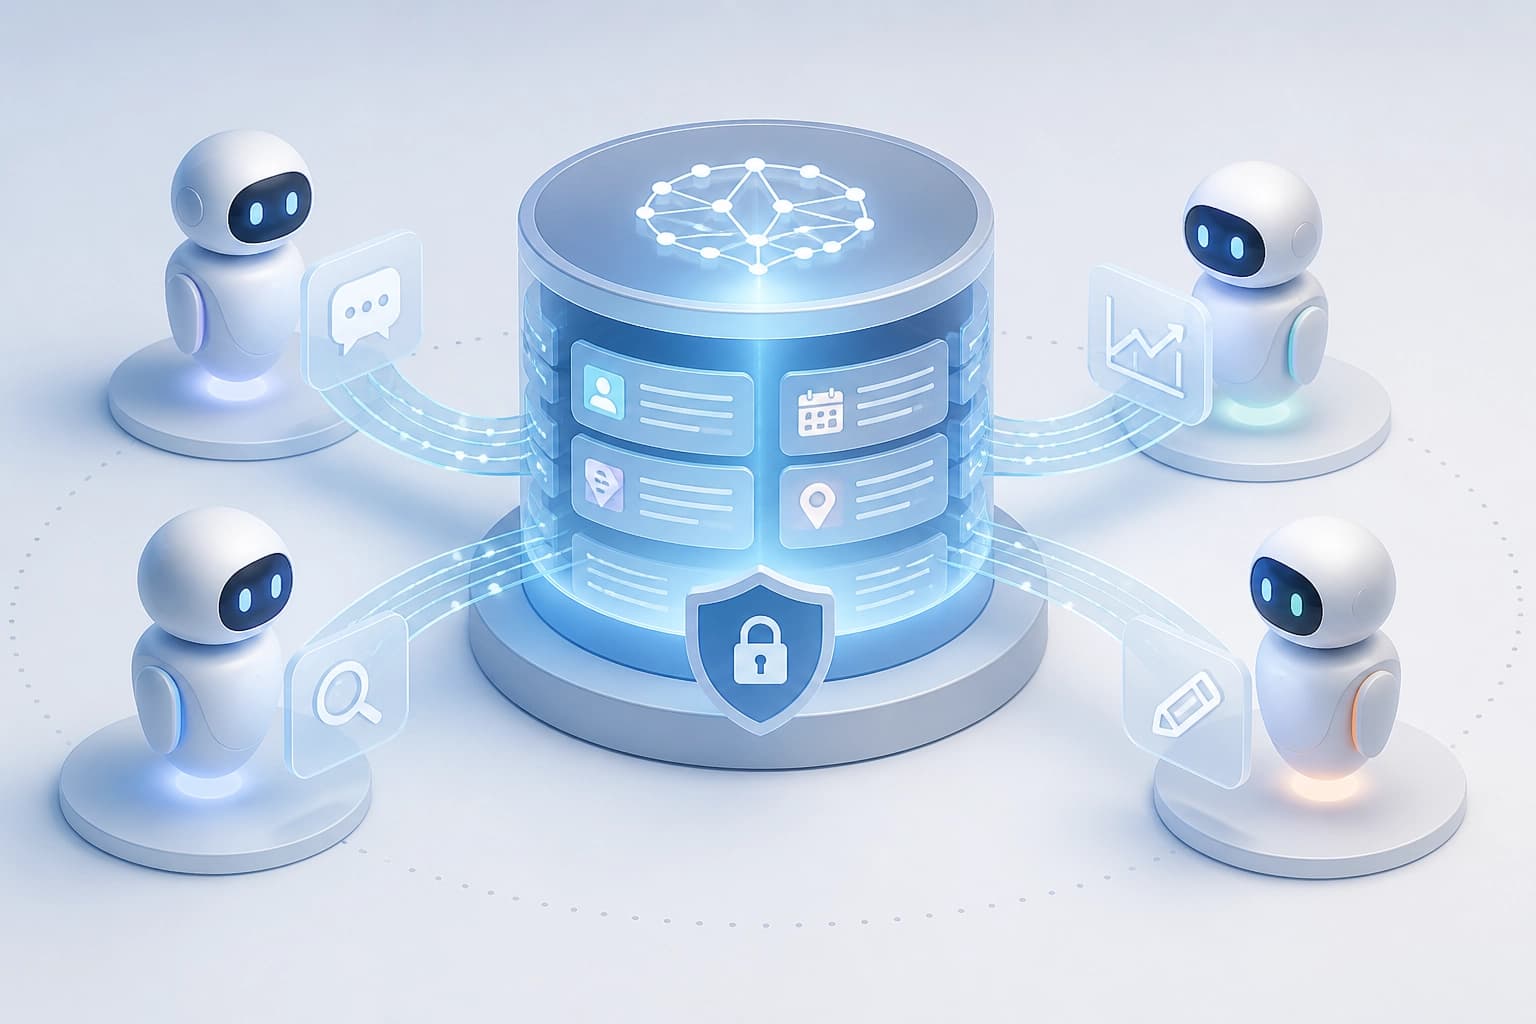
Как устроена центральная память
Специализированные агенты записывают структурированные воспоминания с метками. Ядро агентной системы управляет их извлечением, конфиденциальностью и добавлением в промпт.
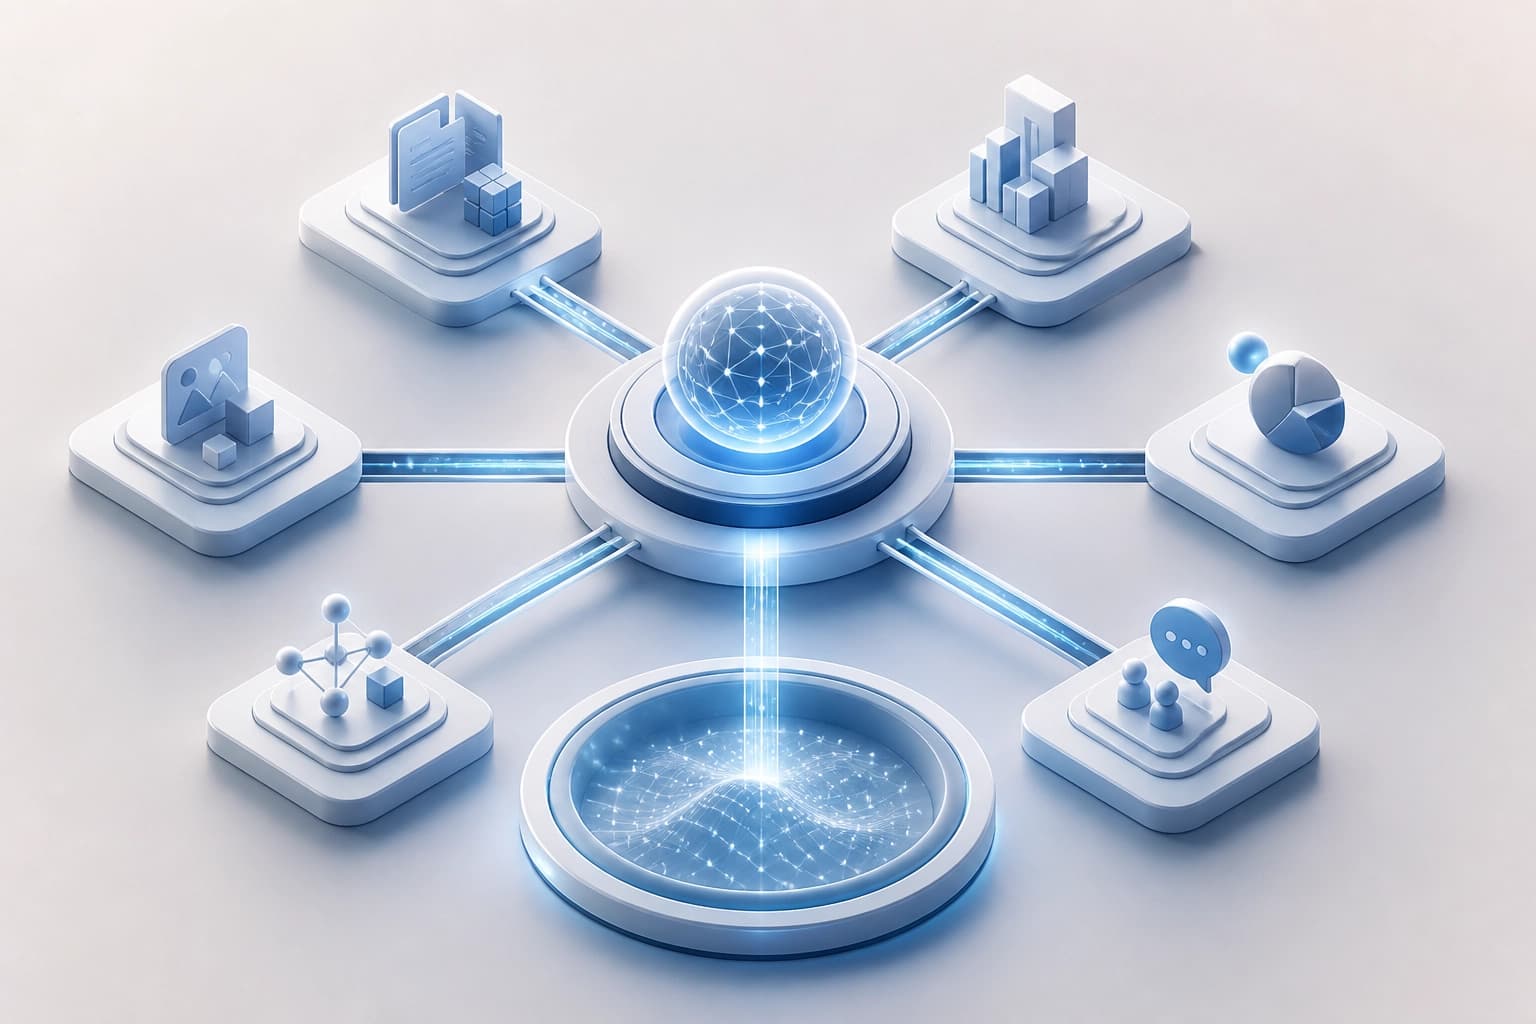
В этой схеме агенты создают воспоминания, а ядро определяет, как система ими пользуется:
- Запись: агенты сохраняют структурированные помеченные воспоминания.
- Извлечение: им управляет ядро, а не отдельные агенты.
- Защита и внедрение: ядро отвечает за конфиденциальность и добавление воспоминаний в промпт.
Централизация отделяет создание памяти от контроля над её использованием. Это важно, если правила извлечения и внедрения должны действовать на уровне всей агентной системы.
Как проверяли подход
Дизайн реализовали и оценили на AIOS. Авторы сравнили его с тремя альтернативами на трёх моделях-помощниках.
- GPT-4o
- Llama-3.1:8B
- Qwen-2.5:7B
Всего исследование включало 1 800 испытаний. В этой части работы описан масштаб проверки, а не отдельные условия сравнения.
Что показали сравнения
Результаты зависят от способа работы с памятью. В таблице приведены выводы авторов для трёх альтернатив.
| Альтернатива | Результат централизованного управления |
|---|---|
| Mem0 с тем же базовым хранилищем | Оценки персонализации выросли на 2,4–4,0 балла по пятибалльной шкале. Каждое сравнение статистически значимо: p < 10^-18. |
| Стандартное внедрение через retrieval-augmented generation | Приросты были большими и последовательными на всех трёх моделях. |
| Полная нефильтрованная конкатенация контекста | На двух моделях результаты статистически сопоставимы; на третьей централизованный вариант немного уступил. Промпты стали короче, сквозная задержка снизилась на 15–61% на всех моделях. Также снизились число токенов на вызов и стоимость инференса. |
Для GPT-4o пример оценки использования профиля изменился с 1,05 до 4,69. Этот показатель иллюстрирует результат сравнения с Mem0.
Когда рассматривать централизацию
Центральное управление памятью стоит рассматривать, если системе нужны общие правила извлечения, защиты и внедрения воспоминаний. Такой подход переносит эти решения с отдельных агентов на ядро системы.
Практический критерий — сопоставить требуемую персонализацию с допустимым объёмом контекста и затратами. Авторы заключают, что централизация даёт большую часть преимуществ персонализации неограниченного контекста при существенно меньших затратах.
Основа статьи — Kernel-Managed Shared Memory for System-Wide Personalization Райана Люма и Ёнфэна Чжана, поданной 9 сентября 2026 года.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Проверка coding-агентов в интерактивной XR-разработке: итоги GenXR-Bench
Опубликован GenXR-Bench — набор из 112 экспертных заданий для сквозной оценки coding-агентов в интерактивной XR-разработке: от доработки функций и исправления дефектов до создания приложений с проверкой поведения на потребительском оборудовании. У десяти протестированных моделей лучший результат составил 50,9% Pass@1; среди повторяющихся сбоев — обработка асинхронных событий датчиков, привязка объектов к реальному пространству и понимание взаимодействия в физическом контексте.
5 ноября 2026
От скалярной награды к фронту Парето: LLM-синтез RTL с многокритериальным подкреплением
Предложен способ обучать языковую модель генерировать не одну схему, а набор RTL-кандидатов с разными компромиссами между площадью, задержкой и энергопотреблением; награда строится по вкладу варианта в гиперобъём фронта Парето. На RTLLM v2 относительный гиперобъём вырос на 13,3 п.п. относительно базовой версии без оптимизации PPA и на 14,4 п.п. относительно одноцелевого обучения с подкреплением.
5 ноября 2026
Медицинские LLM узнают о пересмотре рекомендаций, но часто отвечают по прежним правилам
Исследование ChronoEvo на 1709 изменениях клинических рекомендаций показывает: в основной модели 90,8% ответов фиксировали новшество, однако полностью применяли его только 58,5%, а разрыв в 32,3 п.п. сохранялся у 14 моделей. Даже усиление заметности обновлений не дало значимого прироста в полном переносе новых правил в клиническую рекомендацию.
4 ноября 2026