
AdaLens: наглядная сюжетная линия, помогающая контролировать и перенаправлять долгие агентные анализы
С ростом автономности LLM-агентов в науке о данных стандартные интерфейсы не дают ясной картины рассуждений системы и возможности вовремя вмешаться. AdaLens визуализирует аналитический процесс в виде сюжетной линии: видны планы, прогресс и промежуточные результаты, а аналитик может перенаправлять ход работы.
Зачем нужен контроль над долгими агентными анализами
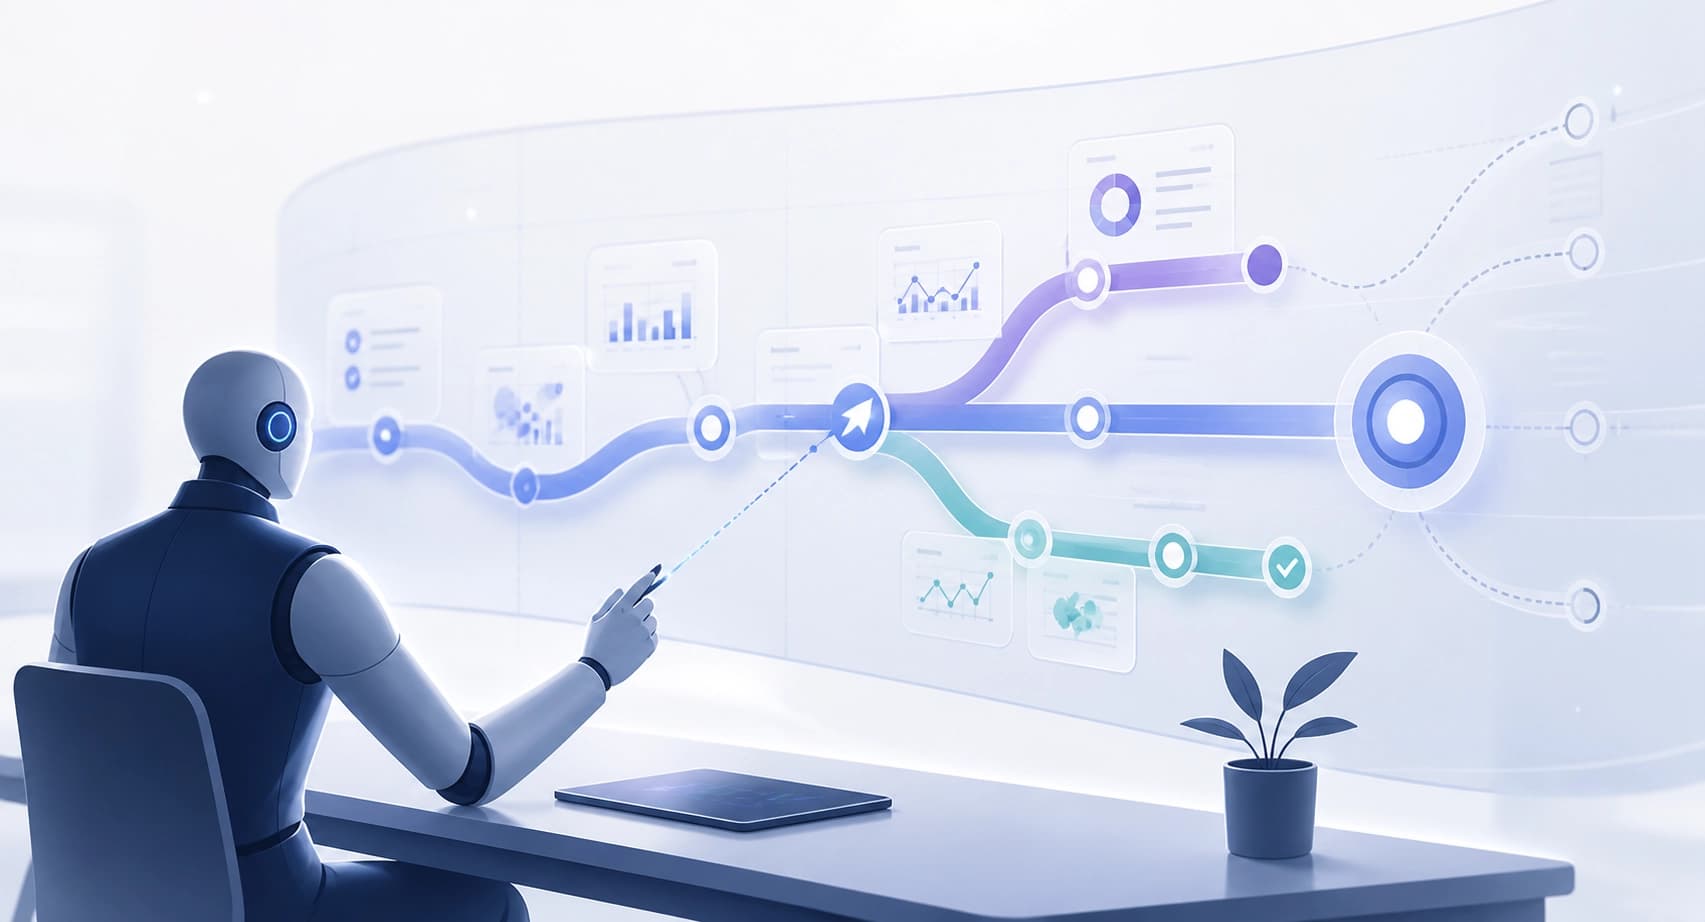
Современные большие языковые модели делают науку о данных всё более автономной: агент сам строит план, выполняет шаги, проверяет гипотезы. Но когда такой анализ длится долго и распадается на параллельные ветви, аналитику трудно понять, что именно делает агент и почему. Обычные интерфейсы показывают лишь скупые логи или результаты отдельных шагов, не давая полной картины.
Исследователи выделяют два ключевых требования: наблюдаемость — способность видеть, как эволюционируют рассуждения и доказательства агента, и управляемость — возможность вмешаться и направить процесс в нужную сторону. Без этого длительный анализ превращается в «чёрный ящик».
Ограничения существующих решений
Интерактивные инструменты уже пытаются открыть ход работы: они показывают шаги, позволяют останавливать выполнение или вносить правки. Однако большинство из них рассчитано на дискретный пошаговый диалог. В реальности агентный анализ часто идет параллельными ветвями, а структура решений меняется на ходу. Поэтому традиционный подход «шаг за шагом» не справляется.
В статье, представленной на arXiv 18 августа 2026 года, группа авторов — Yangtian Liu, Yan Miao, Shuhan Liu и другие — предлагает концепцию интерактивного надзора (interactive oversight) для длительных агентных сценариев.
Как устроен AdaLens
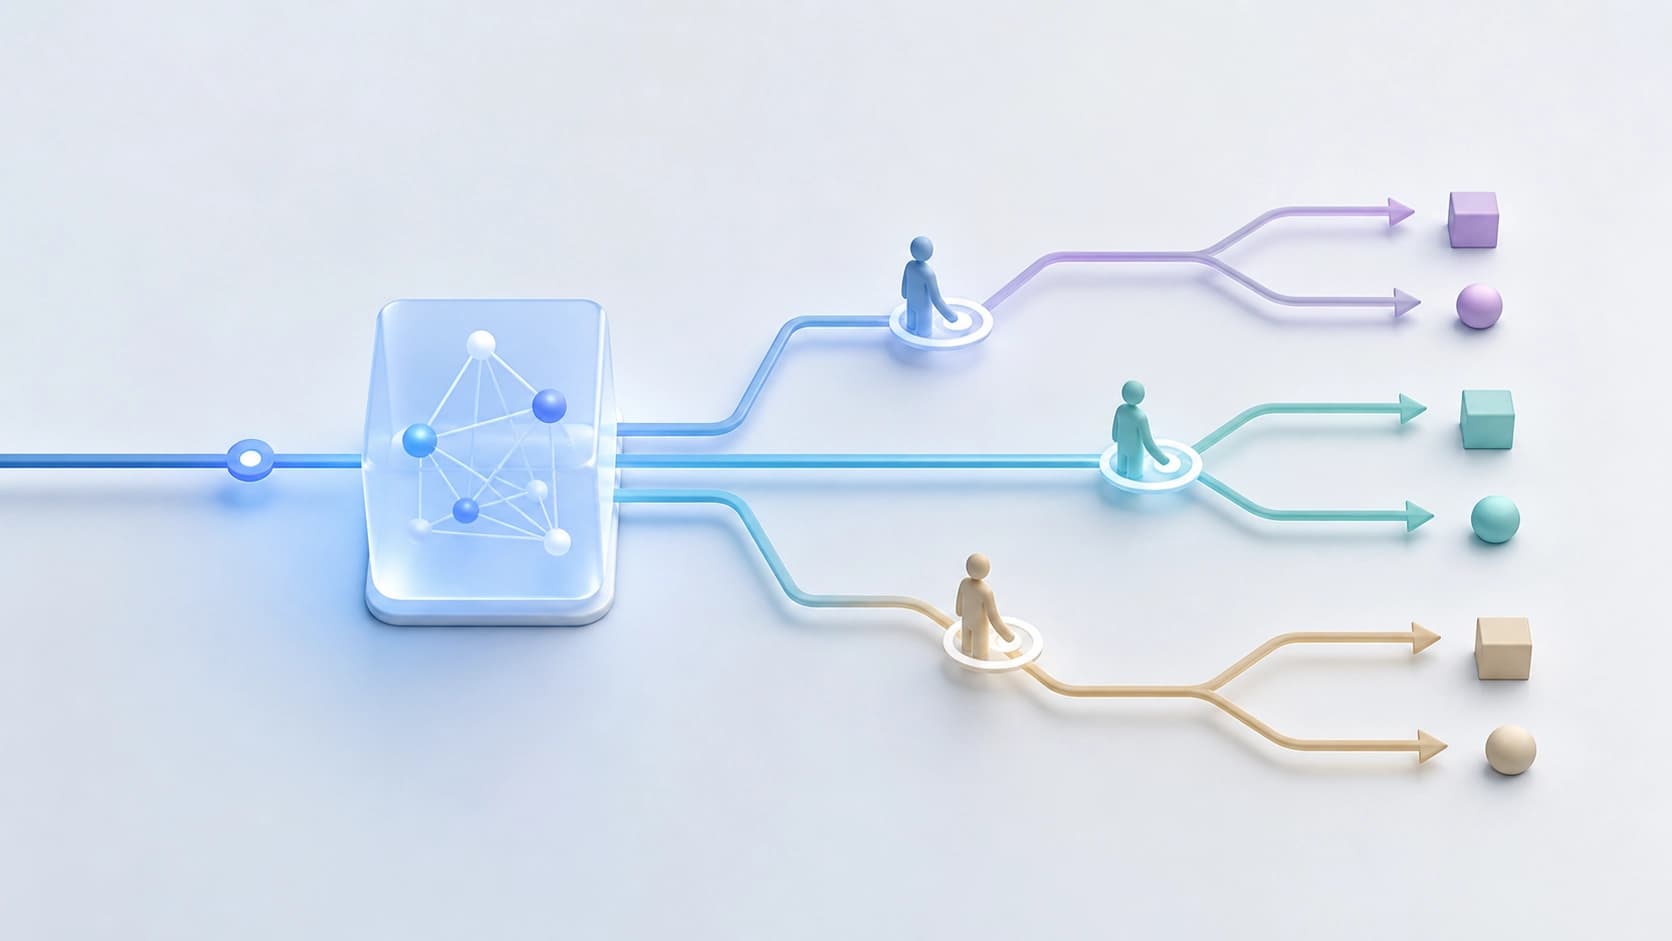
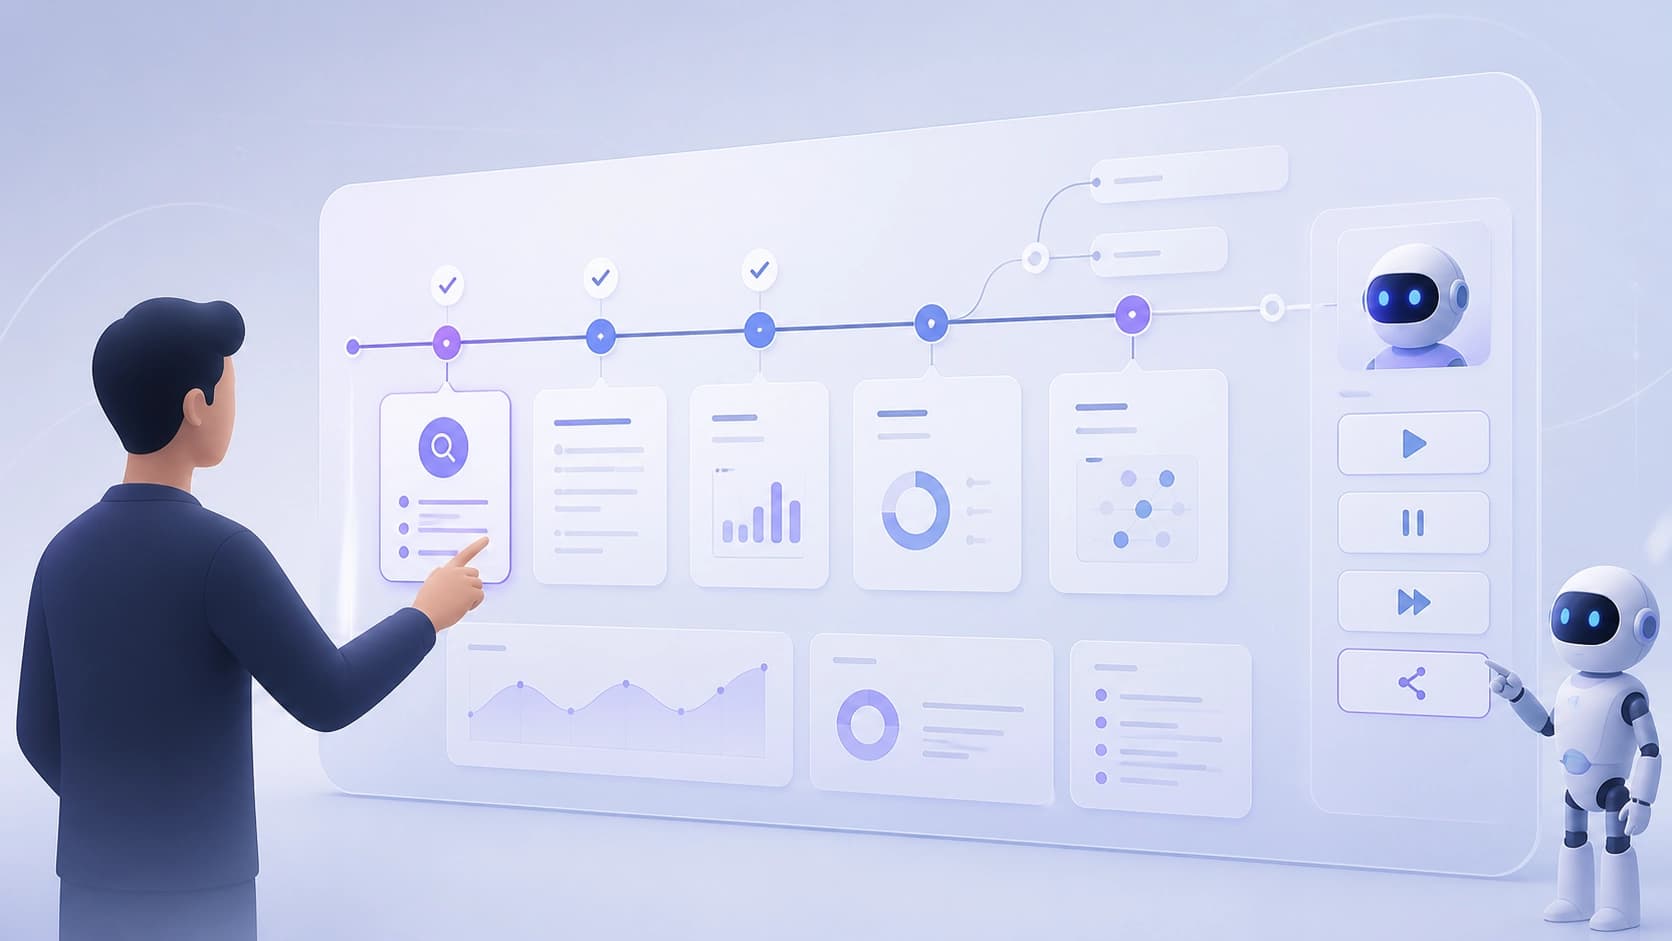
AdaLens — интерактивная система для мониторинга и управления текущими запусками. Основная идея — представить весь анализ в виде сюжетной линии (storyline), где наглядно видны:
- аналитический план и его развитие;
- текущий ход выполнения;
- промежуточные результаты;
- какие колонки данных задействованы и насколько активно.
Благодаря этому аналитик видит не разрозненные логи, а связную картину рассуждений агента.
Управление в AdaLens строится на основе тех же аналитических элементов: можно перенаправить малополезное направление, углубить перспективное, остановить лишние ветви или скорректировать план. Действия выполняются прямо во время работы агента — не нужно дожидаться завершения.
Оценка и перспективы
Авторы оценили AdaLens на двух тематических исследованиях и в ходе пользовательского исследования. Они изучали, как аналитики отслеживают длительный агентный анализ и направляют его с помощью сюжетной линии. Результаты подтверждают, что такой подход улучшает понимание процесса и дает возможность вовремя вмешаться.
Статья доступна по DOI: https://doi.org/10.48550/arXiv.2608.17834 (версия v1, 18 августа 2026 года). Похоже, что в ближайшем будущем подобные системы могут стать стандартным интерфейсом для сложных агентных рабочих процессов.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Toollery: выбор инструментов для LLM-агентов из десятков тысяч опций без дообучения
Toollery строит поисковый индекс по описаниям навыков и инструментов, а при запросе передаёт модели лишь ограниченный набор кандидатов. В экспериментах на библиотеках масштабом до десятков тысяч функций подход позволяет удерживать качество выбора при фиксированном top-K, хотя итоговый эффект зависит от профиля нагрузки и кэширования у провайдера.
11 ноября 2026
Поэтапная диагностика GUI-агентов при анализе дашбордов: бенчмарк DashAct
Представлен DashAct — бенчмарк из 348 проверенных человеком траекторий, который разбирает работу GUI-агентов с интерактивными панелями на три этапа и четыре визуальных условия. Результаты показывают устойчивые проблемы с предсказанием действий и привязкой к визуальным целям, а также зависимость реакции агентов от контекстной и пространственной поддержки.
11 ноября 2026
WILSON: объединение увеличений и стёкол пациента для патоморфологического анализа и формирования заключений
Препринт представляет WILSON — vision-language модель, которая кодирует изображения целых стёкол и серии препаратов одного пациента при разных увеличениях, а не только отдельный «лучший» слайд. Без дообучения под задачу она обходит специализированные и более крупные слайды-модели по ряду метрик при существенно меньшей вычислительной нагрузке, а её диагностические описания получили более высокие оценки патологов.
11 ноября 2026