
Sabedoria das multidões esbarra na uniformidade
Quando é preciso prever algo sobre o futuro — o comportamento do mercado, o desfecho de um evento, o destino de uma tecnologia —, surge uma ideia simples: quanto mais modelos consultarmos, mais confiável será a resposta. A lógica parece inabalável: sistemas diferentes erram de maneiras diferentes, logo, a média suavizará os desvios aleatórios.
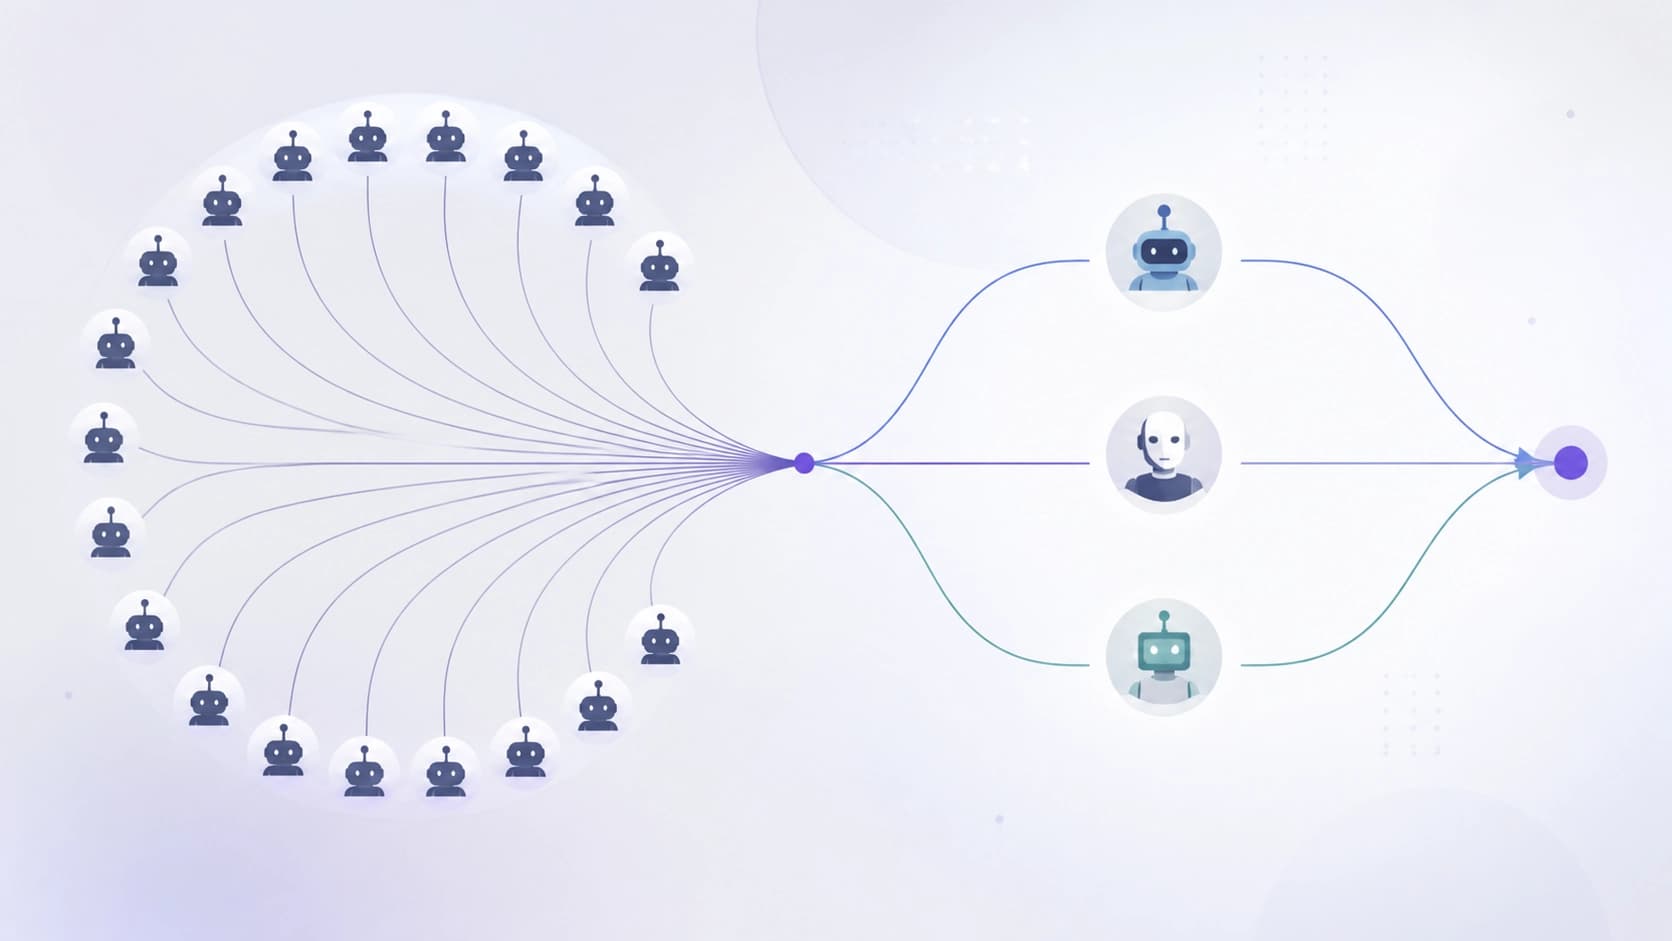
Mas esse esquema tem uma armadilha. Se todos os participantes da "multidão" raciocinam de forma parecida, seus votos não são evidências independentes, mas uma mesma opinião multiplicada por cópias. Dez respostas quase idênticas não acrescentam informação em comparação com uma só; elas apenas criam uma sensação de confiança e aumentam a conta de inferência.
É justamente em torno desse problema que se constrói o trabalho "Diverse by Reasoning: Harnessing the Wisdom of LLM Crowds for Future Prediction" — preparado por Niropam Chetlapalli, Yiming Liao, Min-Chun Chen e Keke Chen. O preprint arXiv:2608.24001 surgiu em 25 de agosto de 2026, já no dia seguinte saiu uma versão revisada, e o próprio artigo foi submetido à IEEE BigData 2026.
Apenas "mais modelos" não resolve o problema
A observação central dos autores: diferentes grandes modelos de linguagem podem se comportar de forma excessivamente semelhante. Eles são treinados em dados comparáveis, tendem a formulações parecidas e a movimentos típicos de raciocínio. No fim, a expansão mecânica da lista de participantes não gera a diversidade pela qual tudo foi concebido.
Aqui é importante distinguir dois conceitos. Quantidade é quantos modelos consultamos. Diversidade é o quão diferente eles chegam às conclusões. O segundo não decorre automaticamente do primeiro: é possível reunir vinte participantes e obter vinte variações de um mesmo pensamento.
Método: os modelos são selecionados pelo estilo de raciocínio, não pelas respostas
Como se dá a seleção comportamental
Os autores propõem um framework que chamam de orientado ao comportamento. A essência não está em comparar modelos pela correção das respostas finais, mas em entender como eles pensam.
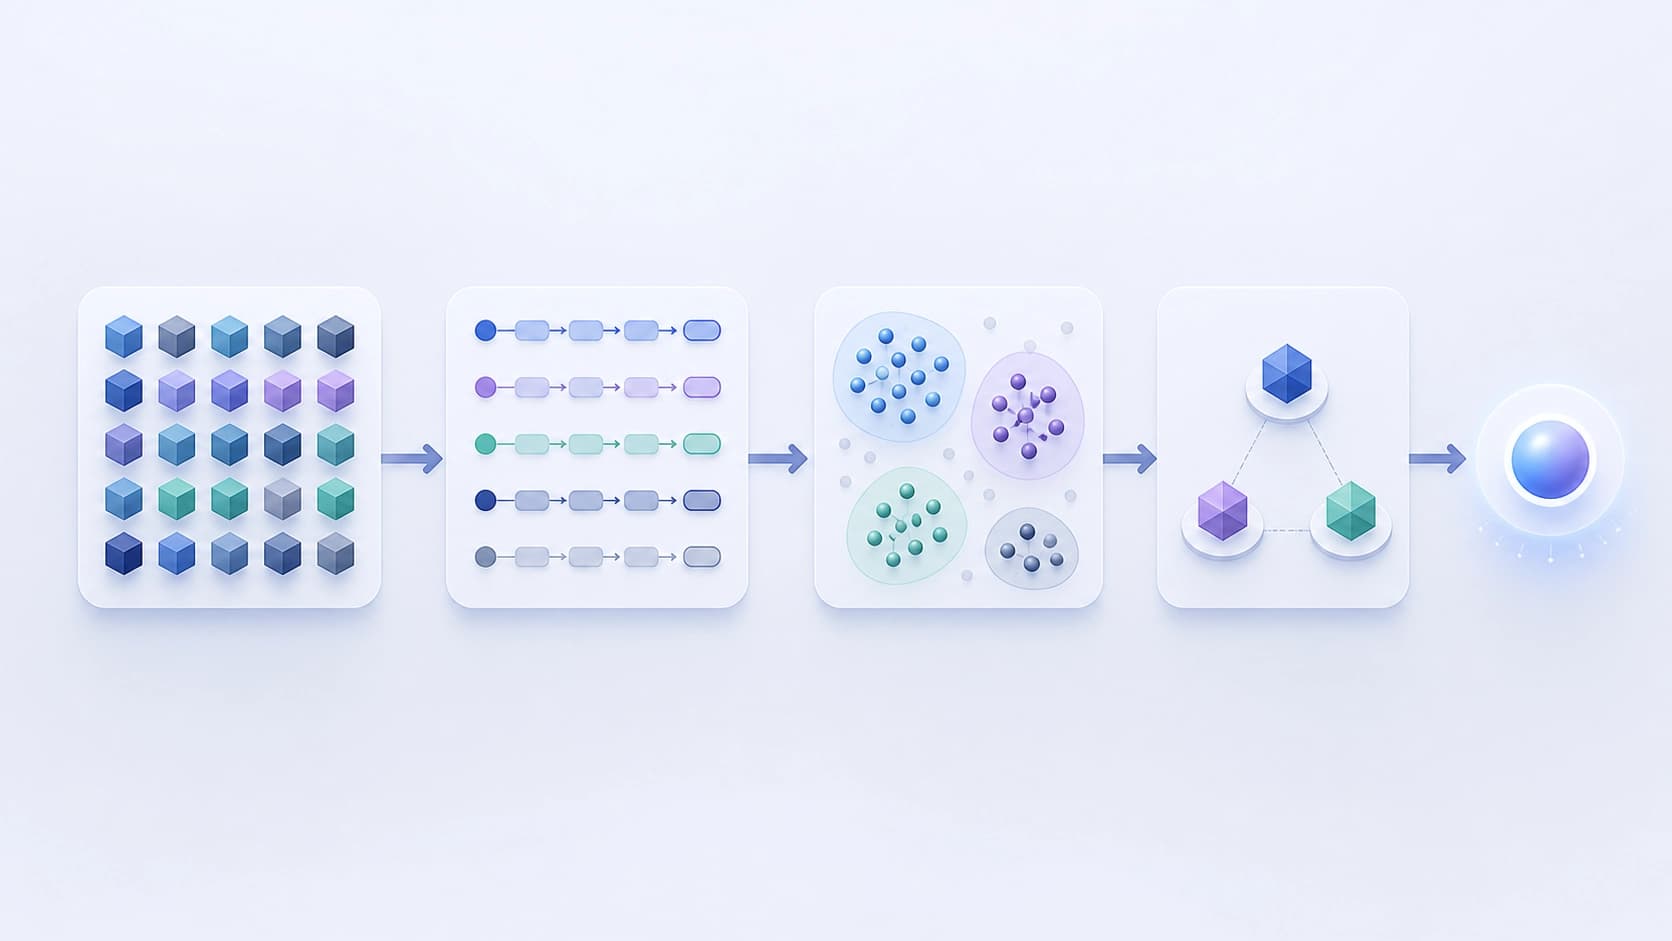
O esquema é o seguinte:
- Cada um dos modelos é executado em um conjunto de tarefas independentes, não relacionadas à previsão do futuro. Coletam-se não tanto as respostas, mas as cadeias de raciocínio — os próprios reasoning traces.
- Com base nesses traços, constrói-se um perfil comportamental: quais passos o modelo dá, como divide a tarefa, onde erra, a que argumentos recorre.
- Os modelos são agrupados em clusters por similaridade de comportamento. Para isso, usa-se o algoritmo K-means++.
- De cada cluster toma-se um representante — um medoide, ou seja, o modelo mais típico do seu grupo.
- É essa "multidão" compacta de medoides que emite a previsão coletiva.
A ideia, pensando bem, não é nova — é o que se faz em estatística quando, de características correlacionadas, mantém-se apenas um representante para não duplicar a mesma informação. A novidade aqui está em que a "característica" passa a ser a maneira de raciocinar do modelo de linguagem, e não uma propriedade numérica.
Com o que se testou
O experimento foi construído sobre 25 modelos. Sete benchmarks de desenvolvimento foram usados para descrever e separar os modelos por comportamento, e dois benchmarks separados — já de previsão do futuro — para avaliar a qualidade das "multidões" resultantes. Essa separação é fundamental: as tarefas pelas quais se constrói o perfil não coincidem com as tarefas pelas quais se calcula o resultado. Caso contrário, seria um treinamento com espiada, e os números quase não significariam nada.
Resultado: três modelos superam vinte e cinco
O mais estrondoso no trabalho é o resultado da comparação. A "multidão" de apenas três modelos-medoides, montada por meio de clusterização comportamental, saiu-se melhor do que a votação comum com todos os 25 modelos de uma vez. E isso vale para ambos os benchmarks de previsão.
Ao mesmo tempo, a economia foi considerável: o número de chamadas aos modelos caiu 88%, e os gastos com inferência, cerca de 80%. Para a prática, isso é talvez ainda mais importante do que o próprio ganho de precisão. Sistemas de previsão muitas vezes esbarram não na qualidade da resposta, mas no seu custo: se para cada pergunta é preciso consultar duas dezenas de modelos, a solução torna-se inviável muito antes de se tornar imprecisa.
Daí decorre uma conclusão nada óbvia: a composição da "multidão" pesa mais do que o seu tamanho. Vinte e cinco modelos não são uma vantagem automática sobre três, se esses vinte e cinco, na essência, repetem uns aos outros.
Nem toda diversidade é igualmente útil
Os autores tiram ainda uma outra conclusão cuidadosa, que é fácil deixar passar. Acontece que o importante não é maximizar a diversidade como tal, mas a representatividade — o quanto os participantes escolhidos refletem os diferentes polos de comportamento existentes entre os modelos.
A diferença é fundamental. Pode-se reunir três modelos que diferem entre si por acaso e por detalhes — e obter ruído em vez de sinal. Ou pode-se selecionar um de cada grupo comportamental realmente distinto — e obter um conjunto compacto que cobre o espaço de soluções. O primeiro é heterogeneidade dispersa, o segundo é diversidade estrutural. O que funciona é o segundo.
Aqui surge um paralelo com a expertise comum. Uma boa comissão não é aquela com mais pessoas, mas aquela em que estão representadas diferentes abordagens e pontos de vista. Cinco especialistas de áreas distintas costumam ser mais úteis do que quinze formados na mesma cátedra.
O que isso significa na prática
Para quem constrói serviços de previsão com modelos de linguagem, as conclusões do artigo dão uma receita bastante concreta:
- Não correr atrás do comprimento da lista de modelos. Ampliar o pool sem analisar o comportamento significa pagar por respostas duplicadas.
- Primeiro medir o comportamento, depois escolher a composição. A execução em tarefas alheias e a clusterização dão um quadro claro de quem no conjunto realmente se diferencia.
- Economizar com consciência. Reduzir o número de chamadas em uma ordem de grandeza, mantendo ou melhorando a precisão, muda a economia do produto, e não apenas suas características técnicas.
- Lembrar das limitações. Tudo isso foi verificado em um conjunto específico de 25 modelos e dois benchmarks de previsão; não convém transpor os números um a um para outros domínios e outros modelos.
A ideia central do trabalho soa quase humana: o valor da opinião coletiva não se sustenta na quantidade de votos, mas no fato de que esses votos sejam realmente diferentes. Aplicado aos modelos de linguagem, isso significa que o que se deve medir não é a lista de nomes, mas o estilo de pensamento — e, a partir dele, montar a equipe.


