
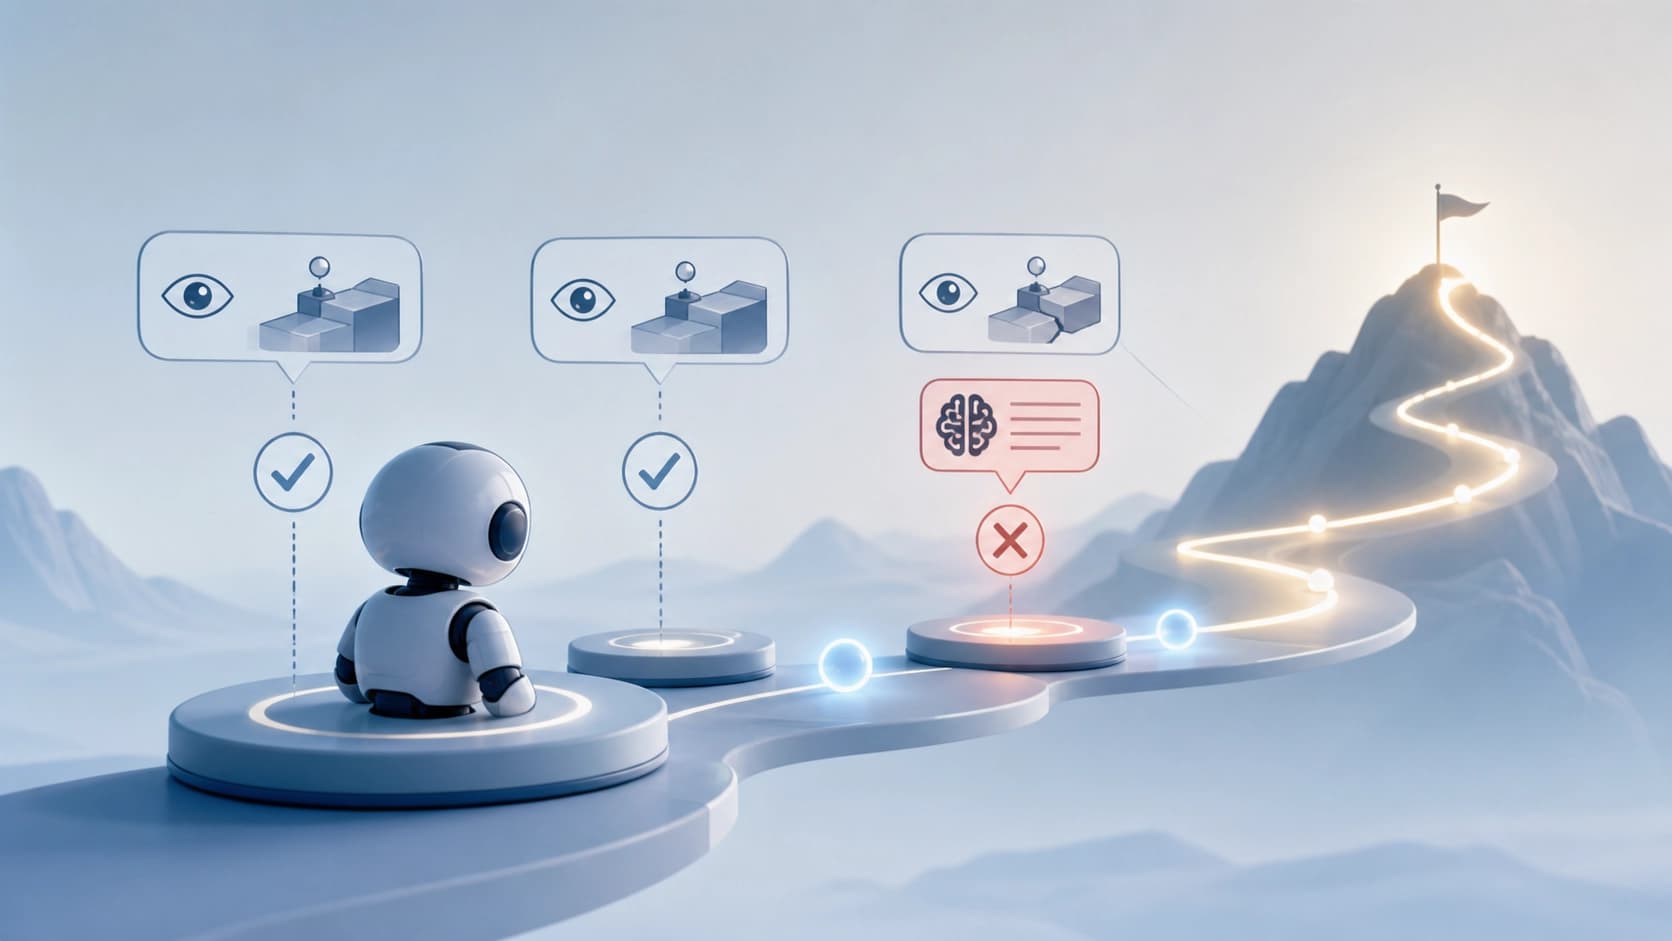
Problema: uma recompensa para toda a trajetória
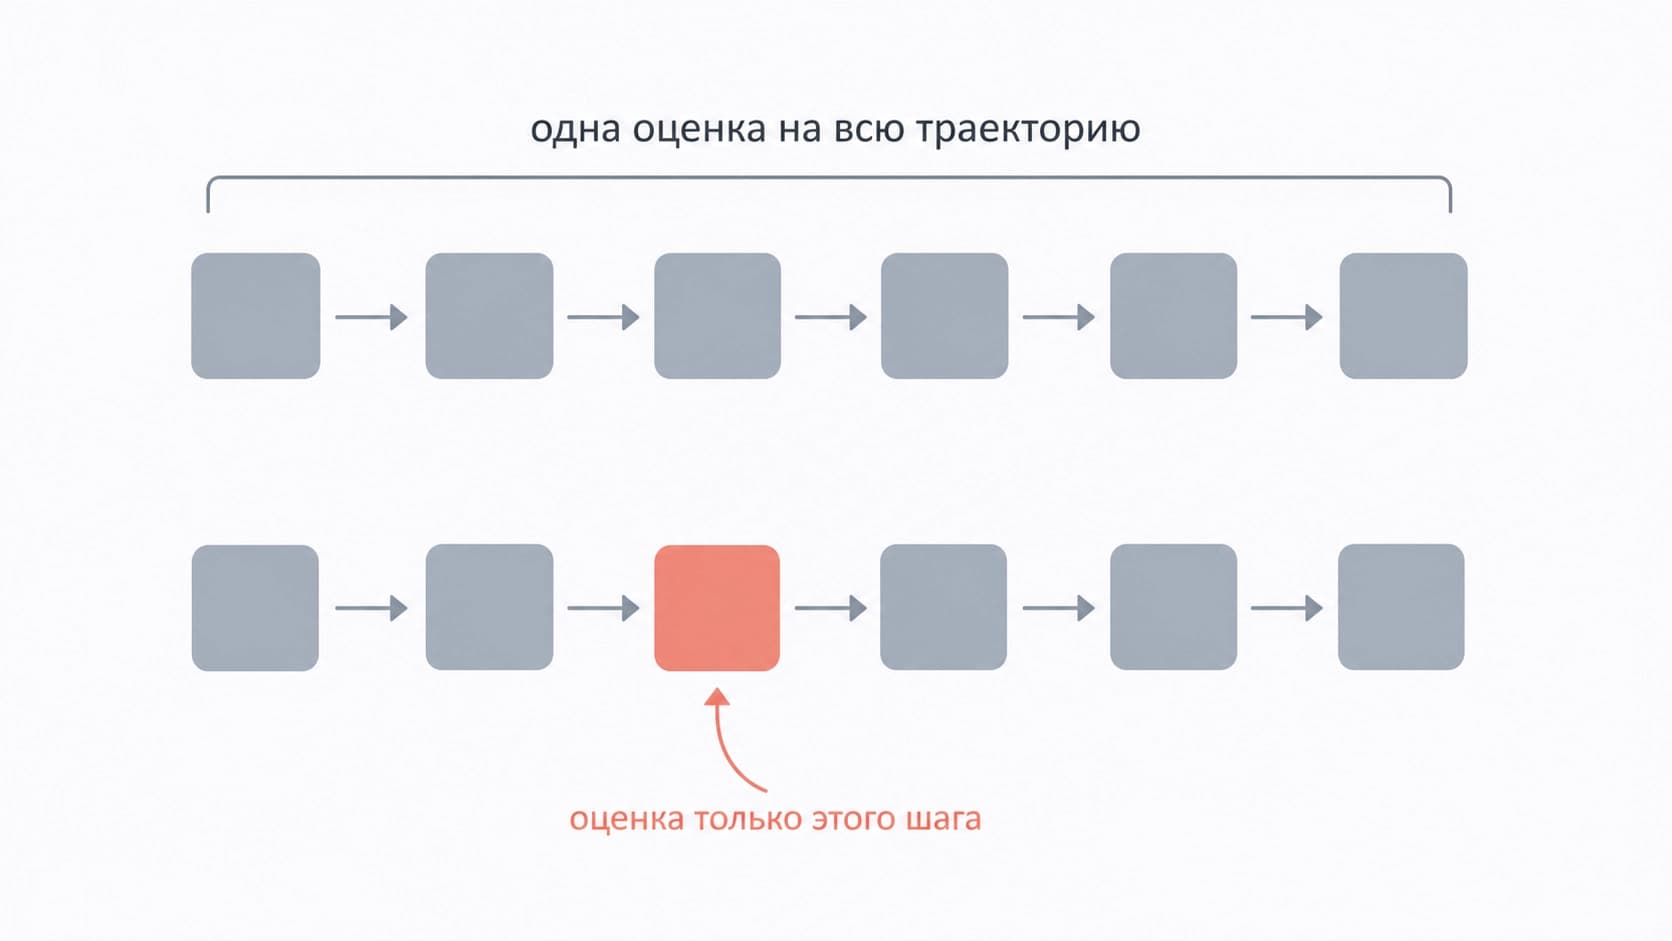
Agentes multi-turno baseados em LLM aprendem por tentativa: executam uma cadeia de ações, recebem uma avaliação final e, com base nela, ajustam o comportamento. O problema é que essa avaliação geralmente chega para a trajetória inteira. O agente descobre que a tarefa foi resolvida ou falhou, mas não descobre em qual passo exatamente algo deu errado.
A partir daí começa uma aritmética que combina mal com o bom senso. A mesma vantagem é espalhada por todos os passos em sequência — tanto pela escolha acertada de ferramenta quanto por um erro de digitação aleatório na consulta e por um rotineiro "confirmar ação". No fim, o modelo recompensa ao mesmo tempo os deslizes aleatórios e os passos de trabalho normais, se o desfecho foi bem-sucedido. O crédito pelo sucesso é distribuído igualmente a todos, e a culpa pelo fracasso também.
O tratamento clássico é a autodestilação com informação privilegiada. O professor sabe mais que o aluno: ele tem acesso ao ambiente, aos sinais intermediários, à resposta correta. Ele pode orientar em cada passo, e não apenas no final. Parece bom, mas essa abordagem tem um descuido oculto: a mesma orientação é dada a todos os passos sem distinção.
Assimetria dos passos: rotina e erros precisam de coisas diferentes
A ideia central do trabalho AHEAD é que os passos de uma trajetória não são equivalentes, e a supervisão para eles também deve ser diferente.
- Passos rotineiros — abrir uma página, confirmar uma transição, chamar a ferramenta necessária — quase não precisam de orientação. O modelo dá conta sozinho. Orientação excessiva aqui só adiciona ruído ao treinamento e consome orçamento.
- Passos críticos com erro — aqueles em que o agente tomou o caminho errado e perdeu a chance de sucesso — exigem não apenas a constatação de que "aqui está ruim", mas uma direção concreta: o que deveria ter sido feito em vez disso.
- O feedback do ambiente ancora bem o que acontece: ele diz o que realmente ocorreu. Mas ele não sabe explicar como deveria ter sido feito. O sinal "a porta não abriu" não indica onde estava a chave.
Acontece que as duas fontes de supervisão se complementam, mas não se substituem. O feedback do ambiente fornece um sinal denso e honesto em cada passo; as orientações corretivas geradas pelo modelo fornecem o que fundamentalmente não existe no feedback do ambiente — intenção e alternativa. Misturá-los às cegas por toda a trajetória significa perder os pontos fortes de ambos.
Como o AHEAD é estruturado
Os autores — Xiaolong Jin, Dingmin Wang, Vijay Lingam e Varun Kumar — propõem um framework que reconhece o tipo de passo e escolhe a fonte de supervisão adequada para ele. O trabalho foi publicado no arXiv no final de agosto de 2026, na categoria cs.AI; são 22 páginas, 15 figuras e 7 tabelas, ou seja, material suficiente para os detalhes.
Um professor que enxerga o ambiente
O modelo professor recebe o feedback do ambiente em todos os passos — é um sinal ancorado e denso, igualmente disponível tanto nos trechos bem-sucedidos quanto nos malsucedidos. Esse professor não fantasia: ele se apoia no que realmente aconteceu no ambiente.
Orientações corretivas — de forma pontual
Sobre isso, o professor recebe orientações geradas por LLM, mas não em todos os passos, e sim justamente nos passos com erro. A lógica é simples: onde o agente errou, o fato vindo do ambiente não basta, é preciso uma explicação de para onde se deveria ter ido. Onde tudo corre bem, nenhuma orientação adicional é acrescentada.
É exatamente isso que significa a "orientação pontual" do título: não espalhada pela trajetória, mas concentrada nos pontos problemáticos. Um pareamento consciente dos passos com as fontes de supervisão, em vez de um sinal único para toda a cadeia de ações.
Ajustes mínimos ao GRPO
Vale destacar separadamente a modéstia de engenharia do método. O GRPO — um algoritmo popular de aprendizado por reforço — não é reescrito do zero: as mudanças são feitas de forma pontual, sobre o esquema padrão. Para os profissionais, isso é importante, porque não exige reconstruir todo o pipeline de treinamento do agente.
O que os experimentos mostraram
A avaliação foi feita em três tipos de tarefas: ALFWorld — cenários multi-etapa em ambiente textual, WebShop — interação com uma loja online, e perguntas e respostas de busca. Foram testadas três escalas de modelos, de modo que as conclusões não estão presas a um único tamanho.
Resultados em comparação com o GRPO comum:
- +13,3 pontos de sucesso no ALFWorld com um modelo de 7B;
- +11,0 pontos no WebShop na mesma escala.
Além dos números absolutos, há dois efeitos igualmente interessantes. Primeiro, o nível de sucesso estabelecido é alcançado com menos passos de treinamento — ou seja, o método não é apenas melhor no limite, mas também chega mais rápido a uma condição de funcionamento. Segundo, o agente resolve tarefas com orçamentos de interação mais estreitos do que abordagens baseadas apenas na recompensa final e do que métodos anteriores de autodestilação.
O segundo ponto, na minha opinião, é subestimado. A economia de passos de interação não é apenas uma métrica de beleza. Em cenários reais, cada chamada de ferramenta custa dinheiro, tempo e risco. Um agente que chega ao objetivo em cinco ações em vez de dez é mais útil não em 13 por cento, mas várias vezes — especialmente onde o custo do erro é alto.
Por que isso funciona e o que fica de fora
A explicação do método é quase pedagógica. Um bom professor não comenta cada movimento do aluno — ele fica em silêncio enquanto o aluno faz coisas razoáveis e intervém exatamente onde o aluno se desviou do caminho. Se comentar tudo o tempo todo, o aluno deixa de pensar por conta própria e começa a esperar por orientações. Se não comentar nada, ele repetirá os mesmos erros.
O AHEAD formaliza essa intuição em termos de aprendizado por reforço: tipo diferente de passo — fonte diferente de sinal. Feedback denso e ancorado — como pano de fundo, direção corretiva — como ênfase. Nenhuma mágica, apenas a recusa da ideia de que todos os passos são iguais.
O que permanece em aberto. A geração de orientações corretivas por si só exige um modelo e, portanto, adiciona custo computacional e depende de sua qualidade — se o professor explica de forma incorreta, o aluno receberá uma direção confiante, mas errada. Também permanece em aberto até que ponto o método se transfere para tarefas em que o custo de um passo intermediário não é tão óbvio como no ALFWorld ou no WebShop, e em que a "erroneidade" de um passo nem sempre pode ser determinada de imediato, mas apenas por consequências diferidas.
Ainda assim, a direção parece saudável. A linha principal de desenvolvimento dos métodos agênticos dos últimos anos não é aumentar o modelo, mas administrar de forma mais inteligente o sinal de treinamento. O AHEAD é exatamente dessa linha: intervenção pontual em vez de controle total.


