
O juiz em quem é fácil demais acreditar
Modelos multimodais atuam cada vez mais como árbitros: eles olham para uma imagem, um vídeo ou ouvem um áudio e emitem um veredito — se o resultado corresponde à solicitação textual. Esses juízes "onívoros" são usados tanto para avaliar sistemas generativos quanto para anotação automática de dados, quando não há especialistas humanos suficientes para tudo.
A lógica é compreensível: se o modelo consegue entender várias modalidades ao mesmo tempo, por que não confiar a ele a verificação de text-to-image, text-to-video e text-to-speech? Mas aqui se esconde uma questão incômoda. Uma boa precisão final desse juiz ainda não significa que ele realmente vê o que avalia. Os conjuntos de testes e as amostras de treinamento existentes costumam ser enviesados em direção a exemplos bem-sucedidos, e diferentes tipos de falhas são misturados todos juntos.
O resultado é um quadro distorcido. O juiz apresenta números decentes porque aprendeu a dizer "sim", e seus verdadeiros pontos cegos permanecem despercebidos. É justamente esse problema que um novo trabalho do arXiv analisa.
O que os autores propõem: D3-Omni
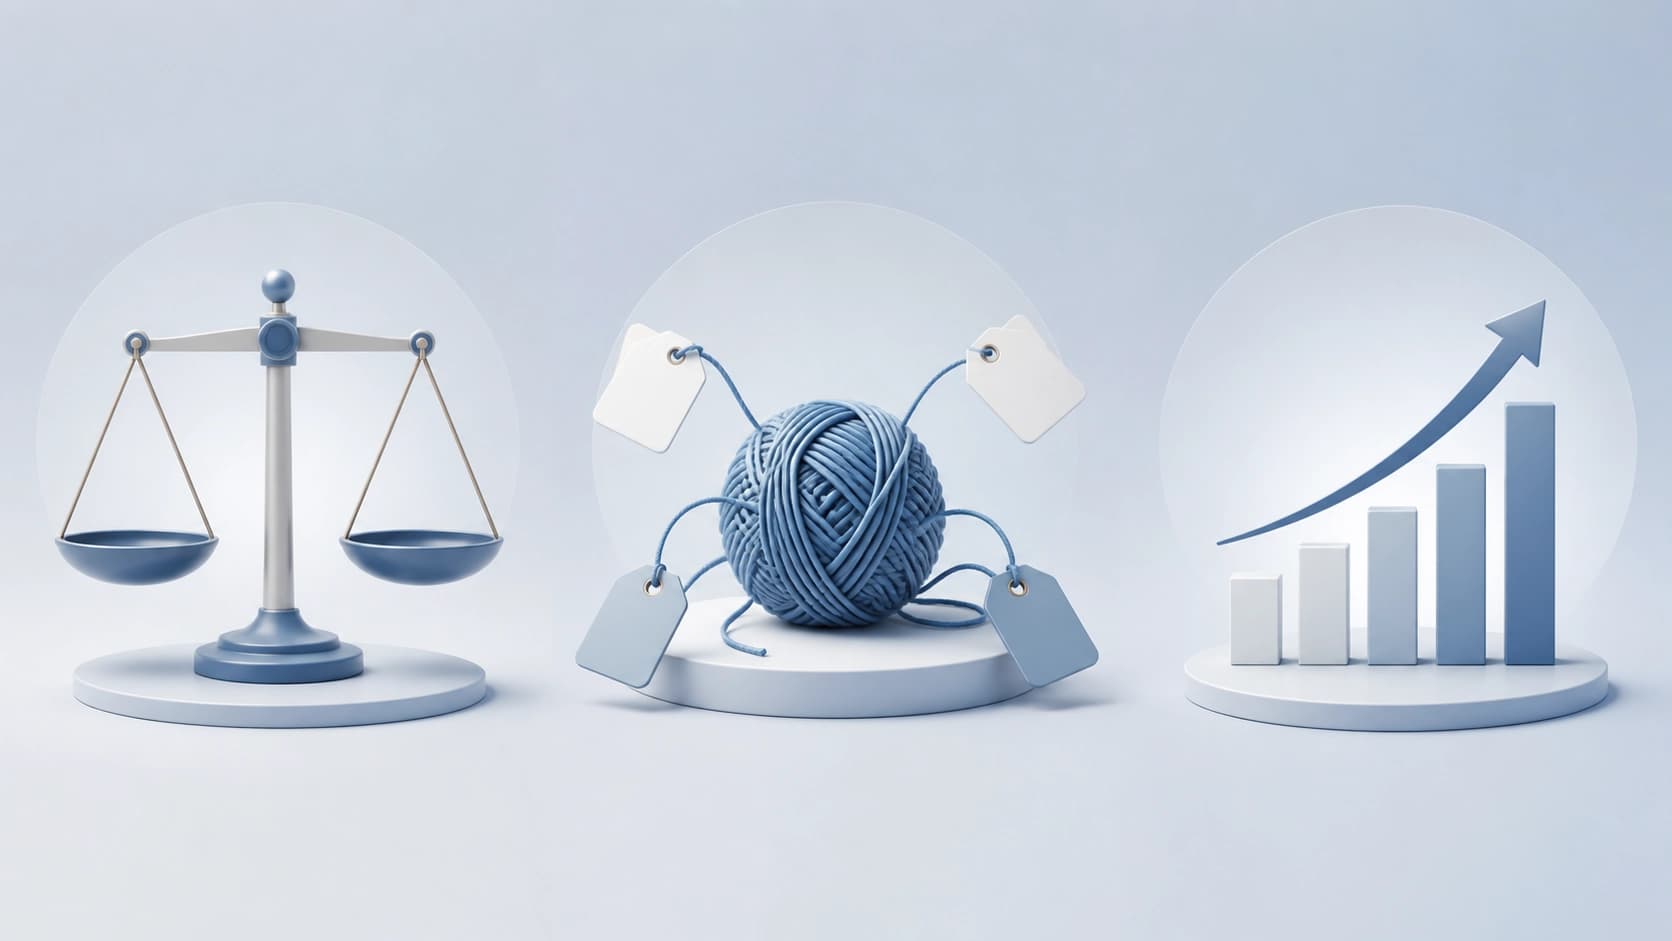
A pesquisa saiu com um título que os próprios autores construíram com base no contraste: "OmniJudge or OmniBias?". Em vez de mais um ranking, eles montaram uma ferramenta de diagnóstico — D3-Omni, um benchmark estruturado de modo a não deixar o juiz se esconder atrás de estatísticas gerais. O nome se desdobra em três princípios, e cada um deles ataca uma fraqueza específica dos testes habituais.
Dual-balanced: o viés em direção ao "tudo bem" é eliminado
O primeiro princípio responde pelo equilíbrio. Em vez de reunir exemplos de qualquer maneira, o conjunto é nivelado: para cada característica verificada deve haver um número comparável de casos bem-sucedidos e de falhas. Assim desaparece a situação em que o modelo acumula pontos simplesmente porque a resposta correta é "sim" com mais frequência.
Decoupled: um erro — uma causa
O segundo princípio é a dissociação. Cada defeito no teste está vinculado a exatamente uma capacidade. Se o juiz errou, fica claro do que exatamente ele não deu conta: compreensão de composição, cor, sincronização de áudio ou outra coisa. Nada de exemplos compostos, em que não se sabe qual das três violações confundiu o modelo.
Dynamic: o teste se adapta ao progresso dos geradores
O terceiro princípio é a dinâmica. A construção do teste é direcionada para onde a representação dos exemplos ainda é insuficiente, à medida que os modelos generativos dominam novas áreas. O objetivo é manter a paridade de aproximadamente um para um em cada característica e um preenchimento uniforme de todos os níveis da pontuação final.
Como o conjunto de dados é estruturado
A escala do D3-Omni é considerável: 53 características binárias, distribuídas por três tarefas (17, 22 e 14 para cada uma), e 10.671 exemplos (3.526, 1.998 e 5.147, respectivamente). As características foram selecionadas de forma ortogonal — elas não se duplicam.
Um detalhe de engenharia à parte é como os exemplos negativos são obtidos. Os autores deliberadamente abriram mão da regeneração das saídas: esse caminho leva a vazamento de informação entre as características, e o teste deixa de ser puro. Em vez disso, pegam "sementes" verificadas como totalmente positivas, e as violações são introduzidas de forma controlada — reescrevendo o prompt e adicionando perturbações pontuais que isolam uma característica.
O que se descobriu: os juízes elogiam com confiança e detectam mal os defeitos
O mais interessante no trabalho não é a estrutura do benchmark, mas o que ele mostrou. Até juízes multimodais fortes tropeçam em características diretamente ligadas à modalidade. Em outras palavras, eles têm dificuldade justamente com aquilo para o que são contratados como avaliadores.
A segunda observação é ainda mais desagradável. Os modelos confirmam de forma bem mais confiável os requisitos cumpridos do que detectam os violados. A assimetria é consistente: dizer "aqui tudo corresponde à solicitação" é bem mais fácil para o juiz do que pegar uma não conformidade específica.
A terceira — atributos nominalmente diferentes o modelo tende a percebê-los como uma única decisão. As diferenças entre as propriedades se apagam, e o juiz emite um veredito generalizado em vez de uma análise ponto a ponto.
Por que a porcentagem agregada engana
Dessas observações surge a conclusão principal: a precisão final pode mascarar pontos cegos sistemáticos. Um juiz que acerta consistentemente a resposta "positiva" vai parecer decente em um conjunto enviesado — e vai falhar onde é preciso detectar um erro do gerador.
Uma ótica equilibrada e dissociada é necessária não para a beleza da métrica, mas para que essas zonas se tornem visíveis. E, uma vez vistas, podem ser fechadas de forma direcionada: com treinamento adicional nas características problemáticas, em vez de correr atrás da pontuação média.
Na prática, isso significa uma coisa simples. Se você monta um pipeline em que o modelo-juiz filtra resultados de geração ou anota um dataset, é preciso testá-lo em um conjunto enviesado em direção aos negativos, e não em uma amostra conveniente de exemplos bem-sucedidos. Caso contrário, o avaliador vai deixar passar os defeitos, e você vai saber disso pelos usuários, não pelas métricas.
Em resumo
- D3-Omni é um benchmark para diagnóstico de juízes multimodais, e não um ranking de modelos.
- Três princípios: equilíbrio entre exemplos positivos e negativos, vinculação de cada erro a uma capacidade, adaptação do teste ao desenvolvimento dos geradores.
- 53 características e quase 11 mil exemplos nas tarefas text-to-image, text-to-video e text-to-speech.
- Os negativos são criados reescrevendo prompts e com perturbações pontuais, e não por regeneração — para não misturar as características.
- Conclusão principal: um resultado médio alto pode esconder pontos cegos consistentes, especialmente onde é preciso notar uma violação, e não confirmar uma conformidade.


