
Dados brutos em vez de tabelas prontas
Os modelos atuam cada vez mais como agentes de código: recebem a tarefa de escrever scripts para processar dados, construir gráficos, calcular métricas, analisar extrações de engenharia. Mas há uma classe de tarefas que até agora quase não foi testada — o trabalho com a "matéria-prima" do nível físico. É exatamente essa lacuna que o benchmark EMRB (Electromagnetic Reasoning Benchmark) preenche, descrito no preprint arXiv:2608.24086 (seções cs.AI, cs.CE, cs.SE).
A ideia central é simples e, por isso, convincente. Na entrada — apenas registros I/Q brutos, ou seja, amostras em quadratura do sinal, como chegam do receptor. Nenhuma característica pré-processada, nenhum espectrograma com rótulos e muito menos tabelas com valores prontos. A grandeza à qual a pergunta se refere deve primeiro ser detectada pela própria modelo nos dados — por meio de código que ela mesma escreverá e executará.
Em que isso difere das medições habituais
Nos últimos anos surgiram diversos conjuntos de tarefas em que se propõe que os modelos raciocinem sobre sinais de rádio. Mas, na maioria das vezes, o trabalho já foi feito no lugar do modelo: extraíram-se características do registro, calculou-se o espectro, estimou-se o nível de ruído, reuniu-se tudo numa tabela estruturada. Nessa formulação, resta apenas aritmética e comparação de números — habilidades úteis, mas sem relação com a radiofísica.
A diferença é fundamental. Quando as grandezas são dadas de antemão, o erro do modelo numa etapa inicial não fica visível: uma estimativa incorreta de banda ou frequência simplesmente não surge, porque esses valores foram fornecidos no enunciado. Quando os dados são brutos, qualquer erro na etapa de reconhecimento do sinal arrasta consigo todo o cálculo subsequente. Por isso o EMRB não testa o conhecimento de termos, mas a capacidade de construir uma cadeia: olhar para as amostras, entender que sinal é aquele, extrair a característica necessária, calculá-la corretamente e não perder as dimensões.
Como o benchmark está estruturado
Os autores — Mingxu Zhang, Ying Sun, Yuhan Li, Yang Ji, Dazhong Shen, Ke Zhang e Shan Huang — reuniram 200 tarefas. As tarefas estão distribuídas em cinco níveis de dificuldade e 27 tipos de perguntas: da detecção trivial de sinal até o projeto de um sistema OFDM. A fonte do material são 11 tipos de sinais, para cada um dos quais foi preparada uma verdade de referência verificada.
Cinco níveis
Os níveis estão organizados pelo aumento da autonomia do modelo. Na base — medições de parâmetros básicos: encontrar o sinal, estimar suas características. Acima — interpretação e comparação, depois análise com vários passos, em seguida diagnóstico e, por fim, projeto de sistema, onde se exige do modelo não medir, mas projetar uma solução sob requisitos dados.
27 tipos de perguntas e 11 tipos de sinais
Essa variedade é necessária para que o resultado não dependa de uma formulação feliz ou infeliz. Diferentes tipos de sinais criam diferentes armadilhas: em alguns casos o ruído atrapalha, em outros — a sobreposição espectral, em outros ainda é preciso lidar com cuidado com a discretização. O número de tipos de perguntas e de sinais, juntos, forma um espaço no qual é difícil acertar por acaso.
Dados abertos
Todos os materiais e o código estão disponíveis num repositório público do GitHub, de modo que o resultado pode ser verificado de forma independente. Para um benchmark, isso é mais importante do que o habitual: se as tarefas são geradas, e não coletadas manualmente a partir de registros de campo, a questão da correção das referências torna-se central — e a abertura aqui é a única resposta que funciona.
O que os modelos mostraram
Foram testados 14 modelos de linguagem: proprietários, de pesos abertos e, separadamente, modelos voltados ao raciocínio. A variação final — de 24,1% a 78,9%. Só esse intervalo já diz muito: a diferença entre o melhor e o pior modelo aqui se mede não em porcentagens, mas em múltiplos.
Mas há algo mais interessante. O resultado médio cai bruscamente à medida que o nível se torna mais complexo: de 84,9% nas medições básicas até 21,2% no projeto de sistema. Ou seja, os modelos se saem razoavelmente bem quando é preciso calcular uma grandeza mensurável, e quase desmoronam quando é necessário montar, a partir dessas grandezas, uma solução que funcione.
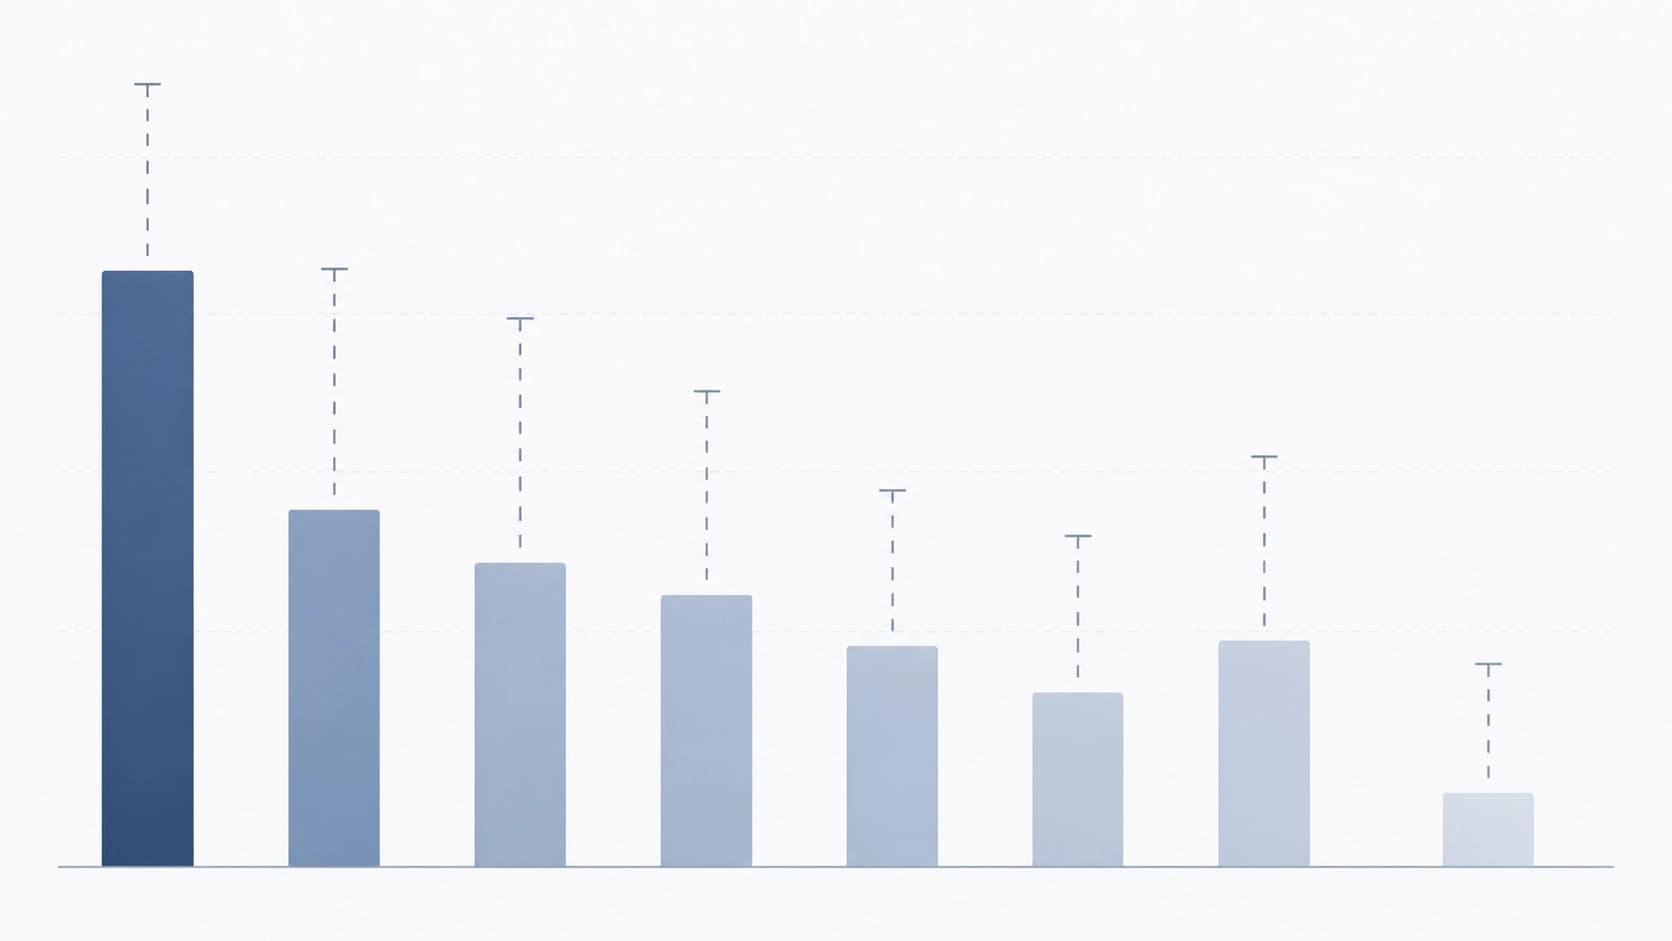
Isso deve ser lido como um diagnóstico, não como um ranking. O ponto forte dos modelos atuais é a execução de código e a aritmética sobre uma formulação conhecida. O ponto fraco é a tradução de uma tarefa de engenharia para a linguagem de passos mensuráveis: entender quais grandezas são necessárias, em que ordem buscá-las, como verificar se o que foi encontrado sequer se parece com a verdade. É justamente essa lacuna que torna o benchmark útil.
ReconPilot: reconhecimento, análise, verificação
Os autores não se limitaram a medir. Propuseram o ReconPilot — uma abordagem estruturada em que o trabalho é dividido em três etapas: reconhecimento do sinal, análise direcionada e autoverificação. Primeiro, o modelo estuda o registro e forma uma representação daquilo com que está lidando. Depois, resolve a tarefa concreta. Em seguida, retorna ao seu resultado e o verifica quanto à consistência.
Em três modelos de base, o método acrescenta à pontuação geral de 3,8 a 17,6 pontos. A melhoria foi alcançada em 13 das 15 combinações "backbone + nível" testadas. Preste atenção na formulação: o ganho não é uniforme e, em dois casos, não existe de todo. Isso é um sinal normal de um experimento honesto — não se encontrou uma solução universal, mas a tendência é consistente.
É revelador que o que ajuda é justamente a separação explícita das fases. Um modelo ao qual se pede simplesmente "analise o sinal" tende a saltar para os cálculos sem se assegurar de que compreendeu os dados. O reconhecimento como etapa obrigatória separada força primeiro a olhar, e só depois calcular.
O que se conclui disso
Para a prática de engenharia, a conclusão é bastante direta: antes de confiar a um agente cálculos sobre medições reais, vale a pena testá-lo com dados sem dicas. Uma interface conveniente e uma resposta fluida no chat não dizem nada sobre se o modelo sobreviverá ao encontro com uma extração não preparada de um receptor.
Há também uma ideia mais geral, que ultrapassa o domínio do rádio. Em qualquer área em que o raciocínio se apoie em medições brutas — hidroacústica, vibrações, telemetria —, o agente deve ser capaz de primeiro encontrar a grandeza nos dados e só depois trabalhar com ela. Tabelas com características escondem essa parte do trabalho e, junto com ela, escondem os erros.
Limitações e o que vem a seguir
Não se pode dizer que a questão esteja totalmente encerrada. 200 tarefas é um volume razoável, mas não ilimitado, e a geração com base em 11 tipos de sinais significa que registros de campo reais, com todos os seus artefatos, ainda não estão representados ali. A avaliação de 14 modelos é um recorte do momento, não uma sentença: a composição dos líderes nessa área muda rapidamente.
Ainda assim, a formulação da tarefa parece correta. Se queremos que os LLMs trabalhem não com a paráfrase dos dados, mas com os próprios dados, devemos testá-los exatamente onde as dicas acabam. O EMRB faz exatamente isso — e mostra que a margem de crescimento dos modelos no reconhecimento de sinais ainda é muito grande.


