
Problema: o trace do agente é um log, não um modelo de comportamento
Um agente LLM de múltiplos passos deixa para trás um longo rastro: chamadas de ferramentas, raciocínios intermediários, correções, novas tentativas. Ler isso a olho nu é quase inútil — centenas de linhas de texto, onde o sinal útil está espalhado por todo o volume. Para o desenvolvedor que coloca um agente em produção, esse log se transforma em uma caixa-preta: não se entende nem onde exatamente a execução saiu dos trilhos, nem quais estados são típicos do sistema.
É exatamente sobre isso o trabalho arXiv:2608.23670 (cs.AI) "Automata from Agent Traces: Failure and Next-Step Prediction" — seus autores Seonglae Cho, Franklin Cardenoso Fernandez, Umar Mohammed, Zekun Wu, Kleyton Da Costa, Ilham Wicaksono e Adriano Koshiyama propõem olhar para os traces não como texto, mas como dados sobre transições entre estados. A lógica é simples: se o comportamento do agente se repete de execução em execução, então por trás do caos aparente existe uma estrutura, e ela pode ser reconstruída.
Vale destacar separadamente o que faltava às abordagens anteriores. A análise geralmente era feita trace a trace, ou se baseava apenas em execuções bem-sucedidas. Em ambos os casos, perde-se o quadro geral — aquela topologia que conecta entre si a previsão da próxima ação e a previsão de falha. E é justamente ela que é necessária tanto para auditoria de segurança quanto para monitoramento em tempo real.
Um único autômato para todo o corpus
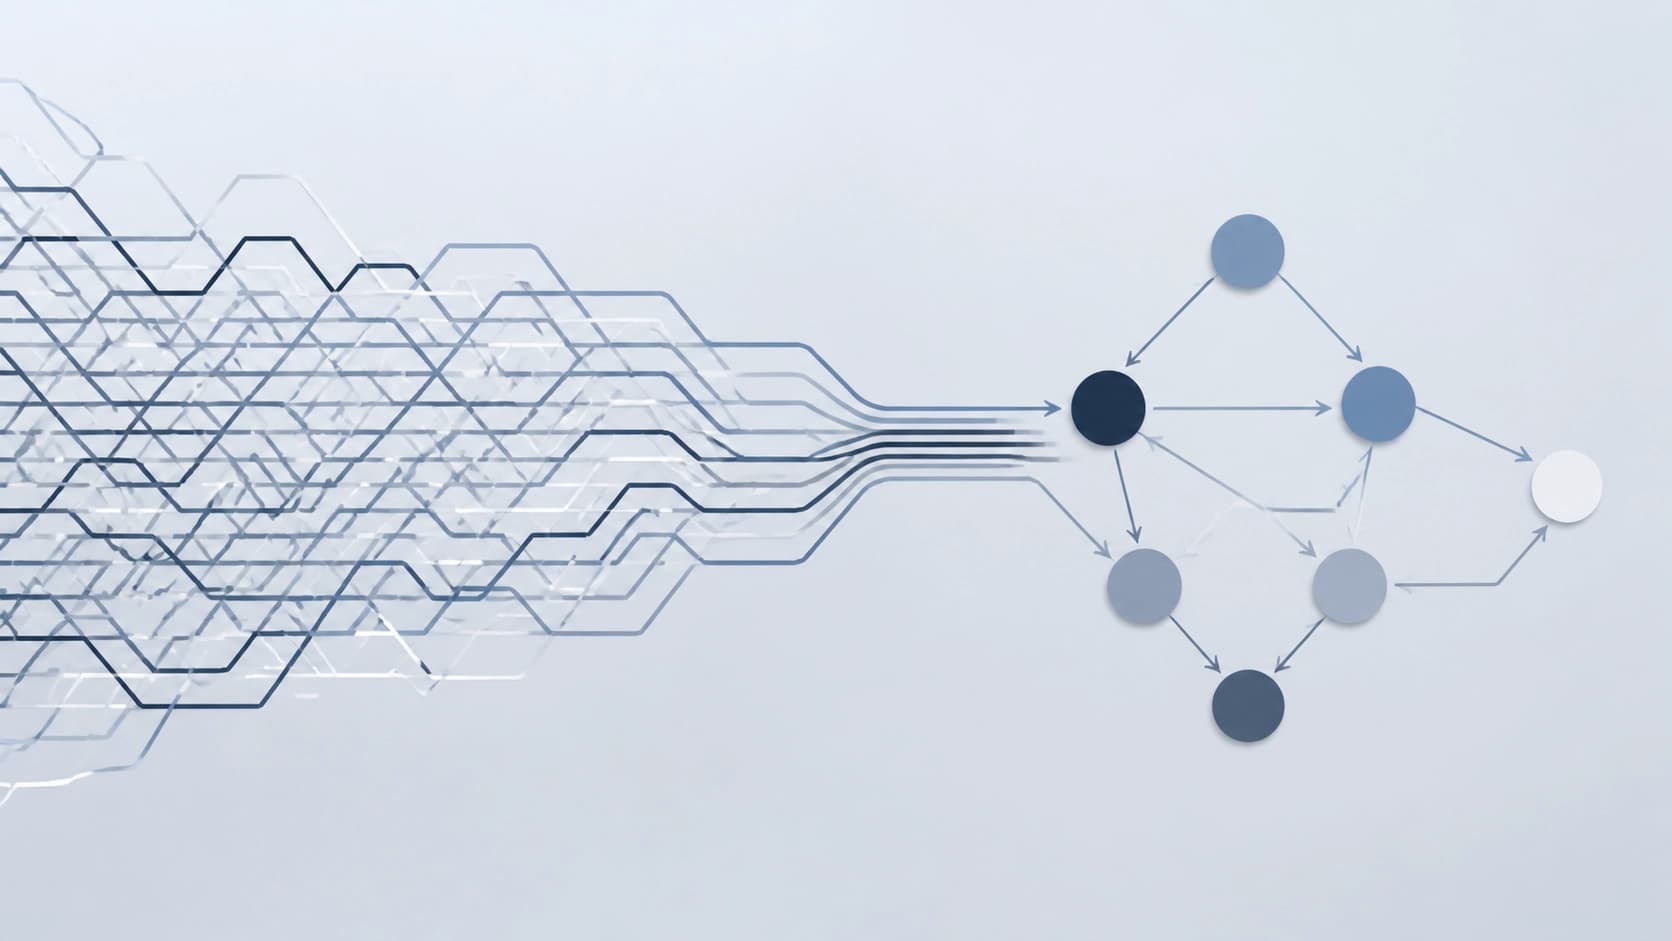
A ideia do método: pegar todo o conjunto de traces e reduzi-lo a uma única máquina de estados finitos (FSM) compacta. Não uma árvore de decisão para cada execução, não embeddings em algum espaço vetorial, mas um grafo comum com estados e transições — aquele mesmo substrato estrutural que torna o comportamento do agente, se não previsível, ao menos descritível.
Os resultados em doze datasets públicos parecem promissores:
- os autômatos ficam pequenos — de 7 a 43 estados, ou seja, dá para desenhá-los e discuti-los em uma reunião;
- em dados reservados, eles reproduzem os traces com fitness não inferior a 0.997 — uma correspondência quase perfeita;
- a topologia construída em diferentes divisões de um mesmo dataset acaba sendo praticamente idêntica;
- a própria montagem leva milissegundos, não horas de treinamento.
O último ponto é mais importante do que parece. Um método que se constrói instantaneamente pode ser remontado após cada alteração de prompt ou configuração — e imediatamente mostrar se o comportamento do sistema mudou.
Por que isso não é apenas uma visualização bonita
A compacidade aqui não é um fim em si. Quando você tem 20 estados em vez de milhares de linhas de texto, surge a possibilidade de raciocinar sobre os modos de operação do agente: aqui está o ciclo "tentei — recebi erro — repeti", ali está o ramo "a tarefa foi para perguntas de esclarecimento", e aqui um estado raro do qual quase não há saídas. Depois, com esses modos é possível trabalhar de forma de engenharia — por exemplo, construir features calculadas para cada estado.
Previsão do próximo passo: o estado importa mais que a memória
Para prever a próxima ação do agente, os autores usam o contexto de estado da FSM. E essa abordagem supera o Agent Workflow Memory em cada dataset onde a anotação é consistente com o curso real da execução. Em outras palavras, saber "em que modo o agente está agora" se mostra mais útil do que a memória acumulada de episódios anteriores de trabalho.
Há um detalhe interessante aqui. O contexto de estado não é apenas o número do nó, mas uma descrição comprimida do que já aconteceu e com que probabilidade acontecerá a seguir. Obtém-se uma espécie de mapa de continuações prováveis, construído não sobre a semântica do texto, mas sobre a estatística das transições. Na prática, isso significa que o preditor do próximo passo pode ser treinado de forma mais barata: ele não precisa de acesso aos estados ocultos do modelo, basta a estrutura.
Previsão de falha e monitoramento por trace parcial
A segunda metade do trabalho é sobre diagnóstico. As features calculadas para estados individuais do autômato dão AUROC de até 0.94 em dados reservados. Ou seja, um modelo que nada sabe sobre as entranhas do LLM, com base em características comportamentais, distingue execuções que terminarão em falha daquelas que chegarão até o fim.
O mais prático aqui é o monitor online. Ele observa um trace incompleto e classifica execuções com falha acima das bem-sucedidas, sem esperar pelo desfecho. Isso é suficiente para acionar uma parada antecipada muito antes de o agente definitivamente sair dos trilhos: economizar tokens, tempo e, mais importante, não deixá-lo causar dano. Para agentes que escrevem em bancos de dados, chamam APIs de pagamento ou gerenciam infraestrutura, essa possibilidade de interromper a execução no meio não é um luxo, é um requisito.
Conclusão principal: o comportamento é definido pelo harness, não pelo modelo
Talvez a tese mais provocativa do artigo soe assim: a topologia comportamental do agente é em grande medida determinada não pelo próprio modelo de linguagem, mas pelo deployment harness — aquele arcabouço no qual o modelo é executado. O template de prompt, o conjunto de ferramentas, as regras de tratamento de erros, os limites de passos — é isso que forma o grafo de transições.
Disso decorrem várias conclusões. Primeiro, substituir o modelo por outro com o mesmo harness pode não mudar radicalmente a estrutura do comportamento — e, portanto, vale a pena testar em outro modelo o autômato construído sobre um. Segundo, muitas vezes é mais eficaz melhorar o agente por meio de mudanças no harness do que por meio de um upgrade dos pesos. Terceiro, surge um primitivo estrutural model-agnostic: a mesma abordagem serve tanto para auditoria de segurança quanto para monitoramento em runtime, independentemente de qual API você chama.
O que vale ter em mente
A abordagem não dispensa cautela. Doze datasets ainda são uma amostra limitada, e o fitness de 0.997 diz respeito a quão bem o autômato descreve traces já coletados, não a que ele preverá o comportamento do sistema em um ambiente desconhecido. O AUROC alto para previsão de falha também foi obtido em tarefas específicas: em novos domínios, as features terão de ser recalculadas.
E ainda assim a direção parece sensata. Em vez de aumentar infinitamente a janela de contexto e esperar que o modelo "se vire sozinho", é possível construir uma vez um modelo compacto do comportamento do seu harness — e depois usá-lo como um mapa: ver onde o agente trava, quais estados levam à falha e o que mudará se a configuração for ajustada. O autômato não é mais inteligente que o LLM, mas é mais honesto: ele cabe inteiramente na cabeça, e isso já é metade do sucesso na depuração.


