
149 edições de laboratórios reais: novo benchmark testa se os LLMs sabem reescrever protocolos
O BenchBench-Protocol propõe aos modelos não perguntas abstratas, mas episódios reconstruídos da prática: um cientista adaptou uma metodologia publicada ao seu experimento — e o modelo deve reproduzir o percurso do seu raciocínio. Das nove sistemas testados, o melhor resultado foi de 59,2% na rubrica, e os demais ficaram na faixa de 34–47%.
O protocolo que ninguém segue à risca
Um protocolo de laboratório raramente é executado literalmente. Entre a publicação e o experimento real quase sempre há uma adaptação: outra linhagem celular, um reagente substituído, menos amostras, um equipamento diferente, um orçamento reduzido. Para quem trabalha na bancada, isso é rotina, mas uma rotina traiçoeira — qualquer alteração puxa uma cadeia de consequências. Você muda o volume de um reagente numa etapa inicial e precisa lembrar o que isso vai implicar na etapa de lavagem e como se harmoniza com o que já foi feito antes. É justamente essa capacidade — manter o protocolo inteiro em mente e modificá-lo com sentido — que o novo conjunto de tarefas avalia.
O estudo saiu com o nome BenchBench-Protocol, num preprint do arXiv:2608.23898v1 (cs.AI), submetido em 24 de agosto de 2026. Os autores são Aditya Sivakumar, Ashu Singhal, Nicholas Larus-Stone e Nithin Parsan. São 21 páginas e 15 figuras, ou seja, um material mais metodológico do que publicitário.
Como 149 tarefas foram montadas a partir de rascunhos de edições
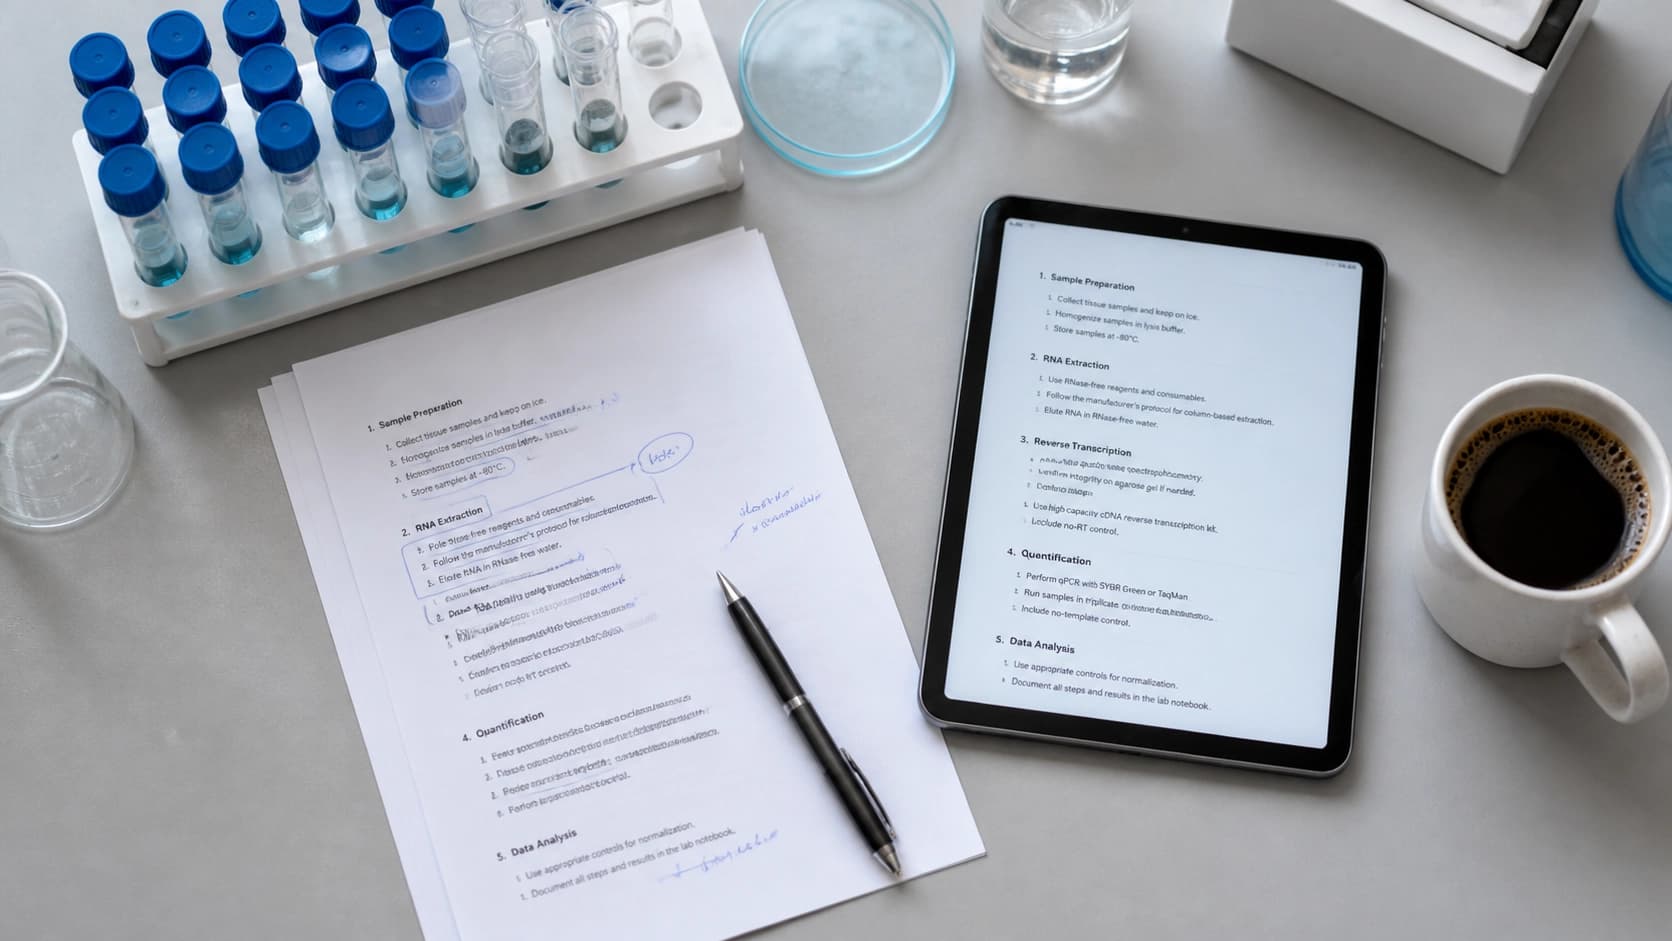
A mecânica do BenchBench-Protocol é incomum. Os autores não se sentaram para escrever perguntas — eles partiram de um rastro de trabalho já existente. Cada protocolo publicado tinha uma versão que o cientista ajustou para seu experimento específico. A diferença entre esses dois documentos se tornou a tarefa: mostra-se à modelo o protocolo original e as condições do novo experimento, e ela deve propor a modificação correta.
Dessa abordagem decorre imediatamente um detalhe importante: a tarefa não tem uma "resposta correta" abstrata, mas uma rubrica ponderada. Isso porque a edição feita pelo pesquisador real é conhecida — pode ser decomposta em elementos e avaliada conforme o quanto a proposta da modelo se aproxima da solução real em sentido, e não em formulação. Isso resolve o problema eterno dos testes biomédicos, em que a modelo pode dar uma resposta razoável, mas que não coincide com o gabarito, e receber zero.
A base ficou sólida: 96 protocolos originais de nove áreas da biologia de experimento em laboratório úmido. No conjunto final entraram apenas as tarefas que passaram por verificação especializada com notas altas — o restante foi descartado. O resultado são exatamente as tais 149 tarefas.
Por que este não é mais um conjunto de perguntas de especialistas
Os autores explicitam o contexto à parte. Nos últimos anos, os benchmarks biomédicos de fato se deslocaram na direção de tarefas abertas com avaliação por rubricas — isso é um avanço. Mas as próprias tarefas continuam, na maioria das vezes, sendo inventadas por especialistas: eles se sentam e escrevem perguntas com base na própria experiência. Essa abordagem é limitada pelo fato de que o especialista responde a uma pergunta que ele mesmo formulou, ou seja, ajusta-se implicitamente à sua própria noção de dificuldade.
Aqui a lógica é inversa. A tarefa surge onde uma pessoa real já esbarrou num problema real e gastou tempo para resolvê-lo. Isso não garante pureza ideal dos dados, mas garante que o probleminha não foi inventado em nome de uma formulação bonita.
Quem deu conta e quem não deu
Nove modelos participaram do teste — tanto fechados quanto abertos. A dispersão foi notável, embora não dramática.
O melhor resultado foi do Claude Opus 5 — 59,2% de pontuação normalizada pela rubrica. Os demais modelos ficaram na faixa de 34,1% a 47,1%. Em outras palavras, ninguém alcançou o líder, mas também não há um fracasso pela metade: todos os modelos sabem fazer alguma coisa, só que o fazem de maneiras diferentes e nem sempre até o fim.
Uma linha à parte do relatório é o teste de saturação. Os autores deram aos modelos dez tentativas e escolheram a melhor delas (best-of-10). Mesmo com esse esquema generoso, o benchmark não "colapsou": o teto não foi atingido. Para a avaliação, isso é uma boa notícia — significa que o conjunto de tarefas não vai ficar obsoleto depois do lançamento da próxima geração de modelos.
O que disso decorre na prática
A primeira conclusão é prática e um pouco sóbria. Ainda não se pode confiar totalmente a um modelo de linguagem a adaptação de um protocolo. Mesmo o melhor resultado, de 59,2%, significa que em cerca de quatro casos em cada dez a proposta exige intervenção humana. A modelo serve como rascunho, como geradora de variantes, como forma de conferir rapidamente aquilo que você talvez tenha deixado passar. Mas a responsabilidade final pelo tubo de ensaio não é dela.
A segunda conclusão é metodológica, e é mais interessante que a primeira. Os autores encaram seu trabalho não apenas como uma avaliação de raciocínio em laboratório úmido, mas também como prova de uma ideia mais geral: experimentos reais são uma fonte subestimada de tarefas para benchmarks. Se no laboratório já existe um histórico de edições, então também há material para testar modelos — e um material que é impossível inventar sentado à escrivaninha.
A terceira conclusão diz respeito a para onde ir daqui. A diferença entre 59,2% e 47,1% não parece um abismo diante da complexidade da própria tarefa. É mais um indício de que o gargalo não está no volume de conhecimento da modelo sobre biologia, mas na capacidade de construir uma cadeia: levar em conta decisões anteriores e prever aonde elas vão levar nas etapas seguintes. É a essa qualidade, e não à memorização de fatos, que se dedica o conjunto das 149 edições.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Toollery: seleção de ferramentas para agentes LLM entre dezenas de milhares de opções sem fine-tuning
A Toollery cria um índice de pesquisa com base nas descrições de competências e ferramentas e, a cada consulta, transmite ao modelo apenas um conjunto limitado de candidatos. Em testes com bibliotecas de dezenas de milhares de funções, a abordagem permite manter a qualidade da seleção com um top-K fixo, embora o efeito final dependa do perfil de carga e do cache do fornecedor.
11 novembro 2026
Diagnóstico passo a passo de agentes GUI na análise de dashboards: benchmark DashAct
Apresentamos o DashAct — um benchmark com 348 trajetórias verificadas por humanos, que divide o trabalho de agentes GUI com painéis interativos em três etapas e quatro condições visuais. Os resultados revelam problemas persistentes na previsão de ações e na associação a alvos visuais, bem como a dependência das respostas dos agentes do suporte contextual e espacial.
11 novembro 2026
WILSON: integração de ampliações e lâminas de pacientes para análise anatomopatológica e elaboração de laudos
O preprint apresenta o WILSON — um modelo de visão e linguagem que codifica imagens de lâminas inteiras e séries de preparações de um mesmo paciente em diferentes ampliações, em vez de apenas uma lâmina «melhor». Sem ajuste fino para a tarefa, supera modelos especializados e maiores para lâminas em várias métricas, com uma carga computacional substancialmente menor, e as suas descrições diagnósticas receberam avaliações mais elevadas dos patologistas.
11 novembro 2026