
Vetor molecular como infraestrutura
Na química computacional, o embedding de uma molécula há muito deixou de ser um detalhe técnico. É uma infraestrutura reutilizável: uma mesma representação vetorial atende tanto à previsão de propriedades de um composto quanto à triagem virtual e à busca de moléculas semelhantes. Calcula-se uma vez — e você a aplica em dezenas de cenários, do ranqueamento de bibliotecas à seleção de candidatos para o laboratório.
O beco sem saída de uma única representação
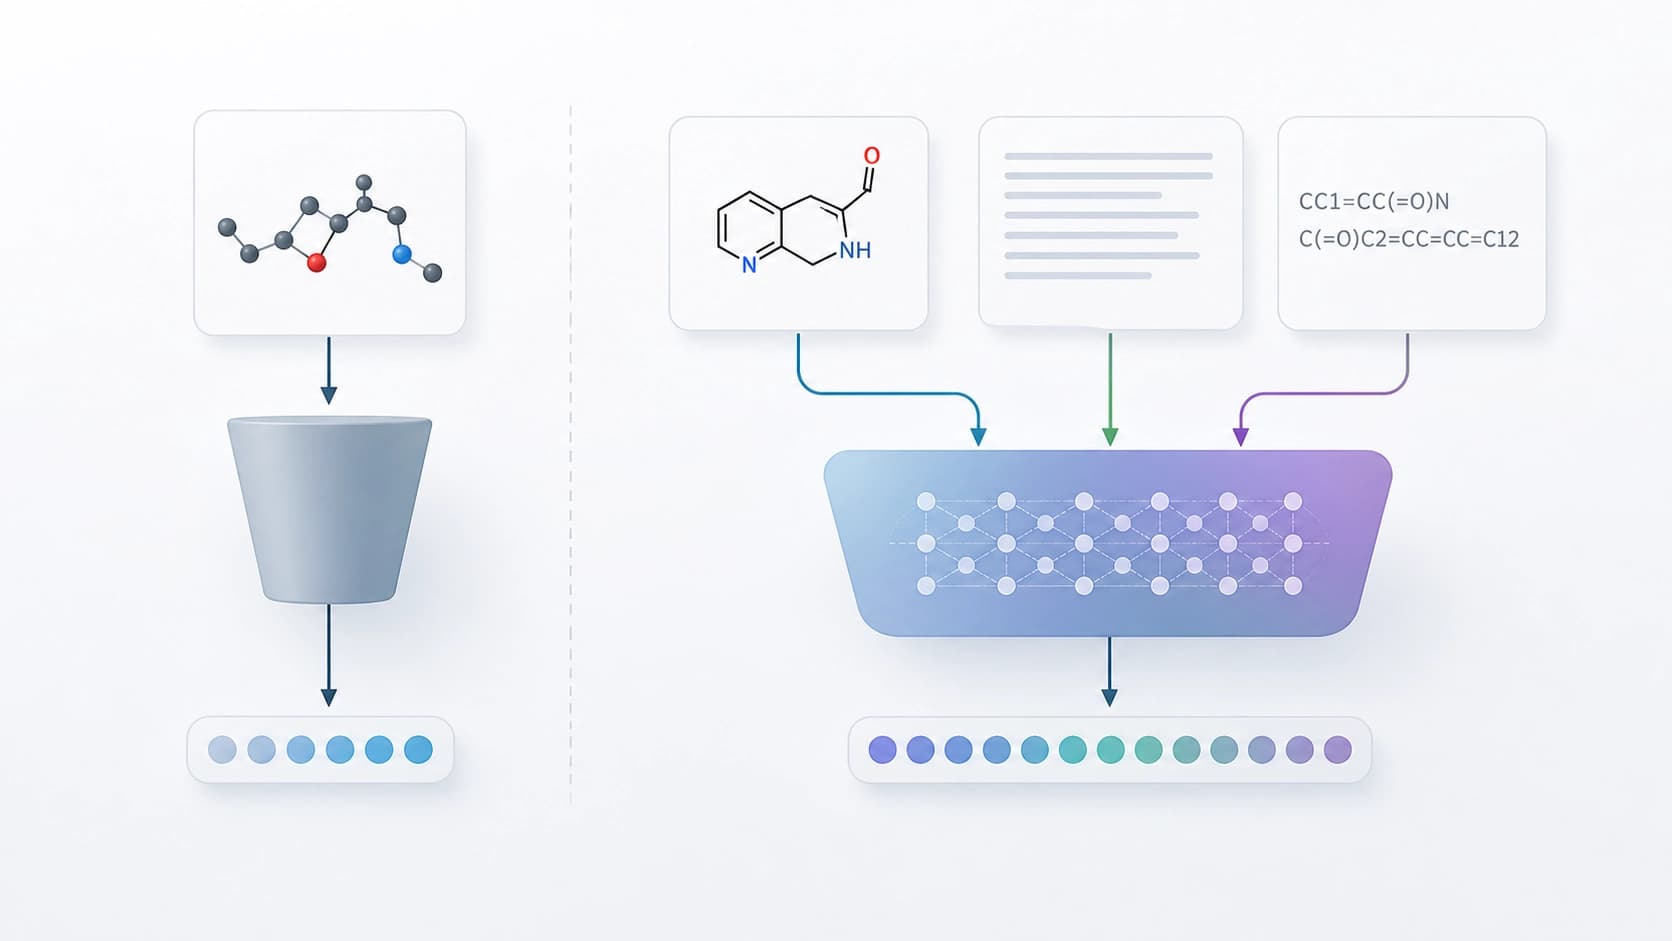
Quase todos os codificadores moleculares seguem um mesmo esquema: escolhe-se uma única modalidade — grafo de átomos, string SMILES, conjunto de descritores físico-químicos ou conformação 3D — e o modelo é treinado estritamente nela. O vetor resultante é incondicional. Não há interface por meio da qual se possa refinar a consulta: "preciso de um análogo pelo mecanismo de ação, não pelo esqueleto de carbono" ou "um composto semelhante, mas com foco em solubilidade".
Daí decorre um efeito desagradável. Modelos diferentes enxergam a mesma molécula de maneiras distintas, e não é possível comparar suas representações diretamente — os espaços não são alinhados. O químico, por sua vez, é obrigado a manter em mente qual codificador serve para qual tarefa, em vez de simplesmente formular a tarefa em palavras.
A pergunta que os autores fizeram
O trabalho de Xinjian Zhao, Xiangru Jian, Yaoyao Xu, Xiaozhuang Song, Wei Pang, Lei Bai e Tianshu Yu (arXiv:2608.23646, 24 de agosto de 2026; apresentado no workshop FM4LS no âmbito do ICML 2026, non-archival) começa exatamente dessa insatisfação. Os pesquisadores se perguntam: por que construir um codificador separado para cada representação de molécula, se os LLMs multimodais já sabem trabalhar nativamente com imagens, texto e notações simbólicas?
A lógica é simples. Se o modelo já "vê" a imagem da fórmula estrutural, lê a descrição e interpreta o SMILES, ele pode ser transformado não em um assistente-consultor, mas em um gerador de vetores. E vetores condicionados — que dependem não só da própria molécula, mas também do que se pergunta sobre ela em linguagem natural.
Como o framework é estruturado
O MolEmb é uma camada leve, e não um novo modelo grande. Ele adapta uma MLLM já existente para que perfis moleculares e suas descrições textuais fiquem em um mesmo espaço comum de embeddings. O elemento-chave é um objetivo contrastivo bidirecional: ele aproxima pares "molécula — texto" e, ao mesmo tempo, afasta pares que não correspondem.
Por que isso é mais importante do que parece
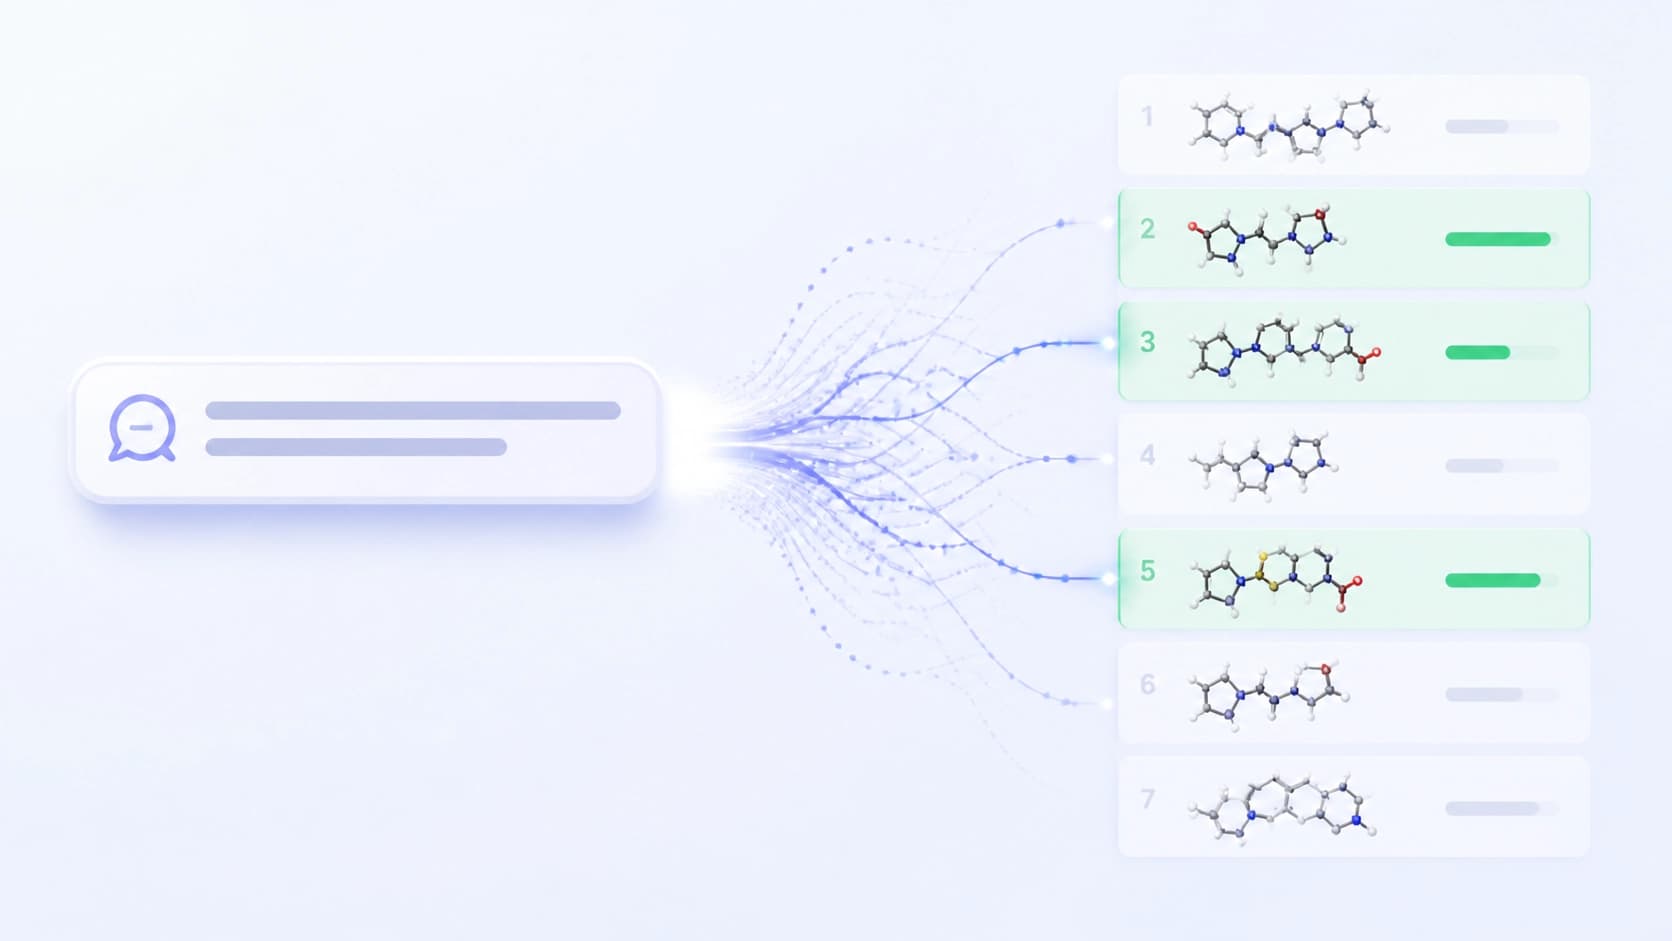
O aprendizado contrastivo resolve aqui duas tarefas de uma só vez. Primeiro, ele define um sistema de coordenadas comum: o vetor da molécula e o vetor de sua descrição tornam-se comparáveis. Segundo, ele possibilita a busca cross-modal nos dois sentidos — encontrar texto a partir da molécula, encontrar molécula a partir do texto —, e dentro de um mesmo espaço, sem tradutores intermediários entre modalidades.
O resultado declarado é mais modesto do que "batemos todos os benchmarks", e por isso mesmo mais verossímil: as representações obtidas são competitivas na previsão de propriedades moleculares e, ao mesmo tempo, suportam a busca entre modalidades. Ou seja, a interface em linguagem não foi comprada ao custo da degradação das tarefas clássicas.
A linguagem como alavanca de controle
A principal diferença em relação aos codificadores tradicionais está no condicionamento. Um modelo especializado devolve, para uma molécula, um único vetor fixo. O framework, por sua vez, permite formular uma condição em palavras e obter uma representação deslocada na direção dessa condição. A mesma molécula pode ser representada de maneiras diferentes dependendo de você se interessar por toxicidade, solubilidade ou proximidade de uma classe específica de compostos.
Busca molecular que depende do contexto
Uma parte separada do trabalho é o benchmark diagnóstico MolCAR. Ele foi criado para testar a busca dependente de contexto, ou seja, situações em que a resposta correta muda conforme a formulação da consulta. Isso é fundamentalmente mais difícil do que a busca clássica por estruturas semelhantes: ali a referência é única, aqui ela depende do enunciado da tarefa.
A conclusão mais interessante
Talvez a observação mais valiosa dos autores soe quase banal: o embedding molecular dependente de contexto é, antes de tudo, uma propriedade dos dados de supervisão, e não um truque de arquitetura. Em outras palavras, o modelo começa a distinguir contextos não porque se embutiu nele um módulo engenhoso, mas porque foi treinado em pares nos quais o contexto realmente difere.
A conclusão é sóbria e útil ao mesmo tempo. Ela desloca o foco da corrida por arquiteturas para a qualidade e a estrutura dos dados de treinamento: se as descrições das moléculas no dataset são uniformes, nenhuma multimodalidade dará ao modelo sensibilidade aos nuances da consulta.
O que isso muda na prática
Se essa abordagem escalar, o ganho é o seguinte:
- Infraestrutura única em vez de um zoológico de codificadores. Um único modelo cobre tanto propriedades quanto busca e consultas cross-modais.
- Consulta em palavras em vez de escolha de modelo. O usuário não precisa saber qual codificador é melhor para o seu caso.
- Espaços compatíveis. Vetores de moléculas e de textos convivem juntos, o que significa que podem ser comparados e combinados.
- Reaproveitamento de MLLMs prontas. O framework adapta um modelo existente, em vez de treinar do zero.
Limites e questões em aberto
O trabalho está marcado como non-archival, o que significa que estamos diante mais de uma direção do que de um produto pronto. Restam muitas questões: até que ponto a abordagem é robusta fora dos conjuntos de dados testados, como ela se comporta em classes raras de compostos, se a parte linguística não começa a dominar sobre a química e se isso não transforma o vetor em uma paráfrase do texto, em vez de uma representação fisicamente significativa.
Ainda assim, a ideia central se formula com clareza. Os LLMs multimodais não são apenas assistentes químicos nem apenas geradores de respostas. Eles reivindicam o papel de mecanismo geral de embeddings moleculares: extensível, controlável por palavras e aberto ao ajuste fino para novas tarefas.


