
Em resumo: onde exatamente dói
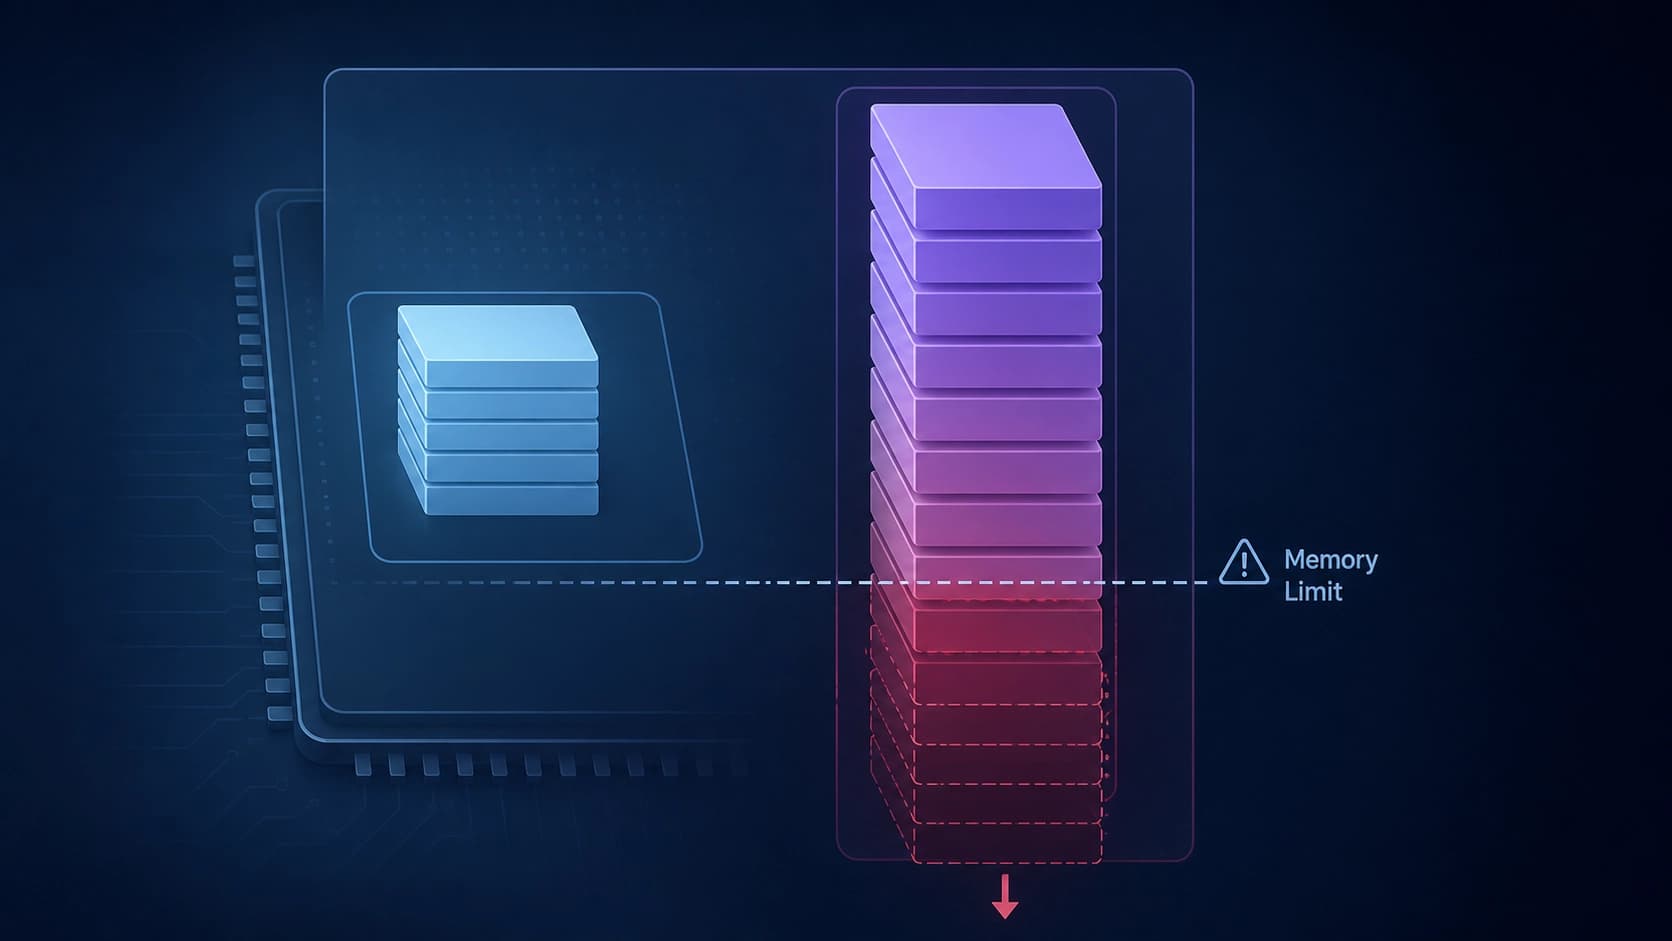
Quando um modelo de contexto longo atende uma requisição, os principais custos não vão para os pesos, mas para o KV-cache — as chaves e valores salvos para todos os tokens já lidos. Quanto mais longo o documento ou o diálogo, mais tensores precisam ser mantidos na memória e mais dados precisam ser relidos a cada passo de geração. Daí o dilema típico: ou cortar o contexto, ou pagar por ele em memória e velocidade de inferência.
As soluções existentes geralmente escolhem um dos dois extremos. Ou comprimem todo o estado de uma vez, correndo o risco de perder informações recentes, que são justamente as necessárias para a próxima resposta, ou mantêm tudo na precisão original e esbarram na capacidade do acelerador.
É exatamente nessa encruzilhada que o trabalho discutido abaixo tenta intervir.
O que os autores propõem
O artigo «Minima-KV: Retention-Preserving KV Cache Compression with Mixed-Format Paged Attention» foi submetido ao arXiv em 24 de agosto de 2026 sob o número 2608.23834, categoria cs.AI, 13 páginas e 3 figuras, DOI 10.48550/arXiv.2608.23834. Os autores são Sergii Kozyrev e Davyd Maiboroda, da Minima AI, Inc. Um detalhe curioso: no bloco de link para o PDF na página do preprint, a legenda aponta para o primeiro autor «e mais dois», embora na descrição bibliográfica estejam listados apenas dois. É um detalhe pequeno, mas lembra que vale a pena conferir os metadados dos preprints.
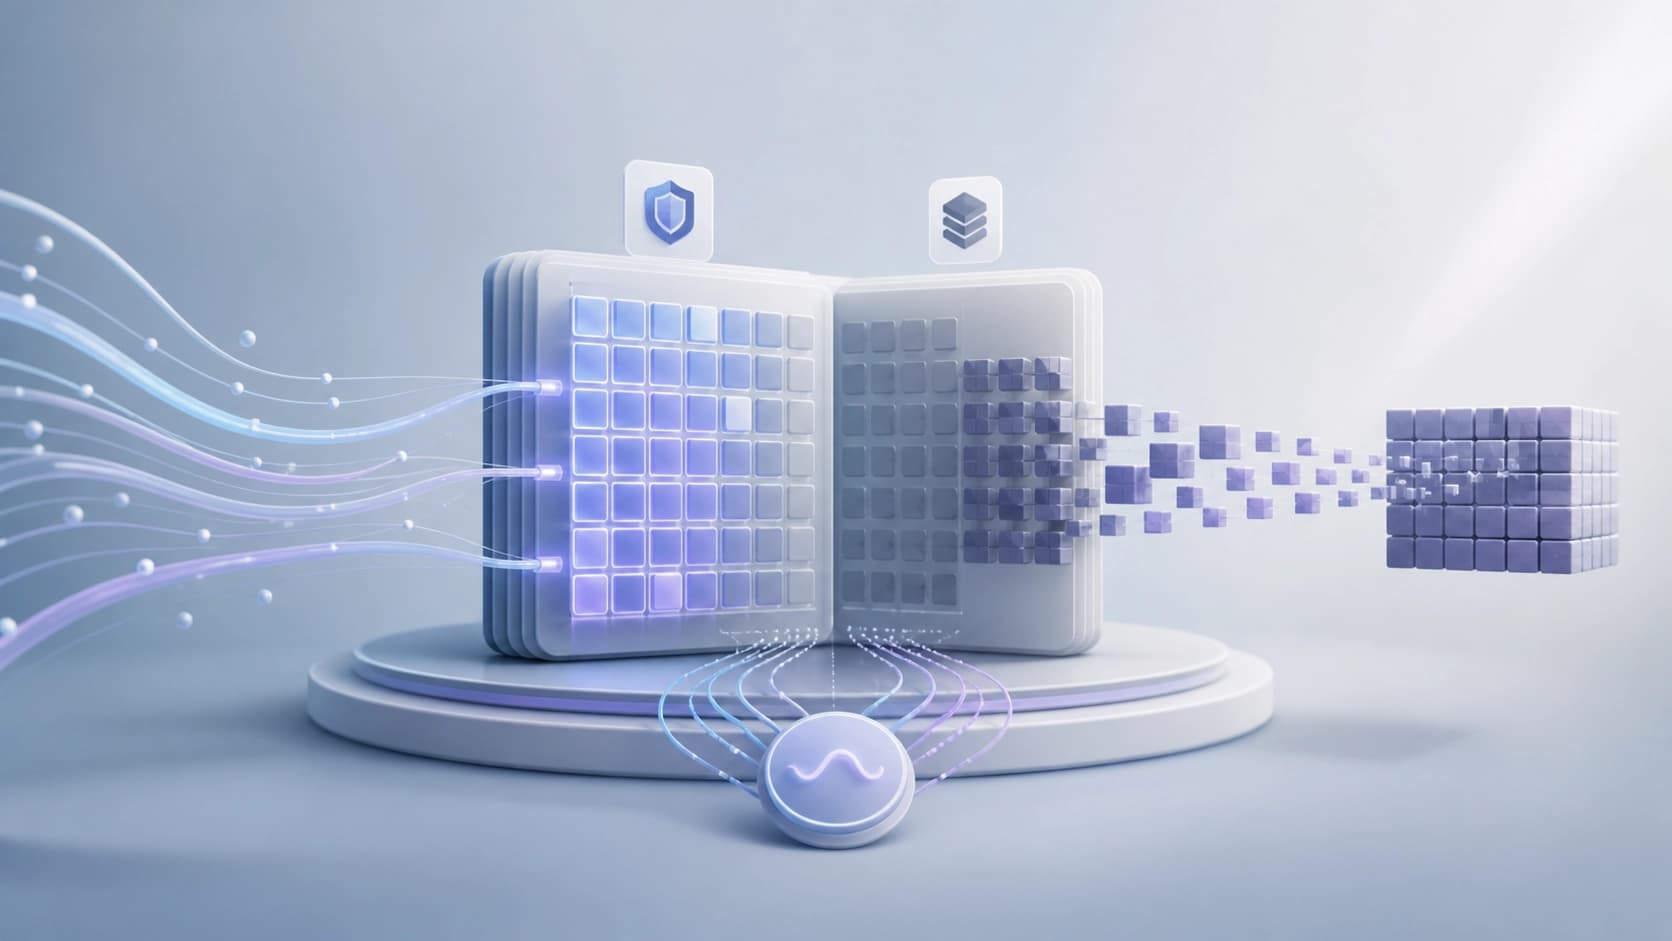
A essência da proposta do Minima-KV é uma hierarquia de páginas do KV-cache, em que páginas diferentes são armazenadas em formatos numéricos diferentes. A palavra-chave no título é retention-preserving, ou seja, «que preserva a retenção»: o estado das requisições recentes não é despejado em lugar nenhum.
Âncoras em FP8, arquivo em TQ3
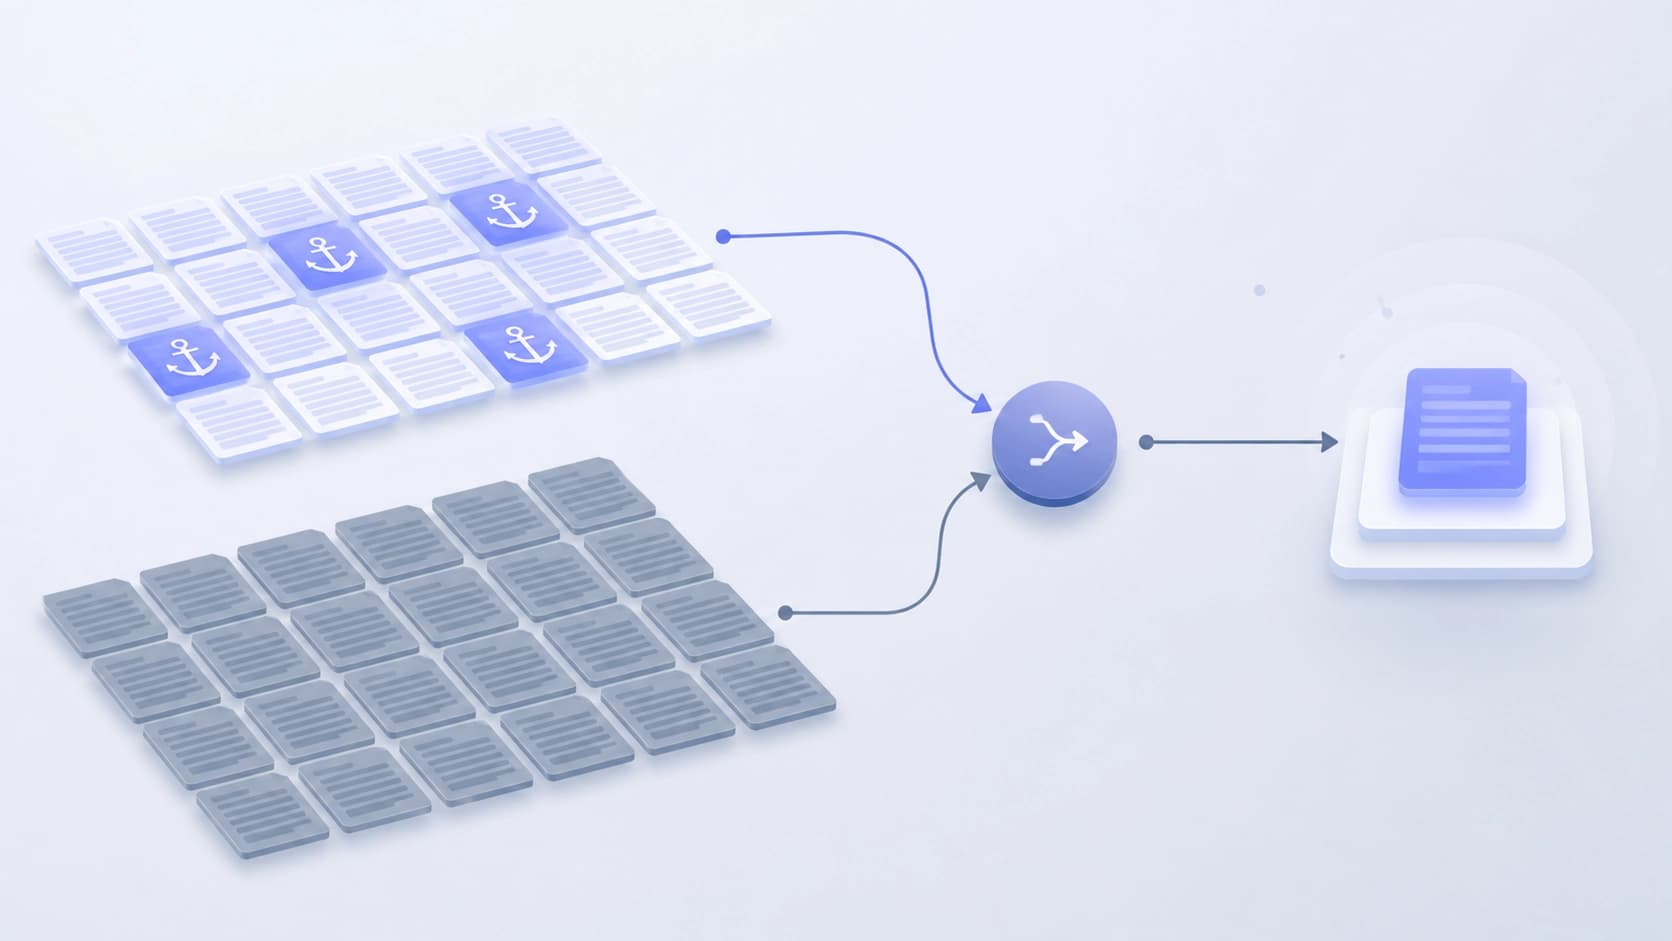
A lógica da divisão é simples. As páginas usadas recentemente e marcadas como protegidas (anchor) permanecem em FP8. As páginas mais antigas, que não entraram nas âncoras, são convertidas para packed TQ3 — um formato empacotado mais denso. Ao mesmo tempo, cada página de uma requisição viva continua podendo ser endereçada diretamente: nada é descartado do espaço de endereçamento nem substituído por uma cópia aproximada.
Como os resultados parciais são combinados
O mais interessante é a aritmética. Kernels separados para cada formato calculam seus estados parciais de atenção, e depois são combinados por meio de um online-softmax merge globalmente normalizado. Em palavras simples: em vez de trazer todas as páginas para um único tipo antes do cálculo, o sistema calcula a contribuição de cada grupo em seu próprio formato e soma corretamente os resultados normalizados.
Graças a isso, a decodificação ocorre diretamente sobre o cache heterogêneo, sem a chamada sombra densa — uma cópia completa do cache em um formato único, que anularia toda a economia de memória.
O que as medições mostram
Memória e compressão
As medições foram feitas em perfis vinculados a uma configuração específica do modelo Qwen3.6-27B em um único acelerador NVIDIA RTX PRO 6000 Blackwell com 96 GB de memória. O resultado foi 18,3 KiB de KV de atenção por token vivo. Isso representa 3,50x de compressão em relação ao BF16 e 1,75x em relação ao FP8.
O segundo número é mais importante do que parece à primeira vista. A comparação com o FP8 mostra que o ganho é obtido não apenas pela transição da meia precisão para formatos mais econômicos, mas justamente pelo esquema híbrido de armazenamento.
Qualidade em contexto longo
O perfil materializante — aquele em que as páginas híbridas realmente são expandidas em tensores — coincidiu com seu controle denso nas tarefas RULER needle-in-a-haystack em 16K. Ou seja, na busca da agulha no palheiro não foi detectada diferença.
A partir daí começam os compromissos. No conjunto LongBench v2, de 503 perguntas, os deltas foram negativos: -0,80 ponto percentual em 16K, -0,60 em 32K e -0,40 em 64K. Note a forma da curva — as perdas não crescem linearmente com o comprimento do contexto, mas oscilam levemente. Os autores não apresentam explicação, mas o fato em si vale ser levado em conta na interpretação: uma variação de frações de porcento é facilmente confundida com ruído de medição.
Verificação canário
Um teste separado — single-pair canary, no qual foram comparadas duas decodificações diretas com requisições de 59 008 tokens cada. Resultados: o KV ativo comprimiu 3,625 vezes, a taxa de transferência ficou em 0,9821x em relação ao controle, todas as 16 camadas de atenção completa foram roteadas sem fallback para o modo denso, e nenhuma sombra densa foi armazenada.
A taxa de transferência um pouco abaixo de um é, na prática, uma troca honesta: cerca de dois porcento de velocidade por uma redução múltipla da memória ocupada.
Conclusões e ressalvas
A conclusão declarada pelos autores é cautelosa: os resultados mostram um caminho prático para a compressão do estado de contexto longo em formatos mistos sem despejo das páginas de requisições vivas. É exatamente o que faltava às abordagens anteriores — uma compressão que não sacrifica dados recentes em favor dos antigos.
O que vale considerar ao ler:
- Os perfis de teste estão vinculados à configuração. Trata-se de um modelo específico e de um acelerador específico; a transferibilidade dos números para outras arquiteturas não é demonstrada.
- A verificação canário é estreita. Um par de requisições, um cenário de decodificação direta — é uma ilustração de funcionamento, não uma estatística de carga.
- A queda no LongBench v2 não é nula. Frações de ponto percentual — pouco, mas em tarefas em que cada unidade de precisão importa, já é motivo para uma medição própria.
- Não há dados sobre latência em condições de produção. A taxa de transferência no teste canário, pela descrição, passa inteiramente pelas 16 camadas sem caminho reserve — é interessante ver como o roteamento se comportará no pior cenário, quando as páginas âncora se tornam mais numerosas que o habitual.
O valor prático do trabalho não está em números recordes de compressão, mas em outra coisa: ele mostra que um cache heterogêneo pode ser atendido diretamente, sem montar sua cópia completa a cada passo. Se essa abordagem for transferível para outros modelos, os cenários de contexto longo ganham mais uma alavanca além da escala de hardware.


