
Escolher um encoder pela métrica errada
Um encoder congelado costuma entrar num projeto olhando para uma única coisa: quão bem uma cabeça leve aprende sobre suas representações — uma camada linear, uma MLP pequena, algo nesse sentido. Se uma cabeça simples extrai a característica desejada, o encoder é considerado bom. Mas essa avaliação responde à pergunta "é conveniente ler algo desses embeddings", e não à pergunta "a própria geometria do espaço separa a característica". São duas perguntas diferentes, e confundi-las custa caro: a cabeça mascara a fraqueza da representação enquanto as tarefas são simples e há poucas classes.
À parte, há o problema do balanceamento. Enquanto as classes são mais ou menos equilibradas, a diferença entre "o encoder consegue" e "a cabeça extrai" quase não aparece. Assim que uma classe se torna rara, as métricas baseadas em vizinhos mais próximos começam a mentir sistematicamente.
Por que a discordança por vizinhos mais próximos mente
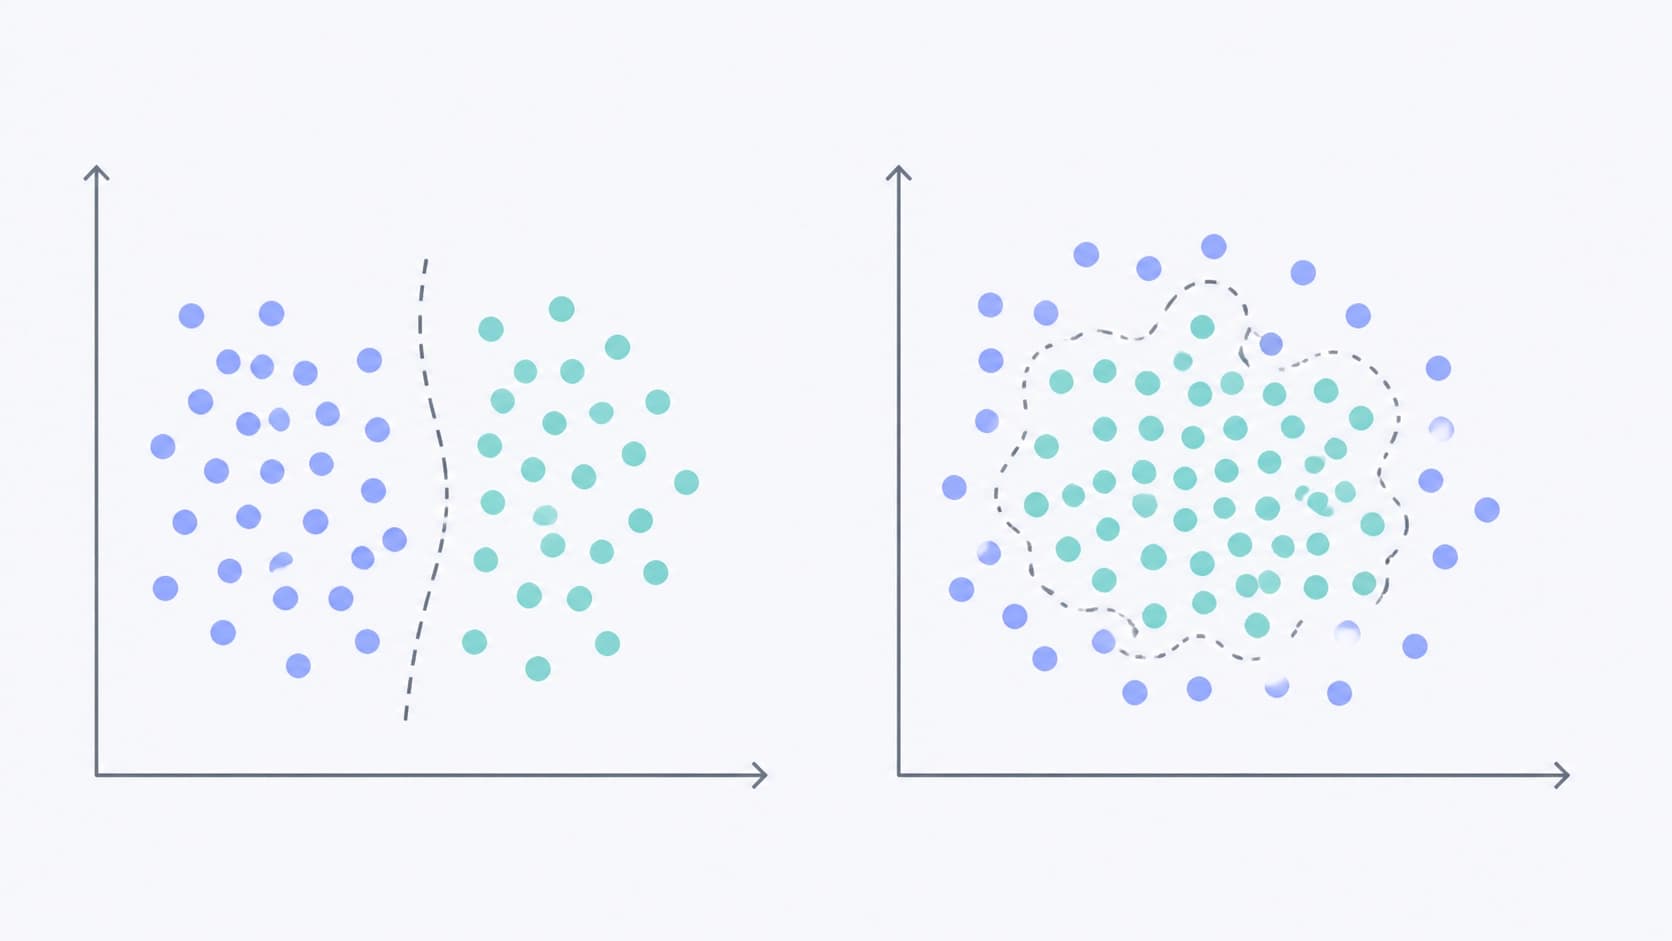
A métrica clássica de discordança é simples: para cada ponto, buscam-se vizinhos no espaço de embeddings, e se o vizinho mais próximo tem o rótulo oposto, o caso é registrado como discordante. Dentro de uma mesma classe, a geometria funciona muito bem, não há queixa quanto aos vizinhos.
O problema está na assimetria do procedimento. Quando os vizinhos para exemplos positivos e negativos são coletados de conjuntos de tamanhos diferentes, o vizinho mais próximo com rótulo oposto vence não porque a geometria é assim, mas porque sua classe simplesmente é mais densa na vizinhança. Em outras palavras, na resultado vaza a prevalência da classe — uma estatística do dataset, não uma propriedade da representação. O efeito é desagradável: um encoder completamente desinformado começa a parecer cego, embora na verdade seja tão inútil quanto uma moeda honesta, e não pior.
O que exatamente o CANDOR muda
O CANDOR — Chance-Calibrated Discordance in Frozen Foundation Encoders — redefine o próprio procedimento de contagem. Os bancos de vizinhos aqui são coletados com tamanho igual, e a construção da métrica é simétrica em relação à permuta dos rótulos: troque positivos e negativos de lugar, e o valor não muda. Como consequência, o nível de acerto ao acaso fica fixado exatamente em um meio — 50%. Não "mais ou menos em torno da metade, depende do dataset", mas um ponto de referência estrito em 1/2.
Não é uma correção cosmética. Era justamente o ponto de referência flutuante que impedia comparar encoders entre si e entre datasets: onde o desbalanceamento é maior, o acerto ao acaso parecia pior do que é, e o modelo recebia um crédito de confiança imerecido. Quando a referência fica fixada, a comparação se torna honesta.
E mais um detalhe, importante para a prática: como o ponto de referência é fixo, o CANDOR pode ser calculado antes do treinamento de qualquer cabeça. Nada de fine-tuning, nada de ajuste de hiperparâmetros — a métrica descreve as próprias representações e antecipa quais achados um determinado encoder congelado sustenta mal.
Verificação em escala
Os autores rodaram a avaliação em larga escala: 22 encoders, 20 datasets de 7 domínios temáticos, num total de 605.443 imagens. Essa amplitude era necessária justamente para separar o efeito da métrica das particularidades de uma única tarefa.
O resultado inverte a conclusão a que o procedimento antigo levava. Após a correção, o colapso das representações fica abaixo do nível de acerto ao acaso em quase todos os casos. Lê-se assim: nenhum dos encoders avaliados é cego — há informação sobre a característica nas representações —, mas todos são fracos. A formulação "todos são fracos, nenhum é cego" soa mais suave do que a anterior e, ao mesmo tempo, descreve a realidade com muito mais precisão.
Exemplo clínico: cabeça forte com geometria fraca
A ilustração mais clara é a imagem médica. O melhor modelo para tórax lê pneumotórax com AUROC 84,5. O número é sólido, e é nele que normalmente se olha ao escolher um modelo. Mas o mesmo modelo coloca 18,4% dos casos positivos mais perto de uma imagem com rótulo oposto do que de sua própria imagem com o mesmo achado — dentro do mesmo hospital, ou seja, sem deslocamento de domínio como explicação.
A lacuna entre "a cabeça resolve bem a tarefa" e "a geometria confunde positivos e negativos" é exatamente essa discrepância. A cabeça compensa uma representação fraca; a métrica CANDOR mostra que há muito a compensar.
Adiante, a comparação entre domínios. Um mesmo encoder distingue espécies de aves no nível de 4,5 (ou seja, quase perfeitamente), mas deixa os achados de tórax em 42,8, e o glaucoma em 49,8. O último número está no nível do acerto ao acaso e, na prática, é pior do que pesos aleatórios. Um encoder, um treinamento, três qualidades de geometria completamente diferentes.
Déficit de seleção, não de informação
Disso segue uma pergunta natural: então as representações são sem esperança? Não exatamente. O acaso limita a margem normalizada (normalized margin) de qualquer cabeça lipschitziana — isto é, de uma cabeça com sensibilidade limitada ao deslocamento da entrada. No entanto, dentro de um conjunto de onze cabeças há uma que acerta em todos os casos, exceto 2,8%, enquanto uma cabeça tomada isoladamente erra em 35,9%. Há informação sobre a característica na representação — ela simplesmente não está igualmente acessível a diferentes dispositivos de leitura. Logo, o déficit está ligado à seleção (selection), e não à ausência de informação.
Uma associação interessante apareceu em outro lugar: a retenção sob apagamento (erasure retention) está ligada ao colapso. Já com o objetivo de treinamento, a escala do modelo, a antiguidade do lançamento ou o tamanho do achado não se encontrou relação. Em termos simples, "pegar um modelo maior e mais recente" não resolve o problema — ele não é sobre tamanho nem sobre idade.
O que disso decorre na prática
Três conclusões práticas.
- Calcule o CANDOR antes de treinar a cabeça. É uma verificação barata que mostra se o encoder sustenta um achado raro específico e permite descartar um backbone inadequado antes de você gastar tempo com tuning.
- Não confunda o AUROC da cabeça com a qualidade da representação. 84,5 com 18,4% de positivos discordantes é uma situação normal, não rara, e vale a pena medi-la separadamente.
- Não espere que escala e novidade corrijam tudo. Não se encontrou associação com tamanho, objetivo de treinamento ou antiguidade; a fraqueza dos encoders congelados parece sistêmica.
O principal valor dessa história não está nem na própria métrica, mas na conclusão invertida. Antes parecia que os encoders eram "cegos" a determinadas classes. Após a calibração por acaso, vê-se outra coisa: eles enxergam quase em toda parte, mas em toda parte enxergam pouco. É um quadro bem menos dramático e bem mais útil — com ele, fica claro o que consertar e em que ordem.


