
Les feux de circulation sont contrôlés par le modèle VLA VLALight : génération d’actions de bout en bout directement à partir des vidéos des caméras routières
Les auteurs proposent VLALight, un modèle de bout en bout de type « vision-langage-action » qui transforme directement les enregistrements multi-vues des caméras d’intersection en changements de signalisation, sans passer par des états du trafic définis manuellement. Il repose sur une perception conjointe tenant compte de la topologie des intersections, un apprentissage par renforcement à l’échelle du réseau urbain et un choix adaptatif entre raisonnement rapide et approfondi. Évaluée sur sept jeux de données réelles dans trois villes, la solution a surpassé les références fondées sur des modèles de trafic, l’apprentissage par renforcement et les LLM/VLM.
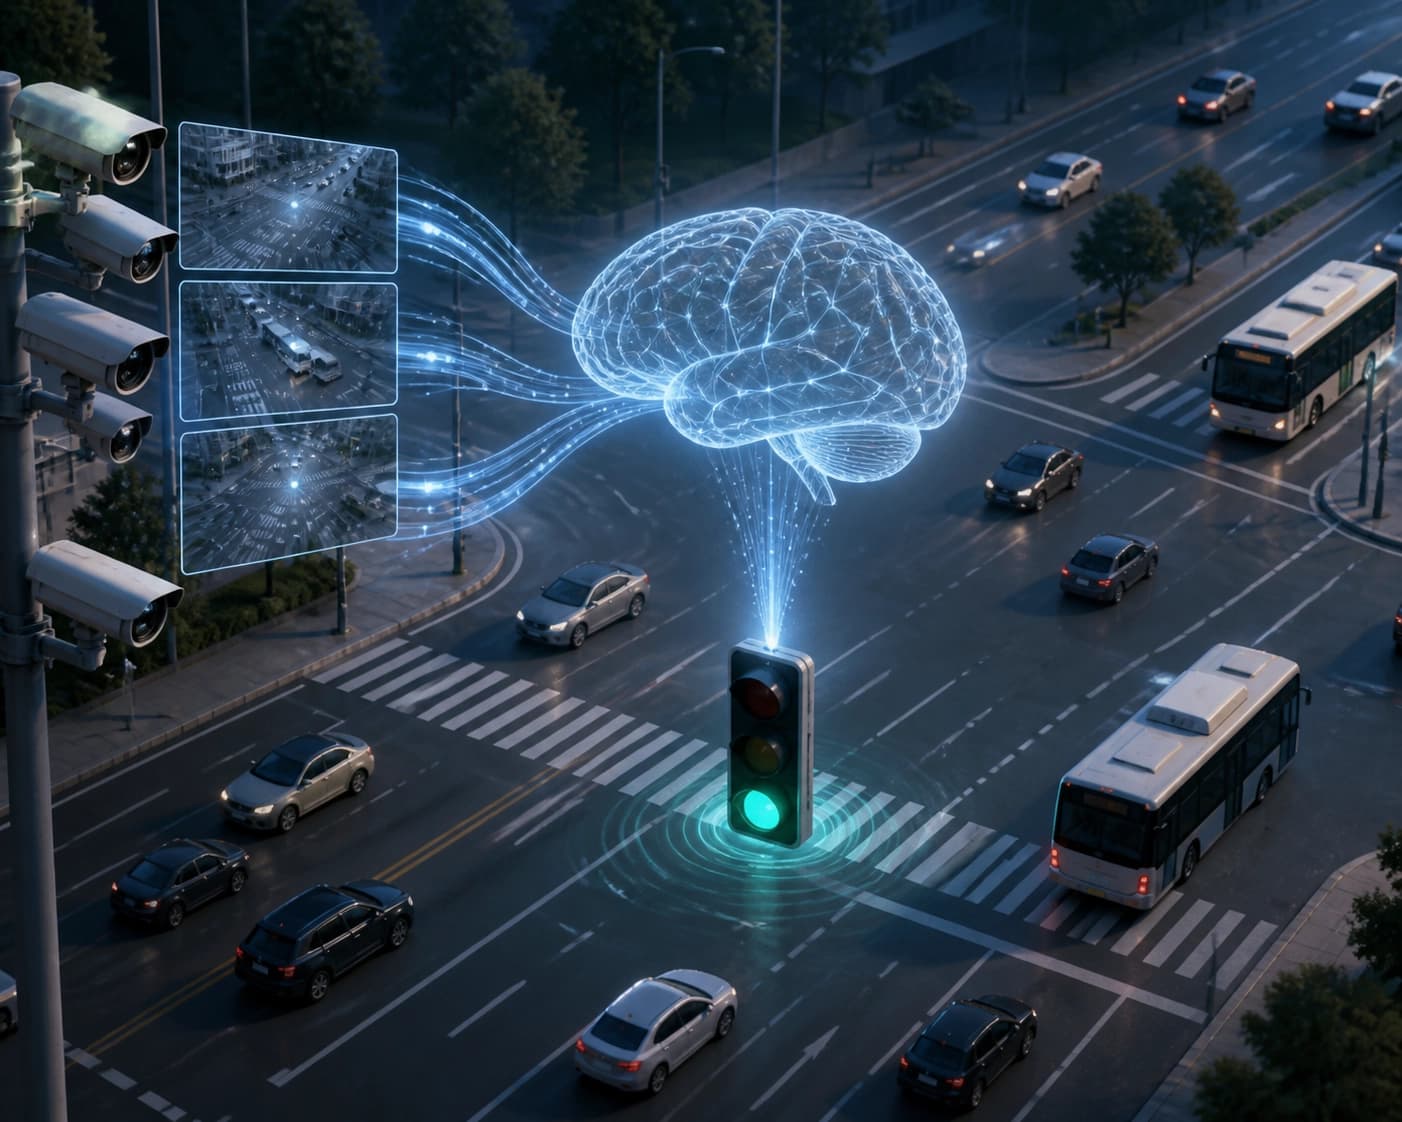
Qu’est-ce qu’un modèle VLA pour le contrôle des feux de circulation
VLALight est un modèle vision-langage-action destiné au contrôle des feux de circulation. Auteurs : Pan Zhang, Siqi Lai, Kemu Dong, Hao Liu. L’article a été soumis le 29 septembre 2026. Il s’agit du premier modèle VLA pour le contrôle de bout en bout des feux de circulation à partir de vidéos multi-vues captées par des caméras en bord de route.
Le modèle transforme directement les observations visuelles en actions coordonnées sur les feux de circulation. Il s’appuie sur un raisonnement spatio-temporel portant sur plusieurs objectifs. Il prend également en compte de manière topologique la perception conjointe aux intersections.
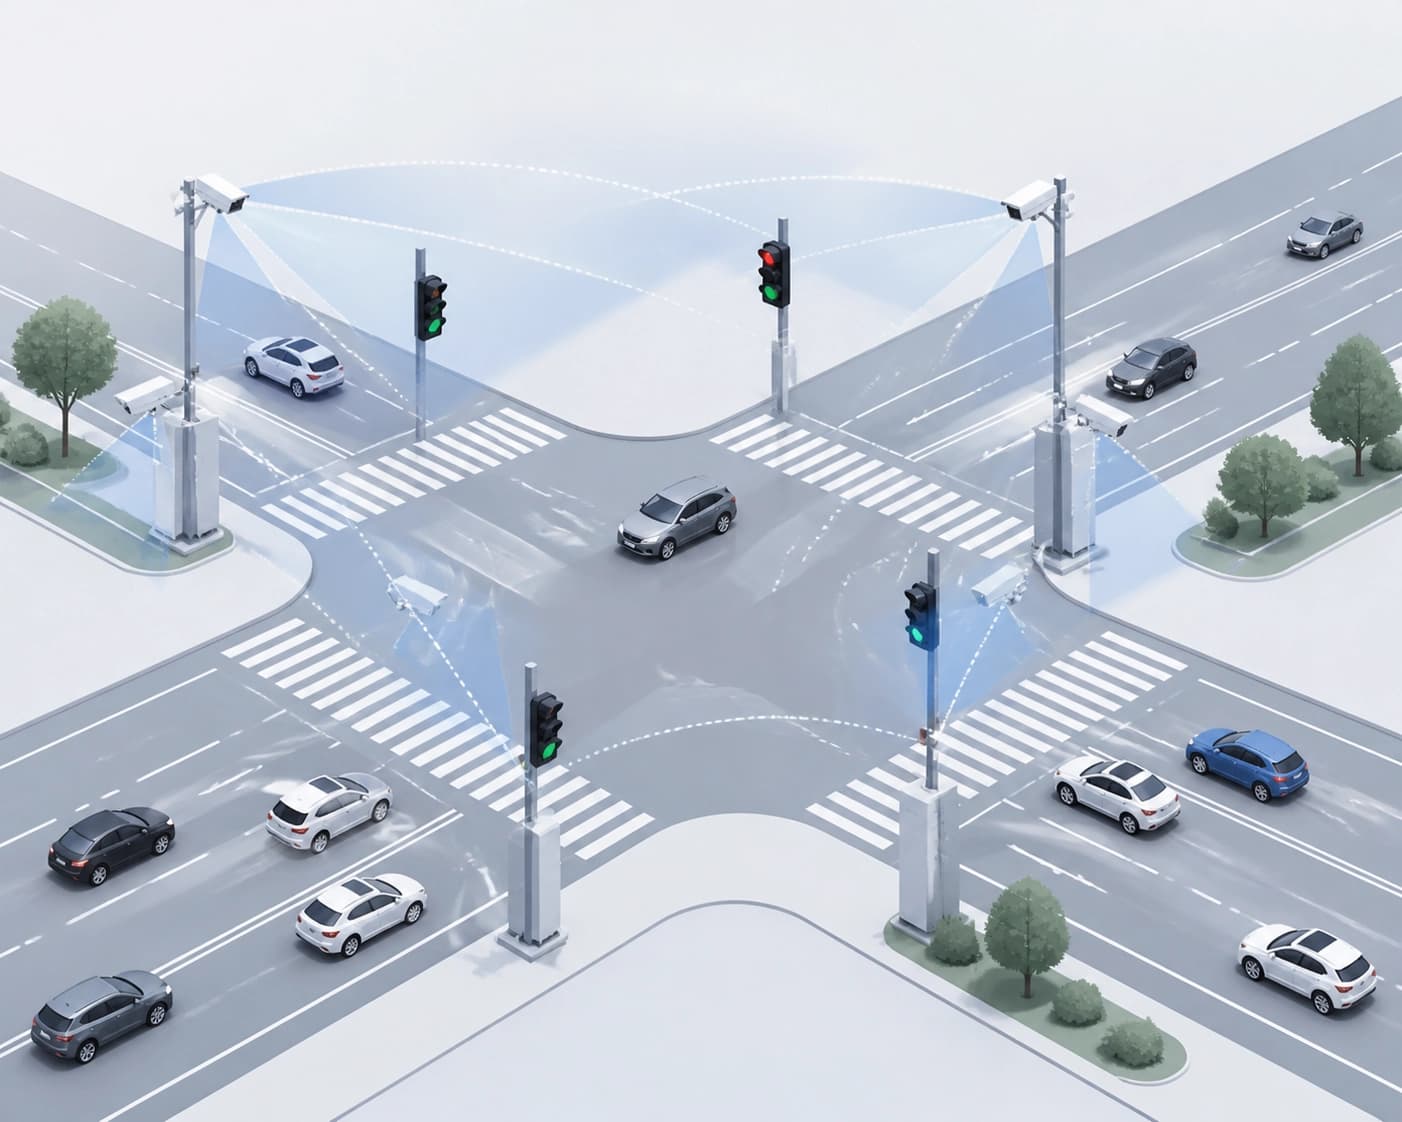
Caractéristiques clés de l’approche :
- Inférence de bout en bout : les observations visuelles sont transformées en actions sur les feux de circulation.
- Vidéos multi-vues : les données proviennent de caméras en bord de route.
- Raisonnement spatio-temporel : le modèle prend en compte plusieurs objectifs.
- Prise en compte topologique : perception conjointe aux intersections.
Critère de sélection : l’approche VLA réunit la perception et le contrôle au sein d’un même modèle. Elle se distingue ainsi des architectures dans lesquelles ces tâches sont séparées. Le lien de bout en bout entre les vidéos et les actions est le critère principal.
Comment VLALight est entraîné : deux étapes
L’entraînement de VLALight repose sur une stratégie en deux étapes. La première consiste en un démarrage à froid supervisé. Elle développe la compréhension visuelle de la situation routière et la prise de décision concernant les signaux. Vient ensuite l’apprentissage par renforcement coopératif agentique.
La deuxième étape optimise conjointement le contrôle local et l’efficacité globale du réseau de transport. La première étape porte sur la compréhension de la scène et des signaux. La deuxième optimise le contrôle local et le réseau.
| Étape | Tâche | Ce qui est optimisé |
|---|---|---|
| Démarrage à froid supervisé | Compréhension visuelle de la situation routière et prise de décision concernant les signaux | Compétences initiales du modèle |
| Apprentissage par renforcement coopératif agentique | Optimisation conjointe | Contrôle local et efficacité du réseau |
Critère de sélection : vérifier si l’approche comporte une optimisation conjointe à l’échelle du réseau. Des décisions locales sans contexte réseau limitent les effets obtenus. Les deux étapes distinguent l’apprentissage de la perception du réglage des interactions.
Modes de raisonnement adaptatifs et coût d’inférence
VLALight utilise des modes adaptatifs de raisonnement rapide et lent. Un raisonnement plus approfondi n’est appliqué que lorsqu’il apporte un bénéfice suffisant pour le contrôle. Le modèle utilise des déroulements équilibrés adaptés au mode et une optimisation relative de l’avantage. Il apprend à trouver un compromis entre la qualité des décisions et le coût d’inférence.
| Mode | Condition d’activation | Effet |
|---|---|---|
| Rapide | Le raisonnement approfondi n’apporte pas de bénéfice suffisant | Coût d’inférence réduit |
| Lent | Le raisonnement approfondi apporte un bénéfice suffisant | Décisions de meilleure qualité |
Critère de sélection : le compromis entre la qualité des décisions et le coût d’inférence. Les modes doivent être activés en fonction de leur bénéfice pour le contrôle. Un fonctionnement constant à la profondeur maximale augmente le coût.
Résultats des expériences
Les expériences ont été menées sur sept jeux de données portant sur des flux de circulation réels. Ils couvrent trois réseaux urbains. VLALight a surpassé les méthodes de référence, notamment les modèles de transport, l’apprentissage par renforcement et les LLM/VLM.
| Classe de méthodes de référence | Rôle dans la comparaison |
|---|---|
| Modèles de transport | Référence |
| Apprentissage par renforcement | Référence |
| LLM/VLM | Référence |
Les études d’ablation ont confirmé l’efficacité de la perception conjointe, de l’optimisation à l’échelle du réseau et du raisonnement adaptatif. Les auteurs soulignent le potentiel des modèles VLA pour le contrôle de systèmes de transport physiques réels.
Critère de sélection : vérifier la composition des méthodes de référence et la présence d’études d’ablation. Les expériences portent sur des flux réels et trois réseaux urbains. La contribution de chaque composant doit être confirmée séparément.
Foire aux questions
Matériaux connexes
Tous matériaux
Évaluation des agents de programmation pour le développement XR interactif : résultats de GenXR-Bench
GenXR-Bench est publié : un ensemble de 112 tâches expertes pour évaluer de bout en bout les agents de programmation dans le développement XR interactif, de l’amélioration de fonctionnalités et de la correction de défauts à la création d’applications dont le comportement est testé sur du matériel grand public. Parmi les dix modèles testés, le meilleur résultat a été de 50,9 % en Pass@1 ; les défaillances récurrentes concernent notamment la gestion des événements asynchrones des capteurs, l’ancrage des objets dans l’espace réel et la compréhension des interactions dans un contexte physique.
5 novembre 2026
Annotation hybride des images : l’automatisation accélère l’entraînement des modèles de vision par ordinateur
L’article décrit comment le pré-étiquetage par des algorithmes réduit le travail manuel et améliore la qualité des jeux de données d’entraînement, ainsi que les raisons pour lesquelles une vérification humaine par échantillonnage reste nécessaire. Il examine les limites de cette méthode dans des conditions de prise de vue difficiles et pour les types d’objets rarement rencontrés.
5 novembre 2026
De la récompense scalaire au front de Pareto : synthèse RTL par LLM avec apprentissage par renforcement multicritère
Une méthode est proposée pour entraîner un modèle de langage à générer non pas un seul schéma, mais un ensemble de candidats RTL offrant différents compromis entre surface, latence et consommation d’énergie ; la récompense est calculée en fonction de la contribution de chaque variante à l’hypervolume du front de Pareto. Sur RTLLM v2, l’hypervolume relatif a augmenté de 13,3 points de pourcentage par rapport à la version de base sans optimisation PPA et de 14,4 points de pourcentage par rapport à l’apprentissage par renforcement mono-objectif.
5 novembre 2026