
De la récompense scalaire au front de Pareto : synthèse RTL par LLM avec apprentissage par renforcement multicritère
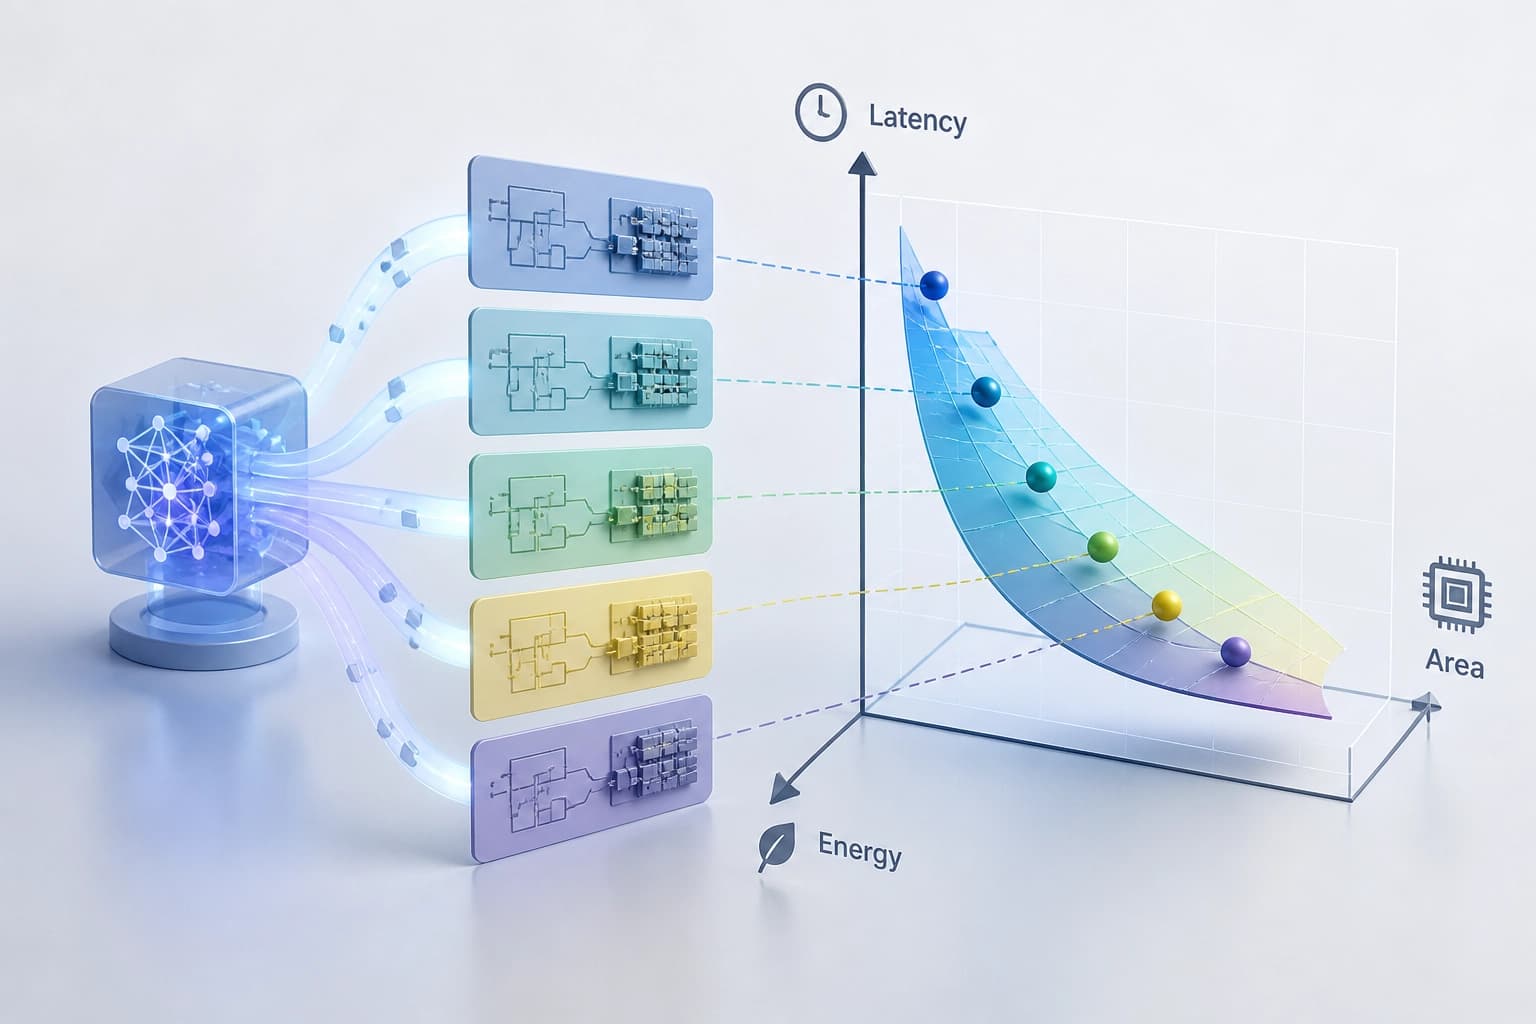
Une méthode est proposée pour entraîner un modèle de langage à générer non pas un seul schéma, mais un ensemble de candidats RTL offrant différents compromis entre surface, latence et consommation d’énergie ; la récompense est calculée en fonction de la contribution de chaque variante à l’hypervolume du front de Pareto. Sur RTLLM v2, l’hypervolume relatif a augmenté de 13,3 points de pourcentage par rapport à la version de base sans optimisation PPA et de 14,4 points de pourcentage par rapport à l’apprentissage par renforcement mono-objectif.
Travail et statut
- Titre : Pareto-Optimal RTL Code Generation via Multi-Objective Reinforcement Learning with Large Language Models.
- Auteurs : Koki Takeshita, Kenji Uebayashi, Hikaru Tomonari, Masaya Tsunokake, Koichiro Yawata, Tatsuya Sasaki, Yusuke Ohtsubo, Kota Dohi, Yasuhiro Sogawa.
- Date de soumission : 16 octobre 2026.
- Statut : les commentaires indiquent que l’article a été accepté à COLM 2026.
Le prépublication est disponible sous la référence arXiv:2610.26904. L’article porte sur la génération de RTL à l’aide de grands modèles de langage. La méthode entraîne le modèle à produire non pas un seul circuit, mais un ensemble de candidats. Cet ensemble est évalué dans l’espace PPA.
Conclusion : l’article a été accepté à COLM 2026 et propose une approche multiobjectif de la synthèse RTL par LLM. Pour choisir une approche, il est important de noter que l’objectif passe d’un seul circuit à un ensemble.
Problème de la récompense scalaire
Les approches existantes regroupent plusieurs objectifs en une seule récompense scalaire. Il devient alors difficile d’obtenir à la fois des solutions diversifiées et optimales au sens de Pareto. Les différents compromis entre faible consommation d’énergie, faible latence et petite surface deviennent difficiles à atteindre. La récompense scalaire fixe l’importance des objectifs avant la génération.
L’importance relative des objectifs dépend des exigences du produit et des contraintes du projet. Une récompense définie à l’avance ne s’adapte pas à ces exigences. Il faut donc un ensemble de candidats présentant différents compromis.
| Approche | Ce qui est optimisé | Moment du choix du compromis |
|---|---|---|
| Récompense scalaire | Un seul circuit selon la somme des objectifs | Avant la génération |
| Approche multiobjectif | Un ensemble de circuits sur le front de Pareto | Après la génération |
Conclusion : la récompense scalaire fixe le compromis avant la génération. La formulation multiobjectif reporte le choix à l’étape qui suit la génération.
Ce que la méthode optimise
La méthode optimise la qualité et la diversité de l’ensemble complet de circuits. Cet ensemble est produit au moyen de plusieurs générations. L’évaluation se fait dans l’espace des objectifs PPA : Power, Performance, Area. La méthode ne vise pas la qualité d’un seul circuit.
Les objectifs PPA sont liés par des compromis. Différents circuits offrent différentes combinaisons de faible consommation d’énergie, de faible latence et de petite surface. La méthode entraîne donc le modèle à couvrir différents points du front de Pareto. Le concepteur dispose ainsi de plusieurs candidats.
Conclusion : la méthode vise à couvrir le front, et non à trouver une seule meilleure réponse.
Deux éléments de la méthode
Pipeline d’entraînement fondé sur les générations
Le pipeline transforme l’amélioration de la couverture de l’ensemble des solutions de Pareto en une tâche séquentielle de génération de circuits. L’entraînement se déroule par étapes. La tâche de génération adopte une structure séquentielle.
Récompense fondée sur la contribution à l’hypervolume
La fonction de récompense HVC mesure la contribution du circuit généré au front de Pareto. La récompense reflète non pas la qualité absolue d’un circuit pris isolément, mais l’augmentation de la couverture. HVC relie l’entraînement à la couverture du front.
Conclusion : le pipeline définit une séquence, tandis que HVC fournit un signal récompensant la contribution à la couverture.
Résultats sur RTLLM v2
L’évaluation sur le benchmark RTLLM v2 a montré une augmentation de l’hypervolume relatif. Par rapport à la variante de base sans optimisation PPA, l’augmentation était de +13,3 points de pourcentage. Par rapport à la méthode RL monoobjectif, elle était de +14,4 points de pourcentage. Les auteurs font également état d’une plus grande diversité des circuits.
| Comparaison | Augmentation de l’hypervolume relatif |
|---|---|
| Variante de base sans optimisation PPA | +13,3 points de pourcentage |
| Méthode RL monoobjectif | +14,4 points de pourcentage |
Conclusion : sur RTLLM v2, la méthode améliore la couverture du front et la diversité. Les chiffres concernent l’hypervolume relatif, et non la qualité absolue de chaque circuit.
Critère pratique de choix
Le choix de l’approche dépend du moment où le compromis est fixé. Une récompense scalaire exige de définir l’importance du PPA avant la génération. L’approche multiobjectif reporte le choix à l’étape qui suit la génération. Elle fournit un ensemble de candidats présentant différents compromis.
L’évaluation de la méthode se limite au benchmark RTLLM v2. Un flux de conception différent nécessite une validation spécifique. Il ne faut pas transposer les chiffres d’augmentation à d’autres conditions sans vérification.
Conclusion : si les exigences PPA varient d’un produit à l’autre et d’un projet à l’autre, l’approche multiobjectif convient à une sélection effectuée après la génération. Si l’importance des objectifs est connue et fixée, la récompense scalaire convient au cas où le compromis est défini à l’avance.
Foire aux questions
Matériaux connexes
Tous matériaux
Évaluation des agents de programmation pour le développement XR interactif : résultats de GenXR-Bench
GenXR-Bench est publié : un ensemble de 112 tâches expertes pour évaluer de bout en bout les agents de programmation dans le développement XR interactif, de l’amélioration de fonctionnalités et de la correction de défauts à la création d’applications dont le comportement est testé sur du matériel grand public. Parmi les dix modèles testés, le meilleur résultat a été de 50,9 % en Pass@1 ; les défaillances récurrentes concernent notamment la gestion des événements asynchrones des capteurs, l’ancrage des objets dans l’espace réel et la compréhension des interactions dans un contexte physique.
5 novembre 2026
Les LLM médicales sont informés des révisions des recommandations, mais répondent souvent selon les anciennes règles
L’étude de ChronoEvo portant sur 1 709 changements dans les recommandations cliniques montre que, dans le modèle principal, 90,8 % des réponses repéraient la nouveauté, mais que seules 58,5 % l’appliquaient intégralement, avec un écart de 32,3 points de pourcentage observé dans 14 modèles. Même en renforçant la visibilité des mises à jour, le transfert intégral des nouvelles règles dans les recommandations cliniques n’a pas connu de hausse significative.
4 novembre 2026
Modèle du monde pour les agents basés sur des LLM fermés : correction aux points de risque
PAWM est proposé comme un prédicteur externe qui ne reproduit pas l’observation étape par étape, mais s’active en cas d’échec probable et détourne l’agent d’une action erronée. Après un SFT sur des scénarios synthétiques et un co-entraînement GRPO, la méthode a enregistré des gains de 24,3 % sur ScienceWorld et de 7,7 % sur WebArena-Lite pour Claude Sonnet 4.5.
4 novembre 2026