
Annotation hybride des images : l’automatisation accélère l’entraînement des modèles de vision par ordinateur
L’article décrit comment le pré-étiquetage par des algorithmes réduit le travail manuel et améliore la qualité des jeux de données d’entraînement, ainsi que les raisons pour lesquelles une vérification humaine par échantillonnage reste nécessaire. Il examine les limites de cette méthode dans des conditions de prise de vue difficiles et pour les types d’objets rarement rencontrés.
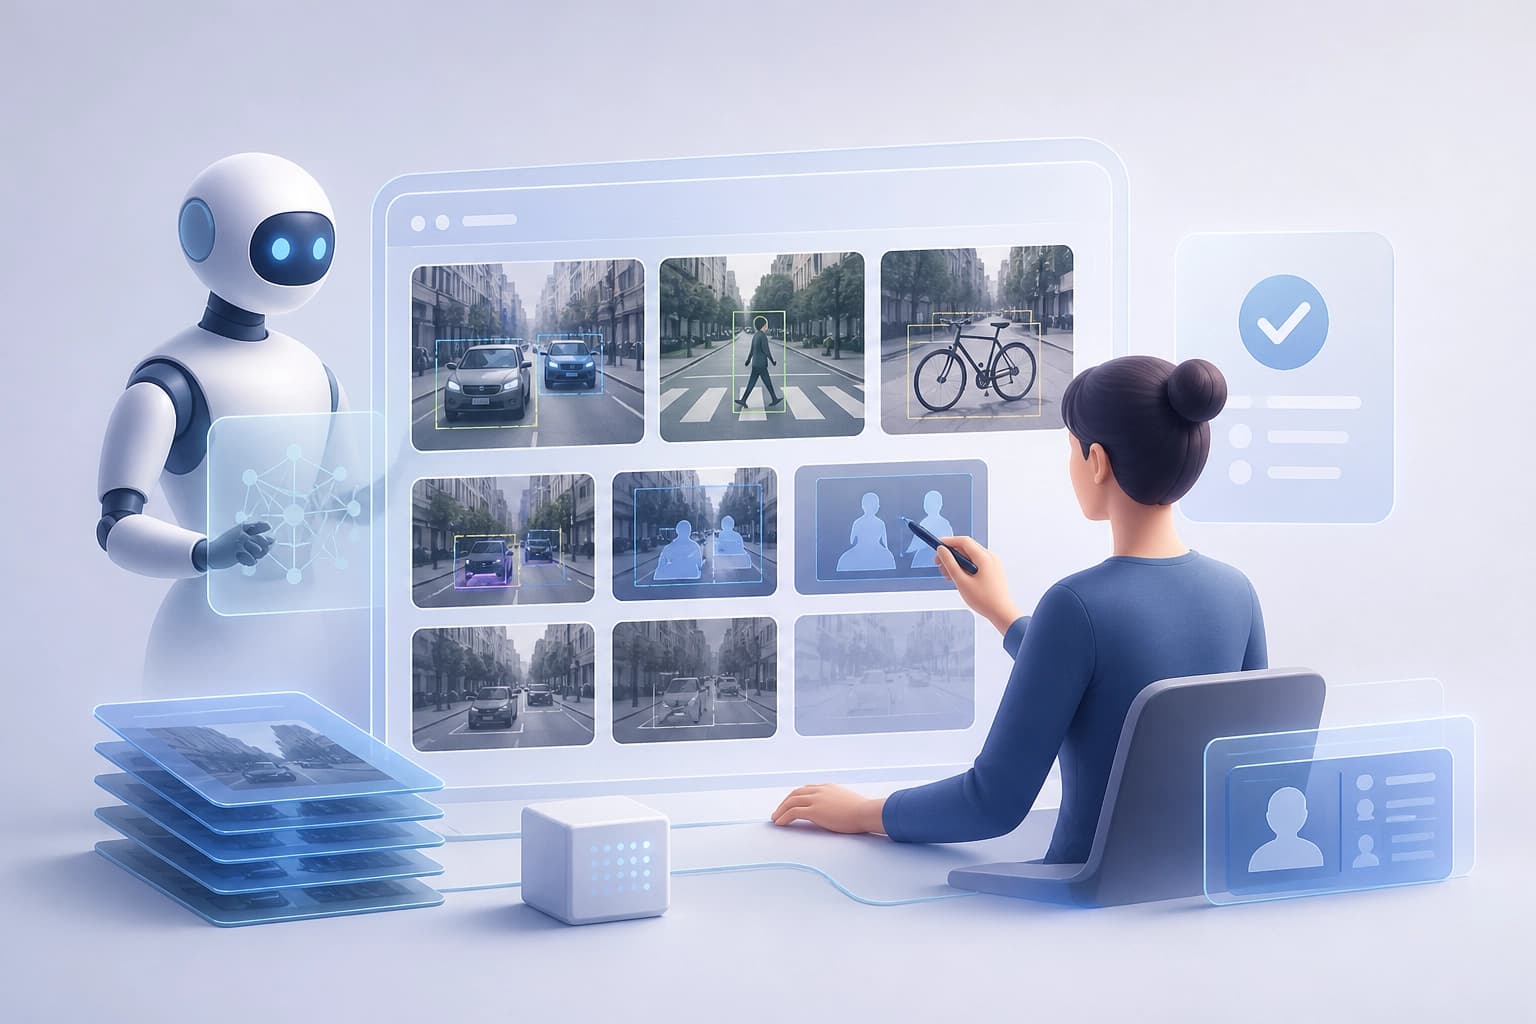
Pourquoi l’annotation manuelle limite l’entraînement de la vision par ordinateur
La vision par ordinateur s’entraîne à partir d’images annotées. L’annotation est longtemps restée la partie la plus lente du développement de ces systèmes. Les modèles d’IA modernes ont besoin de millions d’images annotées pour bien fonctionner.
Le travail manuel ne suit pas le rythme de ce volume. L’annotation devient donc un goulot d’étranglement lors de l’entraînement des modèles. L’annotation manuelle ne peut pas évoluer à l’échelle requise par les modèles modernes.
Comment fonctionne l’annotation hybride
Les outils automatisés utilisent des modèles préentraînés. Ils annotent de nouvelles images sans traitement manuel de chaque pixel. Une personne vérifie et corrige le résultat au lieu de commencer l’annotation de zéro.
Étapes de l’annotation hybride :
- Préannotation automatique à l’aide d’un modèle préentraîné.
- Vérification et correction du résultat par une personne.
L’approche hybride allie la rapidité de l’automatisation au contrôle de la qualité.
Quelles tâches l’automatisation de l’annotation permet-elle de réaliser
L’automatisation prend en charge plusieurs types d’annotation. Liste des tâches :
- détection d’objets et placement de boîtes englobantes ;
- segmentation sémantique ;
- segmentation d’instance ;
- classification d’images ;
- estimation des points clés et des poses ;
- annotation d’images vidéo.
L’automatisation couvre les principales tâches de vision par ordinateur.
Quels sont les avantages de l’approche hybride par rapport à l’annotation manuelle
| Critère | Manuelle uniquement | Approche hybride |
|---|---|---|
| Temps d’annotation | Référence de comparaison | Peut réduire le temps de près de 40 % |
| Taux d’erreur | Peut être jusqu’à 25 % plus élevé qu’avec l’approche hybride | Taux d’erreur plus faible |
| Mise à l’échelle du jeu de données | Nécessite d’augmenter proportionnellement le nombre d’annotateurs | Permet d’agrandir les jeux de données sans augmenter proportionnellement le nombre d’annotateurs |
L’approche hybride est plus rapide, plus précise et plus facile à mettre à l’échelle.
Où l’annotation automatique est-elle utilisée
L’annotation automatique est utilisée dans :
- les véhicules autonomes ;
- l’imagerie médicale ;
- le commerce de détail et le commerce électronique ;
- l’agriculture et l’industrie manufacturière.
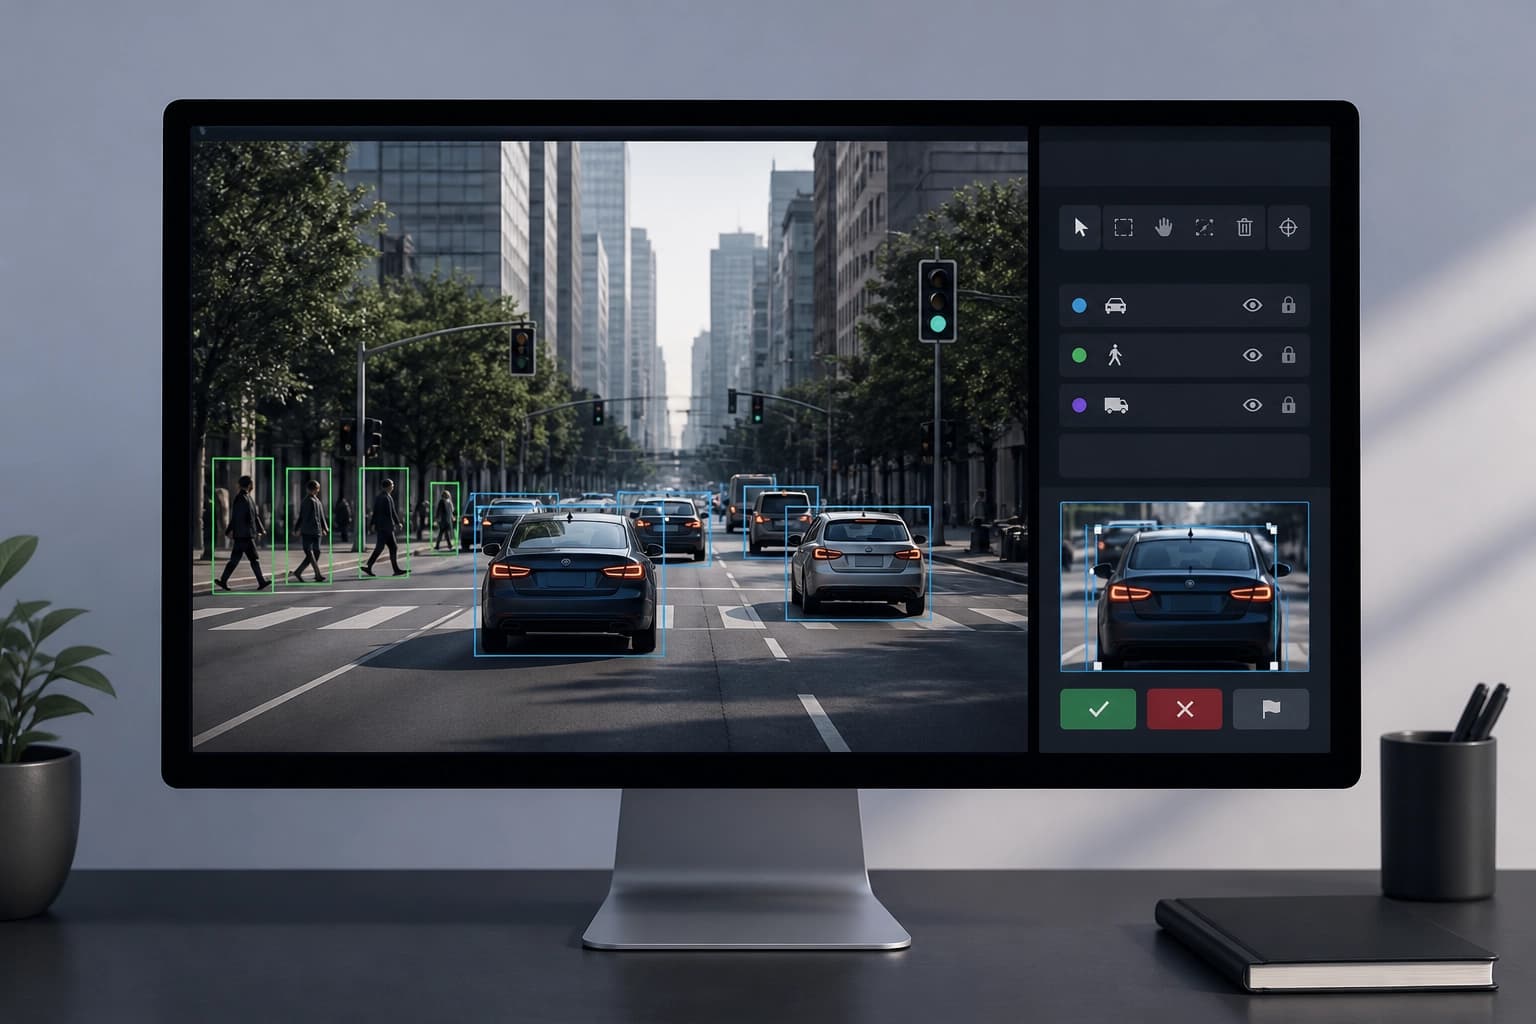
Dans les secteurs où les enjeux sont importants, la qualité de l’annotation revêt une importance particulière. Les erreurs dans les données relatives aux piétons présentent un risque pour la sécurité des véhicules autonomes. Une annotation incohérente des contours des tumeurs peut conduire un modèle médical à manquer un diagnostic.
Limites de l’annotation automatique
Les systèmes automatisés peuvent encore se tromper en cas d’éclairage inhabituel, d’occlusion d’objets, de classes d’objets rares et dans des situations atypiques. Les biais des données d’entraînement peuvent se retrouver dans l’annotation automatique.
L’automatisation est donc considérée comme une étape initiale. La vérification humaine est maintenue, en particulier dans le secteur de la santé. L’approche hybride est indispensable lorsque le coût d’une erreur est élevé.
Critères pratiques pour choisir une approche d’annotation
Critères de choix :
- Un coût élevé en cas d’erreur (sécurité, médecine) exige une vérification humaine.
- L’augmentation du volume de données sans hausse proportionnelle du nombre d’annotateurs est rendue possible par la préannotation automatique.
- Pour les petites entreprises, les services d’annotation dans le cloud et les modèles open source abaissent le seuil d’entrée.
L’approche d’annotation se choisit en fonction du coût d’une erreur et des besoins de mise à l’échelle.
Foire aux questions
Matériaux connexes
Tous matériaux
Quinze entreprises ont soutenu MDK Tether pour automatiser le minage
Les fabricants d’équipements, les pools et les opérateurs ont pris en charge le développement d’intégrations avec l’ensemble ouvert de Tether afin d’unifier la surveillance et la gestion des équipements ; l’agent IA QVAC fonctionne déjà sur cette base. Aucune confirmation indépendante d’une baisse des coûts énergétiques ou d’une hausse de l’efficacité n’a encore été publiée.
2 novembre 2026
Un agent plutôt qu’un optimiseur dédié : un cadre unifié qui évolue simultanément sur plusieurs tâches
Les auteurs montrent qu’un modèle figé, exécuté avec une version inchangée de son environnement, commence par résoudre des tâches, puis modifie lui-même son propre code en s’appuyant sur les journaux complets des exécutions. L’évolution multitâche d’un squelette de 49 lignes a amélioré les résultats sur les tâches de la distribution et sur des benchmarks tenus à l’écart, et a permis de surpasser Codex sur certains d’entre eux.
29 octobre 2026
Dialogues en binôme avec des LLM : l’alignement sur les opinions actuelles radicalise davantage que l’imposition de nouvelles convictions
Les auteurs du préprint arXiv:2609.38296 ont simulé des échanges entre un modèle cible jouant un personnage humain et un agent influenceur qui cherche à faire basculer ses opinions vers un pôle extrême. Les deux scénarios — renforcer une opinion déjà présente et promouvoir une opinion auparavant secondaire — ont entraîné un déplacement des mesures affectives et comportementales, le premier s’avérant plus robuste.
27 octobre 2026