
Le problème : peu de tests, mais toute la récompense repose sur eux
L'apprentissage par renforcement sur récompenses vérifiables (RLVR) est devenu le principal moyen d'amener les modèles de langage à un niveau correct en génération de code. Le schéma est simple : le modèle écrit une solution, une vérification dédiée la fait passer par des tests, et une récompense est attribuée au modèle selon le résultat. Tout repose sur une seule hypothèse — que les tests décrivent réellement la tâche dans son intégralité.
En pratique, cette hypothèse est presque toujours violée. L'ensemble des cas de test est étroit, la couverture est trouée, et le modèle trouve assez vite non pas la tâche, mais une échappatoire : il ajuste le code aux vérifications concrètes au lieu d'apprendre à résoudre une classe de tâches similaires. Ensuite s'enclenche la spirale bien connue — le reward hacking, suivi de la dégradation de la politique. Le modèle perd en compétences générales exactement à la mesure de sa réussite dans une astuce étroite.
Analogie grossière : un examen composé de deux questions. L'étudiant qui a appris les réponses à ces deux questions obtient la note maximale, mais ne connaît pas la matière. Et plus cet apprentissage dure, plus il devient mauvais dans tout le reste.
L'idée de RobustTests : les erreurs comme générateur de tests
Habituellement, on conçoit les tests en partant de l'énoncé de la tâche : quels types d'entrées existent, où se situent les bornes des plages, que se passera-t-il avec une entrée vide. C'est logique, mais c'est précisément ce chemin qui donne une couverture étroite — l'auteur des tests et l'auteur de la solution regardent la tâche du même côté et sont aveugles aux mêmes endroits.
RobustTests renverse le processus. Le framework repose sur la synthèse de cas de test guidée par le code défectueux (faulty-code-driven test case synthesis). Il ne s'agit pas de code cassé aléatoire, mais de solutions « presque correctes » : celles qui diffèrent de la bonne par une petite modification de la logique — un signe de comparaison inversé, une borne de boucle erronée, une branche omise. Chacune de ces solutions fonctionne presque, et c'est précisément pour cela qu'elle est précieuse.
On cherche ensuite une entrée sur laquelle le code presque correct diverge du code de référence. L'entrée trouvée devient le test. Un tel test possède une forte puissance diagnostique : il ne se contente pas de « vérifier quelque chose », il distingue deux comportements proches — celui que nous voulons du modèle, et celui qui paraît plausible mais est erroné.
Le travail est décrit dans le préprint arXiv:2608.24135 (Yiwen Zhang et huit autres auteurs, parmi lesquels Xiaodong Yan, Zhenyu Huang, Deng Zhao et d'autres ; v1 — 25 août 2026, v2 — 27 août 2026, DOI 10.48550/arXiv.2608.24135, accepté à EMNLP 2026). Les auteurs rattachent le matériel à deux sections à la fois — cs.AI et cs.SE, ce qui est logique : cela concerne à la fois l'apprentissage des modèles et l'ingénierie des tests.
Filtrage : agents validateurs et clustering
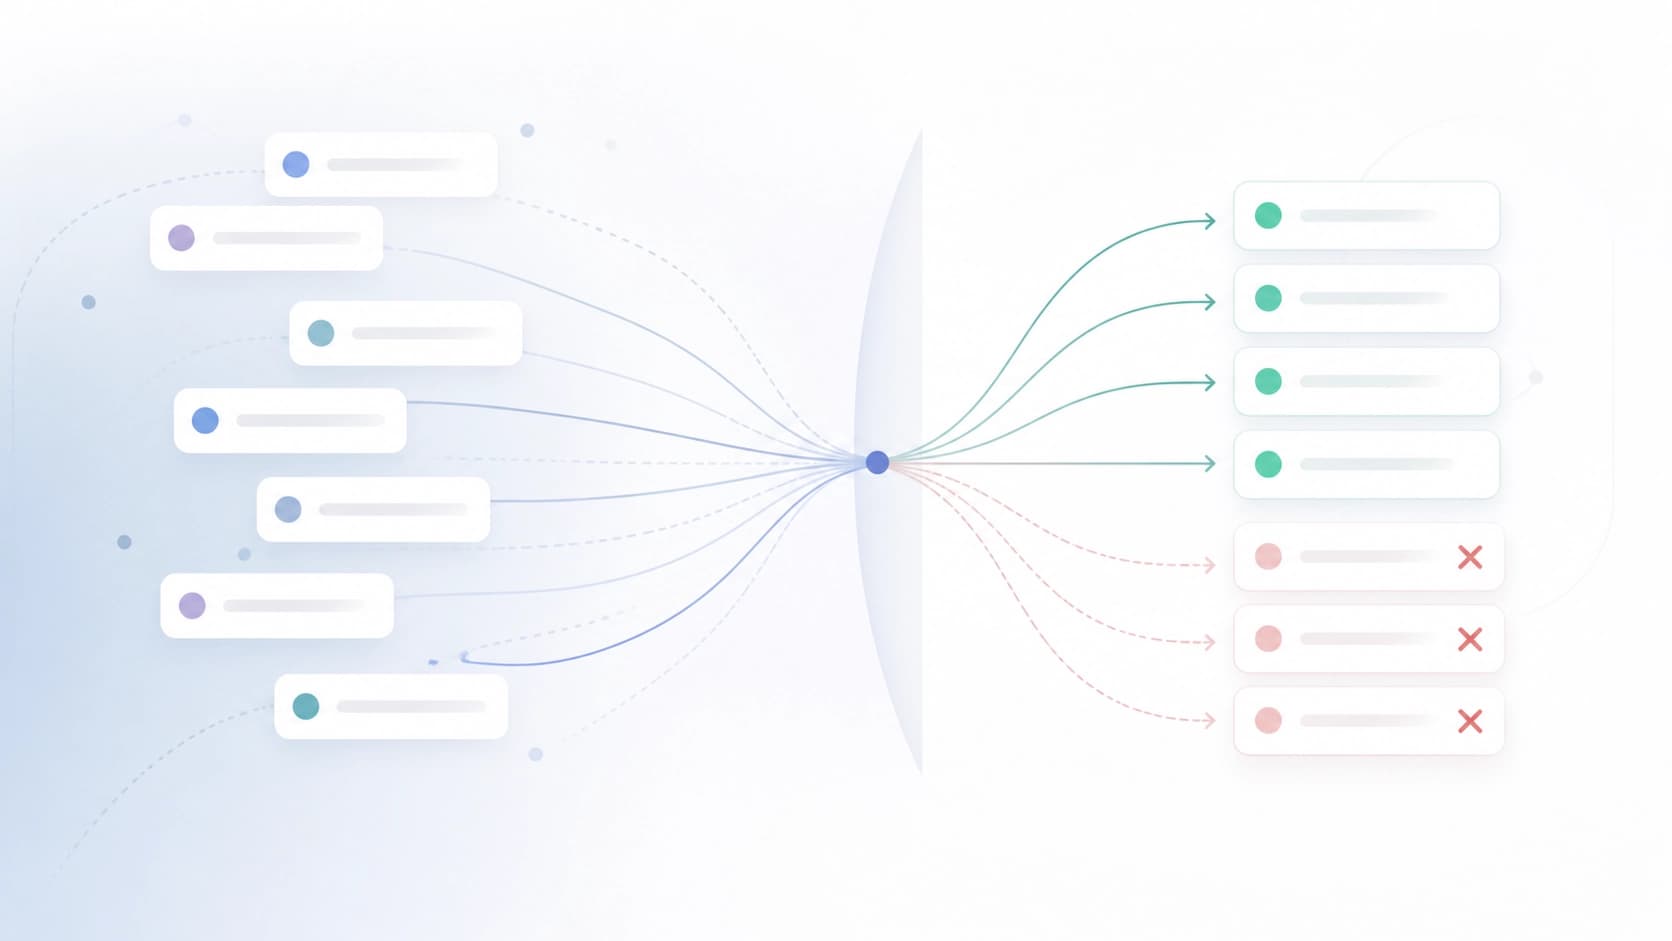
Toute synthèse automatique de tests se transforme facilement en générateur de déchets. Une partie des entrées imaginées s'avérera invalide, une autre se dupliquera, une autre encore vérifiera le même comportement sous des angles différents. Le signal utile d'un tel ensemble est faible, et le bruit abondant.
C'est pourquoi le pipeline prévoit une seconde couche — des agents validateurs qui écartent les cas de test incorrects et superflus. On y ajoute un clustering fondé sur des caractéristiques comportementales : les tests sont regroupés selon le comportement précis du code qu'ils distinguent, et les doublons au sein d'un groupe sont fusionnés. Il reste au final un ensemble compact, où chaque élément apporte une information nouvelle au lieu de répéter son voisin.
Une récompense dense au lieu d'un signal rare
Le second composant du framework ne concerne pas les tests, mais la manière dont la récompense en est calculée. L'approche binaire classique — « tout est passé ou rien n'est passé » — fonctionne mal quand les tests deviennent nombreux et de difficulté variable : le modèle résout presque tout, trébuche sur un seul cas limite et obtient le même zéro qu'une solution entièrement cassée. Le signal d'apprentissage se rompt, et il n'y a presque rien à en tirer.
RobustTests introduit une fonction de récompense dense par étapes (stepwise dense reward), fondée sur la proportion de vérifications réussies — le pass rate. Le modèle reçoit un signal partiel et comprend la direction du mouvement : non pas « échec », mais « il reste deux tests sur trente ». Cela résout deux problèmes d'un coup. Premièrement, cela réduit le nombre de faux négatifs (false negatives), lorsque une solution correcte est rejetée à cause d'un test trop strict ou simplement erroné. Deuxièmement, cela rend l'apprentissage plus stable : la récompense cesse d'être un événement rare et devient une échelle.
Il convient de souligner à part le lien entre ces deux idées. Une récompense dense n'a de sens que lorsque les tests distinguent réellement différents types d'erreurs — sinon vous ne faites que moyenner du bruit. Et la synthèse de tests à partir de solutions presque correctes, sans récompense dense, laissera toujours la même rupture de signal. Les composants fonctionnent en tandem.
Jeu de données et résultats
Sur ce pipeline, les auteurs ont constitué une version étendue du jeu de données CodeContests+ — avec une utilité diagnostique nettement plus élevée : les ensembles de tests indiquent plus précisément à quelle étape précise de la solution le modèle se trompe.
La principale mesure n'est pas la taille du jeu de données, mais le comportement du modèle après l'affinage. L'entraînement RL de Qwen3-32B avec RobustTests donne un gain absolu de 3 % sur LiveCodeBench. Les auteurs ont mis le code et les données en accès libre.
Il convient ici de rester lucide. Trois points de pourcentage sur un seul benchmark lors de l'affinage d'un seul modèle — ce n'est pas un bouleversement dans le domaine, mais une amélioration soignée avec un mécanisme compréhensible. La valeur du travail réside plutôt dans la méthodologie : elle propose une recette reproductible pour extraire plus de signal des tests sans en augmenter le nombre manuellement. Les limites sont tout aussi évidentes — le transfert du résultat à d'autres modèles, langages et types de tâches reste à vérifier.
Ce qu'il vaut la peine d'en retenir dans sa propre pratique
Même si vous ne construisez pas de pipeline RL et que vous évaluez simplement la qualité de la génération de code, la logique se transpose presque sans changement :
- Écrivez des tests à partir des erreurs, pas seulement à partir de l'énoncé. Prenez une solution qui fonctionne presque et trouvez l'entrée où elle casse. Un tel test est presque toujours plus informatif qu'une dizaine conçus « de front ».
- Comptez la proportion de vérifications réussies, pas le fait de réussir. Un score partiel donne un gradient, tant en apprentissage qu'en analyse de qualité — on voit où précisément le modèle échoue.
- Filtrez les tests synthétisés. Sans validation ni déduplication, un ensemble généré automatiquement se transforme vite en dépotoir de vérifications qui se ressemblent.
- Surveillez ce que la récompense encourage réellement. Une échelle dense réduit la tentation des voies de contournement, mais ne l'annule pas : si les tests ne distinguent pas les comportements, toute récompense finira tôt ou tard par être piratée.
L'idée que porte RobustTests est humainement simple : la meilleure source de tests difficiles n'est pas l'imagination de l'auteur, mais les presque-erreurs de la système lui-même. Ce que le modèle a failli faire correctement est l'indicateur le plus honnête de l'endroit où passe la frontière entre « ressemble à une solution » et « solution ».


