
Pourquoi le vote par confiance fonctionnait tout court
L'idée, familière à quiconque a construit des pipelines autour de grands modèles de langage, est simple : lancer une même tâche plusieurs fois en parallèle, puis choisir la réponse à la majorité. Mais pas une majorité « plate » — une majorité pondérée : chaque exécution reçoit un poids selon les signaux internes du modèle, le plus souvent les log-probabilités des tokens. La variante dans laquelle le modèle était le plus confiant pèse plus fort que les autres.
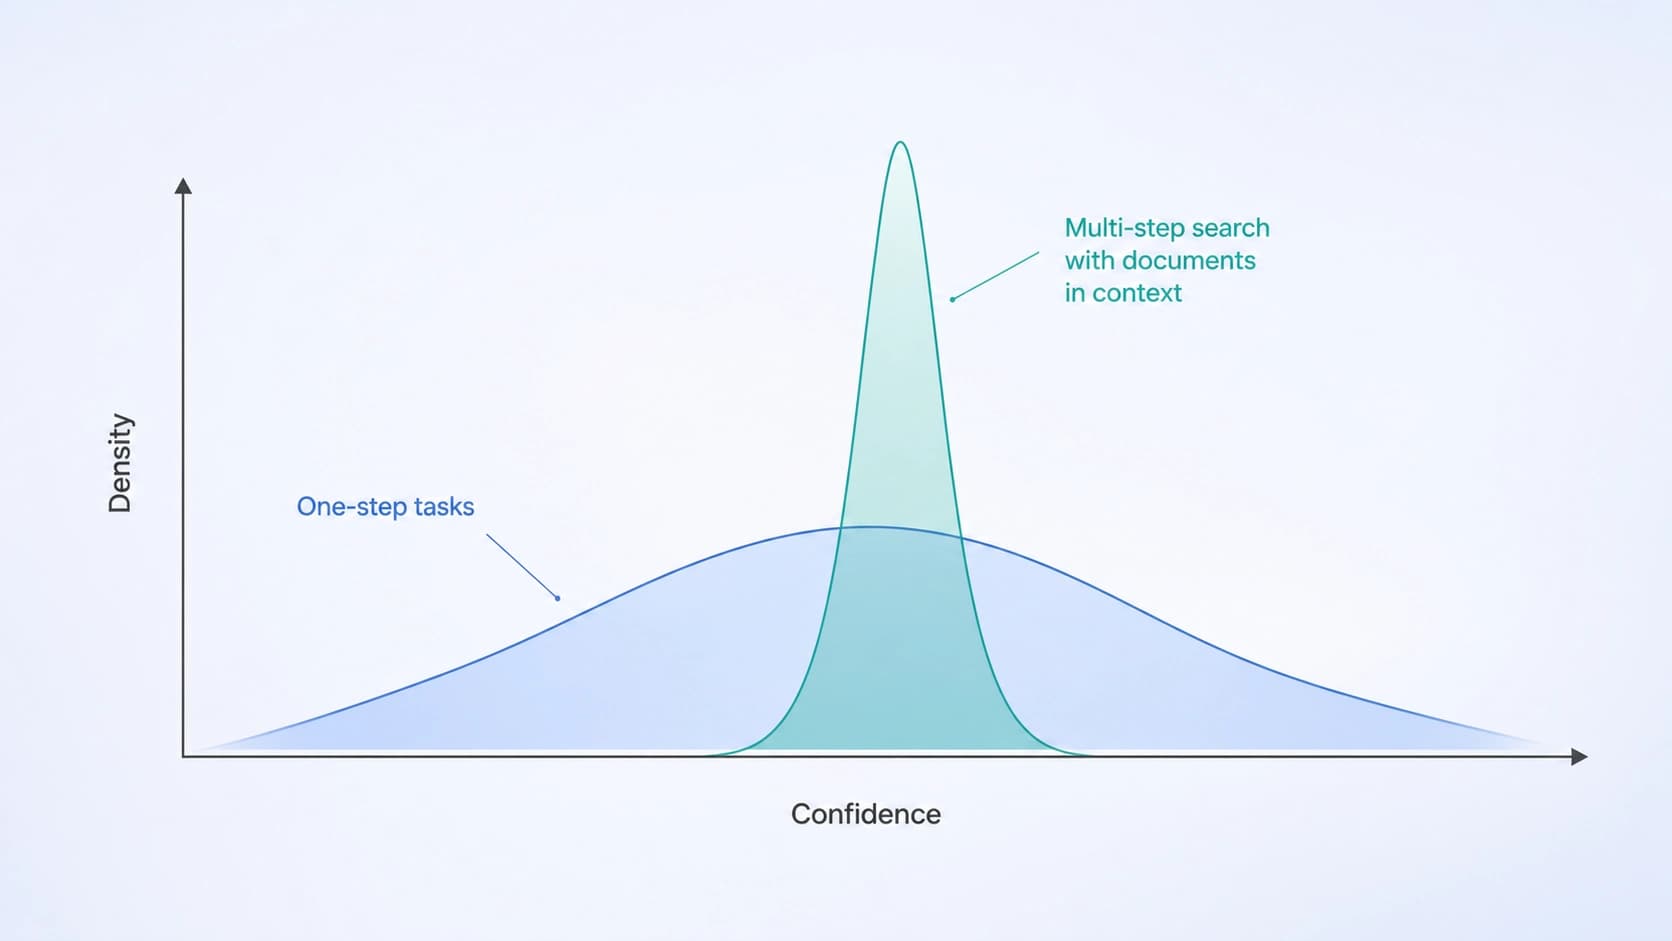
Pour des raisonnements en une seule étape, ce schéma se montre plutôt efficace : si le modèle se trompe, il hésite généralement, tandis qu'une réponse correcte s'accompagne d'une confiance élevée. L'écart entre les log-probabilités devient une sorte de détecteur d'erreurs intégré, qui ne nécessite ni appels supplémentaires, ni annotation, ni modèle-juge distinct.
Ça casse là où ça a commencé : sur la recherche multi-étapes
Le problème, c'est que les agents modernes sont construits autrement. Ils ne se contentent pas de raisonner en une seule passe : ils formulent des requêtes, récupèrent des documents externes, les intègrent au contexte, affinent la requête, et ainsi de suite plusieurs fois, jusqu'à avoir rassemblé assez de matière pour la réponse finale. Chaque étape ajoute des morceaux de texte étranger dans la fenêtre du modèle.
Les auteurs du travail « Beyond Confidence: Test-Time Scaling for Multi-Turn Search Agents via Retrieval Grounding » (arXiv:2608.24024, accepté dans les Findings de la conférence EMNLP 2026) — Hyunho Kook, Junhyuk So, Tianyu Fu, Haizhong Zheng et Beidi Chen — ont vérifié ce qui arrive au vote par confiance dans ce scénario. Le résultat est désagréable : la technique, rodée sur des tâches en une seule étape, se transpose mal aux agents de recherche.
Le mécanisme de défaillance : copy inflation
Les chercheurs ont nommé la cause copy inflation — « gonflement par copie ». Quand les documents extraits arrivent dans le contexte, les tokens que le modèle reprend de ces documents dans sa réponse reçoivent des log-probabilités systématiquement surestimées. Copier est une opération facile : poursuivre un texte qui se trouve juste sous les yeux est statistiquement plus simple que de générer quelque chose soi-même. Le modèle est « confiant » dans un tel token non parce qu'il est correct, mais parce qu'il est littéralement recopié.
Ensuite, l'effet s'accumule. Comme toutes les exécutions s'appuient d'une manière ou d'une autre sur les documents trouvés, toutes reçoivent leur part de probabilités gonflées. Les estimations de confiance au sein d'une même question s'aplatissent, se compriment dans une plage étroite — et le vote pondéré perd l'essentiel, ce pour quoi il existait : la capacité de distinguer une exécution forte d'une faible. Les poids deviennent presque identiques, et l'agrégation dégénère en simple majorité, avec juste une charge de calcul superflue en plus.
Ce qu'ils proposent : Retrieval-Grounded Voting
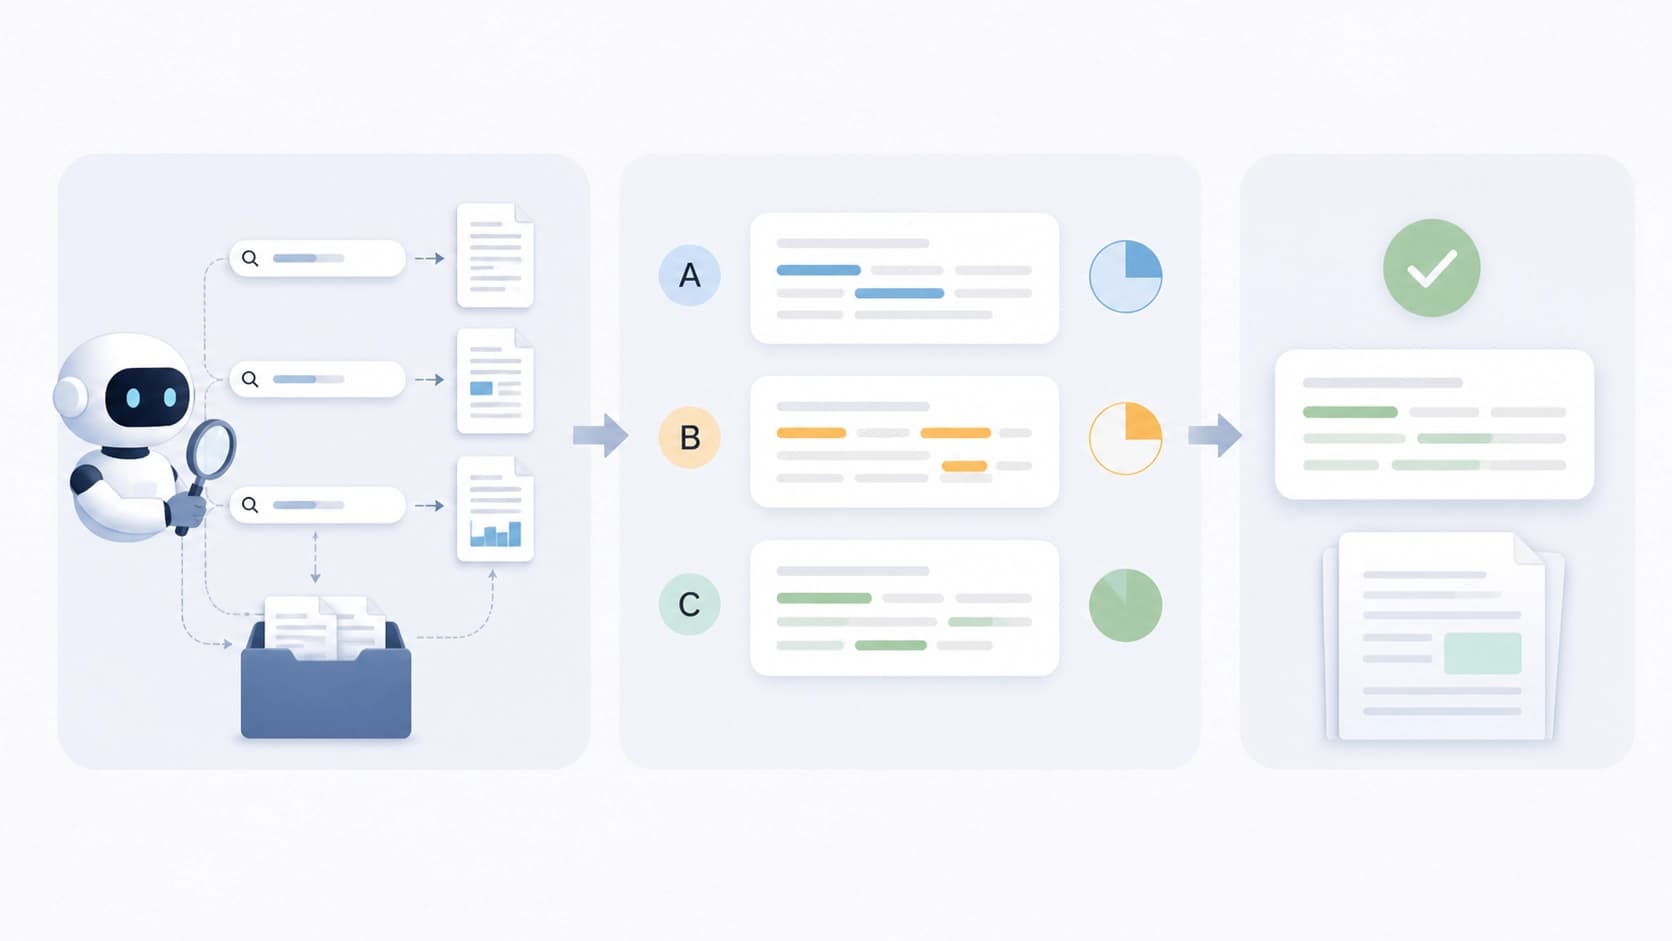
En remplacement, les auteurs proposent la méthode Retrieval-Grounded Voting (RGV). Elle évalue elle aussi chaque exécution séparément, mais ne regarde pas à l'intérieur du modèle — elle regarde vers l'extérieur, vers le lien entre la réponse finale et les documents que cette exécution a elle-même récupérés.
La métrique est volontairement simple : le recouvrement lexical entre le texte de la réponse et le texte des sources extraites. Plus la réponse s'appuie sur la matière trouvée, plus son score est élevé. Une exécution qui a inventé quelque chose de son cru ou est partie dans une autre direction partage moins de mots avec ses documents et reçoit un poids plus faible.
Pourquoi le signal fonctionne
La logique est la suivante : si l'agent a réellement trouvé des pages pertinentes et bâti sa conclusion dessus, les formulations de la réponse recouperont inévitablement celles des sources — termes, noms, tournures. Ce n'est pas un indice parfait de justesse, mais il reste robuste là où les log-probabilités sont déjà corrompues.
L'avantage clé de RGV, c'est qu'il calcule le signal hors du contexte pollué. L'évaluation se construit sur la paire « réponse — documents », et non sur l'état du modèle au moment de la génération ; le copy inflation n'a donc pas de prise sur elle. En prime, la méthode se passe d'accès aux log-probabilités des tokens et d'appels supplémentaires au LLM : pas de modèle-juge, pas de seconde passe, juste un comptage de recouvrements — une opération réalisable avec du code ordinaire, quasiment gratuitement.
Résultats
Les expériences ont été menées sur quatre benchmarks pour agents de recherche et cinq modèles de langage différents. Le tableau se répète : RGV devance systématiquement le vote par confiance.
La mesure la plus parlante concerne les questions « minority-correct », où la bonne réponse n'apparaît que dans une ou deux exécutions sur huit. C'est précisément là que la pondération par confiance échoue le plus durement : les probabilités gonflées tirent le vote vers la version majoritaire, mais erronée. Le gain apporté par RGV sur ces questions atteint +35 %, et jusqu'à +5,4 % en exactitude globale.
Les chiffres doivent être lus avec une réserve : ce n'est pas « plus cinq pour cent de qualité pour n'importe quel système de recherche », mais une amélioration de la procédure d'agrégation à modèle et ensemble d'exécutions fixés. Autrement dit, la méthode ne change rien à l'agent lui-même — elle choisit simplement avec plus de soin parmi ce que l'agent a déjà généré.
Ce que cela signifie en pratique
Si vous construisez un agent multi-étapes et utilisez déjà la self-consistency ou n'importe quel vote par probabilités, RGV présente trois avantages pratiques :
- Coût d'inférence nul. Aucun appel supplémentaire au modèle n'est nécessaire ; le poids se calcule a posteriori à partir des réponses et documents déjà produits.
- Compatible avec les modèles fermés. Les log-probabilités des tokens ne sont pas toujours accessibles, et parfois totalement masquées derrière une API. La comparaison de textes est libre de cette contrainte.
- Débogage prévisible. La métrique est transparente : on peut examiner quels mots ont produit une correspondance et comprendre pourquoi une exécution a reçu tel poids.
Où la méthode peut trébucher
Le point faible est évident dès la construction elle-même : le recouvrement lexical récompense la correspondance des mots, pas celle du sens. Une réponse reformulée mais correcte recevra un poids injustement faible ; un résultat numérique ou un résumé court ne recoupera lui non plus presque pas le texte source, même s'il y correspond parfaitement. La situation inverse est encore plus désagréable : une exécution qui se contente de citer longuement ce qu'elle a trouvé obtiendra un score élevé sans rien apporter à la solution.
D'où la stratégie raisonnable : considérer RGV non comme un remplacement de tous les signaux, mais comme une voix supplémentaire, particulièrement utile là où la confiance du modèle cesse de signifier quoi que ce soit. Il est logique aussi de le combiner avec des vérifications d'autres types : comparaison de sens, évaluation par un modèle distinct, vérification factuelle. Les auteurs, à en juger par la formulation de leur objectif, allaient exactement dans cette direction — de « faire confiance au ressenti interne du modèle » vers « évaluer ce qu'il a réellement fait ».
Bilan
L'histoire du copy inflation illustre bien un problème général des pipelines agentiques : les techniques rodées en isolation sur un modèle avec une seule étape de raisonnement s'effondrent discrètement quand la recherche, le contexte et des textes étrangers s'ajoutent à la boucle. La confiance du modèle cesse d'être une mesure de justesse et devient une mesure de facilité de copie.
RGV propose un contournement qui paraît presque ennuyeux — compter le recouvrement de mots entre la réponse et les sources. Mais c'est précisément cette platitude qui rend la méthode attrayante : elle est peu coûteuse, transparente, ne requiert pas les entrailles du modèle et offre un gain notable là où la bonne réponse se noie dans le bruit. Pour les équipes qui construisent des agents de recherche à partir d'API prêtes à l'emploi, c'est un cas rare d'amélioration utile qui n'exige ni réentraînement, ni nouveaux budgets d'inférence.


