
Agents LLM en production : taxonomie, architecture et limites du déploiement
L’article synthétise les recherches sur l’utilisation des grands modèles de langage dans les agents de production : il met en évidence les obstacles, les niveaux de capacité et une architecture à quatre couches. Il permet de comprendre quels scénarios du cycle de vie sont déjà étudiés et où subsistent des lacunes pour une planification autonome fiable.
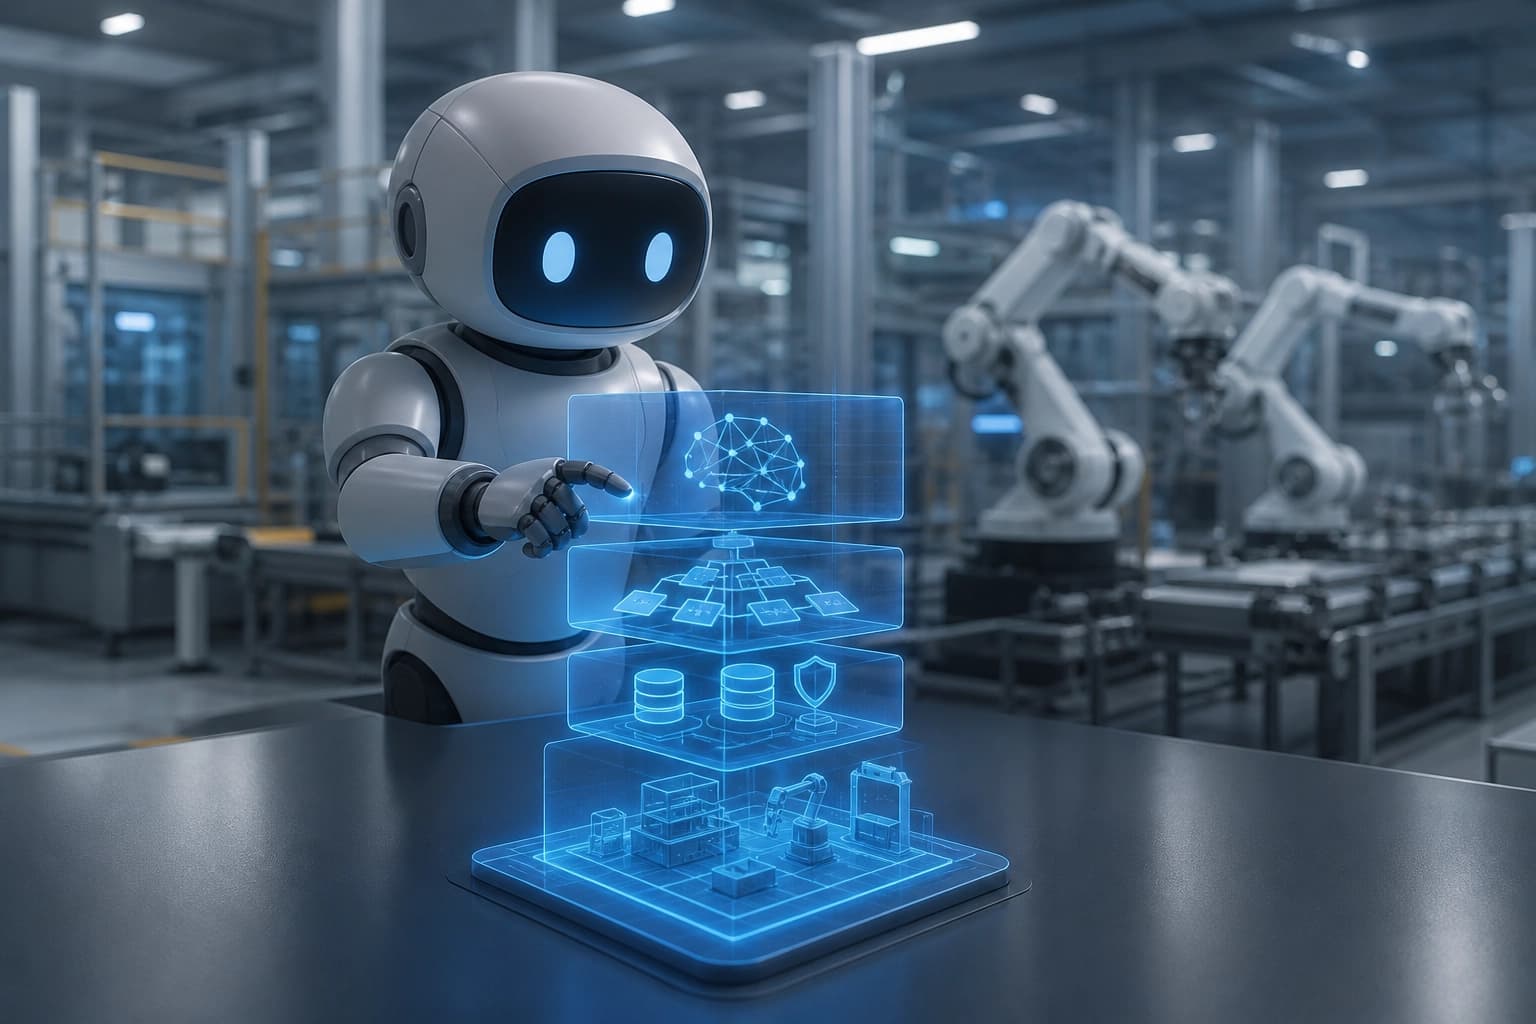
Capacités des agents autonomes
L’article arXiv:2610.26941 décrit comment les grands modèles de langage (LLM) permettent aux agents de dépasser les flux de travail prédéfinis. Les agents passent à la planification et à l’exécution autonomes des tâches.
Cela ouvre de nouvelles possibilités pour la production intelligente. Éléments clés :
- dépasser les flux de travail prédéfinis ;
- planification autonome ;
- exécution autonome des tâches.
Critère pratique : un agent est pertinent là où un processus prédéfini ne couvre pas la tâche. Un agent universel ne remplace pas automatiquement un tel processus.
Taxonomie des agents industriels
L’article propose une taxonomie unifiée. Elle couvre trois dimensions.
| Dimension de la taxonomie | Ce qu’elle couvre |
|---|---|
| Scénarios d’utilisation | Scénarios d’utilisation des agents en production |
| Formes d’incarnation | Formes d’incarnation des agents |
| Cinq niveaux de capacités | Niveaux de capacités des agents industriels |
Conclusion : la taxonomie pose trois questions au sujet de l’agent : le scénario, la forme d’incarnation et le niveau de capacités. Les réponses déterminent le périmètre du déploiement.
Architecture à quatre couches
L’article propose une architecture système à quatre couches. Elle comprend les principaux modules et mécanismes de fonctionnement nécessaires à une boucle fermée d’exécution des tâches.
Éléments clés de l’architecture :
- quatre couches ;
- principaux modules ;
- mécanismes de fonctionnement nécessaires à une boucle fermée d’exécution des tâches.
Critère pratique : l’architecture doit assurer une boucle fermée d’exécution des tâches.
Limites du déploiement
Trois facteurs compliquent le déploiement direct d’agents universels dans la production intelligente : un environnement dynamique, des contraintes physiques complexes et des exigences strictes en matière de fiabilité. L’article met également en évidence cinq problèmes clés.
Obstacles et problèmes :
- environnement dynamique ;
- contraintes physiques complexes ;
- exigences strictes en matière de fiabilité ;
- cinq problèmes clés mis en évidence dans l’article.
Critère pratique : avant le déploiement, vérifier le fonctionnement de l’agent dans un environnement dynamique, en présence de contraintes physiques et d’exigences de fiabilité.
Foire aux questions
Matériaux connexes
Tous matériaux
Des vidéos disparates aux packs de créations : un regard pratique sur Higgsfield
La plateforme permet de créer des vidéos publicitaires à partir de texte, d’images et de liens vers des produits, tandis que Marketing Studio et Supercomputer font passer le travail d’un seul clip à un cycle de campagne. L’article présente des cas d’usage pour les petites entreprises et le commerce en ligne, ainsi que les risques liés aux artefacts, aux droits sur le contenu et à la vérification obligatoire avant publication.
17 novembre 2026
Approche OWP : redistribution des éléments de preuve et des signaux a priori dans Omni-LLM
Le framework Omni-Woodpecker, qui ne nécessite aucun entraînement, détecte les conflits entre les modalités et ajuste, avant le décodage, l’équilibre entre les données contextuelles et les a priori mémorisés dans les états cachés. Sur Qwen2.5-Omni-7B et VideoLLaMA2-AV, la méthode améliore la robustesse face aux erreurs audiovisuelles sur CMM et AVHBench, et apporte un gain modéré sur les benchmarks généraux de raisonnement.
17 novembre 2026
LightCRS : un schéma compact de recommandation conversationnelle multi-domaines sans VLM distinct pour chaque catégorie
Les auteurs présentent un système dans lequel les caractéristiques multimodales des produits sont calculées hors ligne par des encodeurs figés, puis traitées au cours du dialogue par un module partagé entre tous les domaines, comptant 5,3 millions de paramètres et doté d’une cross-attention dépendante de la requête. Sur un benchmark couvrant 25 domaines, cette approche améliore les métriques moyennes de classement, réduit sensiblement la latence et montre que l’apprentissage conjoint apporte un gain par rapport aux modèles distincts entraînés sur un seul domaine.
16 novembre 2026