
LightCRS : un schéma compact de recommandation conversationnelle multi-domaines sans VLM distinct pour chaque catégorie
Les auteurs présentent un système dans lequel les caractéristiques multimodales des produits sont calculées hors ligne par des encodeurs figés, puis traitées au cours du dialogue par un module partagé entre tous les domaines, comptant 5,3 millions de paramètres et doté d’une cross-attention dépendante de la requête. Sur un benchmark couvrant 25 domaines, cette approche améliore les métriques moyennes de classement, réduit sensiblement la latence et montre que l’apprentissage conjoint apporte un gain par rapport aux modèles distincts entraînés sur un seul domaine.
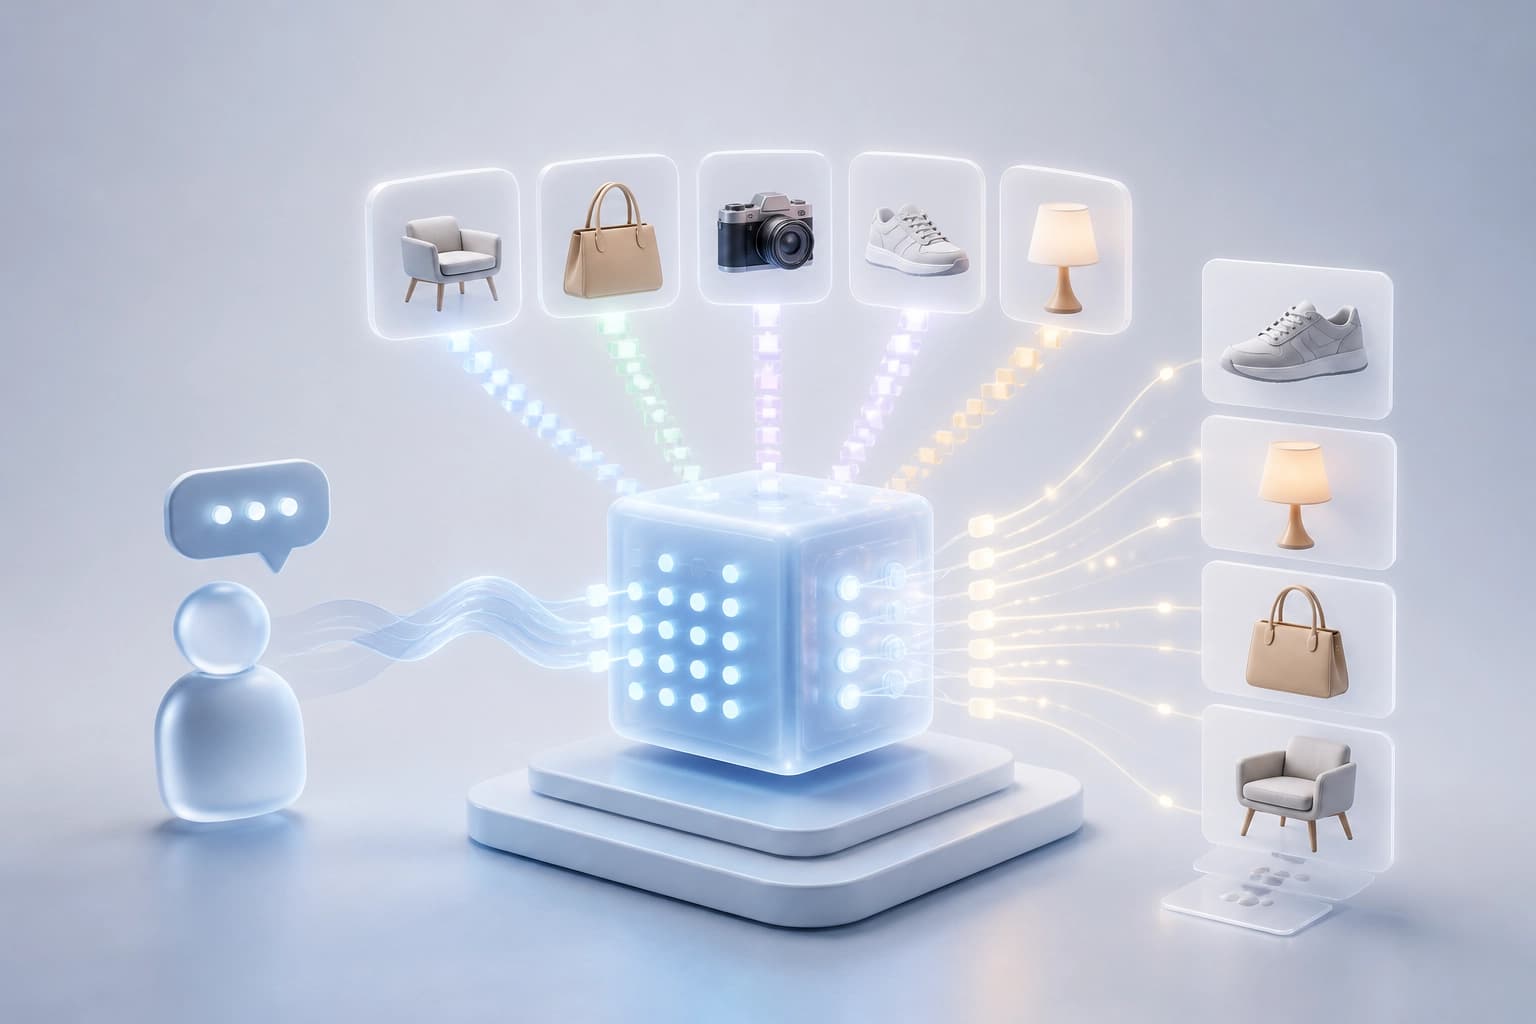
Tâche : recommandations conversationnelles sans VLM distincte par domaine
LightCRS est un système léger de recommandation conversationnelle multimodale couvrant plusieurs domaines. Les travaux ont été préparés par He Ma, Lan You, Qiyang Wu et Chen Liu. Le préprint arXiv:2610.26948 a été soumis le 18 octobre 2026.
Caractéristiques clés :
- Fonctionnement en mode conversationnel.
- Données multimodales sur les produits.
- Plusieurs domaines au sein d’un même système.
- Architecture légère sans VLM distincte pour chaque catégorie.
Le système résout le problème du choix d’un produit dans une conversation. L’utilisateur recherche une recommandation dans plusieurs domaines. Critère pratique : examiner les architectures qui prennent en charge plusieurs domaines sans nécessiter une VLM distincte pour chaque catégorie.
Architecture : encodeurs hors ligne et module partagé de 5.3M
Dans LightCRS, les représentations multimodales des produits sont calculées à l’avance hors ligne. Des encodeurs gelés sont utilisés à cette fin.
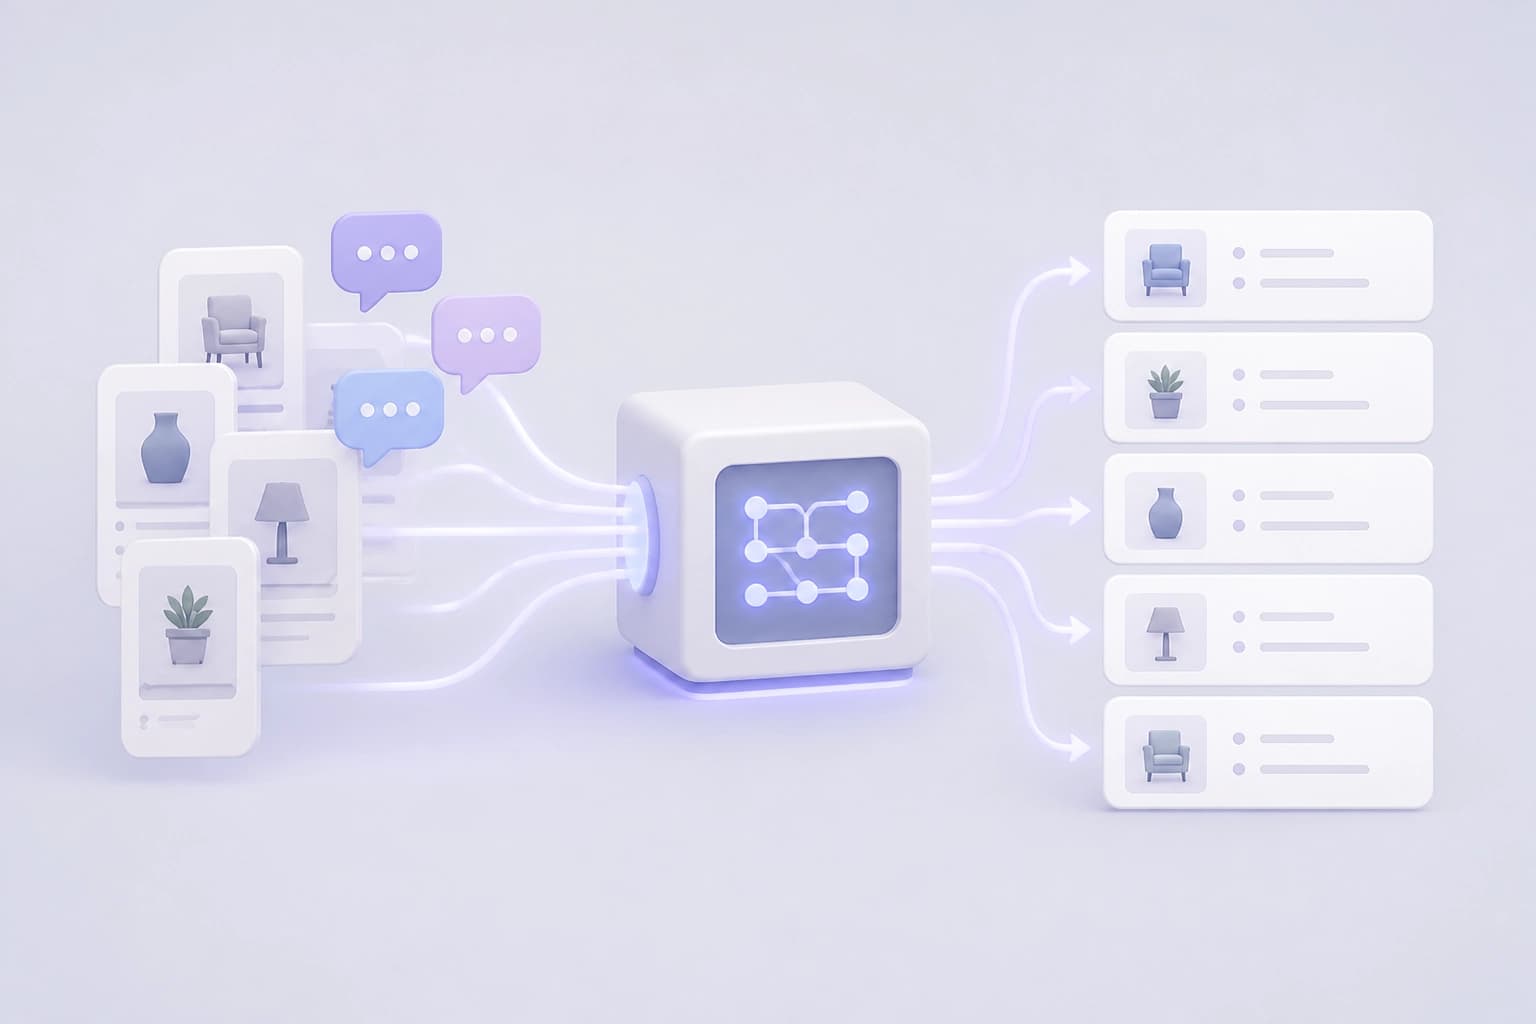
Étapes à l’exécution :
- Un module compact de 5.3M paramètres combine les données de la conversation.
- Le lien entre la requête et les représentations passe par une attention croisée conditionnée par la requête (query-conditioned cross-attention).
- Les candidats sont comparés conjointement par un Transformer inter-candidats (inter-candidate Transformer).
Les paramètres du module sont partagés entre tous les domaines. Critère pratique : vérifier quels composants sont exécutés hors ligne et combien de paramètres restent à l’exécution. Pour une architecture multidomaine, un module partagé est essentiel, plutôt qu’un ensemble de modèles distincts.
Multidomaine : paramètres partagés et apprentissage conjoint
LightCRS utilise un ensemble de paramètres commun à tous les domaines. C’est ce qui le distingue principalement de l’approche reposant sur un modèle distinct pour chaque catégorie.
| Variante d’apprentissage | HR@1 |
|---|---|
| Apprentissage conjoint sur plusieurs domaines | +15.2% par rapport aux modèles monodomaine |
| Modèles monodomaine entraînés séparément | Base de comparaison |
L’apprentissage conjoint est un facteur à part entière. Critère pratique : comparer un module multidomaine partagé à un ensemble de modèles monodomaine selon HR@1. L’effet de l’apprentissage conjoint doit être mesuré, et non supposé.
Benchmark MM-R2A-25 : 25 domaines issus de Reddit et Amazon
Pour l’évaluation, les auteurs ont créé MM-R2A-25.
Composition du benchmark :
- 25 domaines.
- Des conversations naturelles issues de Reddit, dans lesquelles les utilisateurs recherchent des recommandations.
- Des fiches produits Amazon.
LightCRS est évalué sur cet ensemble. Le benchmark teste le système sur différents domaines et sur des conversations naturelles. Il ne se limite pas à un seul type de produit.
Critère pratique : examiner les domaines et les conversations sur lesquels le système a été évalué. Un benchmark multidomaine est plus utile qu’un rapport portant sur une seule catégorie.
Résultats : HR@1, NDCG@5, MRR et latence
LightCRS est comparé aux méthodes de référence selon trois métriques et la latence.
| Indicateur | Résultat de LightCRS |
|---|---|
| Résultats moyens pour HR@1, NDCG@5 et MRR | Meilleurs |
| HR@1 par rapport à la méthode de référence la plus performante | +35.4% |
| Latence par requête | Réduite d’un facteur de 266 |
Le gain en qualité s’accompagne d’une réduction importante de la latence dans la comparaison décrite. Critère pratique : examiner non seulement HR@1, mais aussi NDCG@5, MRR et la latence. Un seul indicateur ne suffit pas à décrire le compromis entre qualité et latence.
Points à vérifier lors du choix d’une architecture similaire
- Des paramètres partagés entre tous les domaines.
- L’encodage hors ligne des représentations multimodales par des encodeurs gelés.
- La taille du module à l’exécution : celle de LightCRS est de 5.3M paramètres.
- La comparaison conjointe des candidats par un Transformer inter-candidats (inter-candidate Transformer).
- Une évaluation sur des conversations multidomaines, avec les métriques HR@1, NDCG@5, MRR et la latence par requête.
Critère pratique : exiger la publication des métriques et des conditions du benchmark. Une architecture reposant sur un module partagé compact est intéressante lorsque les domaines sont nombreux et que l’exécution doit rester légère.
Foire aux questions
Matériaux connexes
Tous matériaux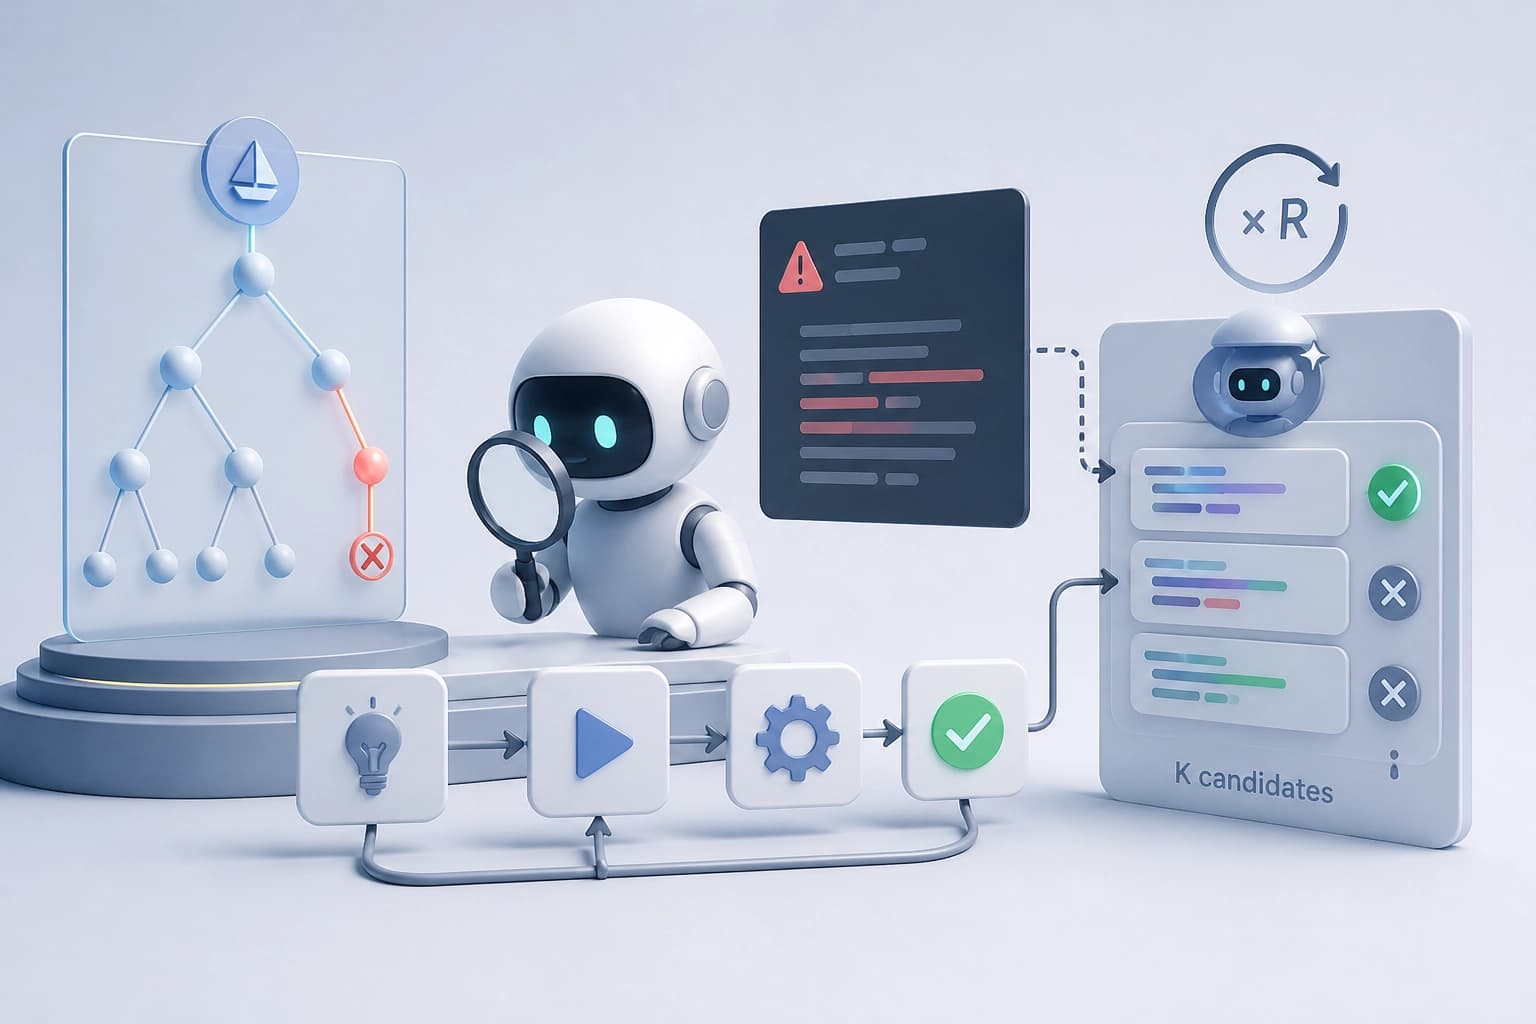
Réparation limitée des tactiques dans Lean 4 à l’aide des diagnostics du compilateur
Un module itératif est proposé : au lieu d’écarter une tactique rejetée, il demande au modèle correcteur de la corriger jusqu’à R fois en tenant compte de l’erreur Lean ; avec K candidats, cela augmente le taux de résolution des problèmes. Les expériences menées sur LeanDojo et Lean Workbook montrent que les gains proviennent principalement de défaillances d’exécution superficielles, au prix d’un temps de recherche accru.
16 novembre 2026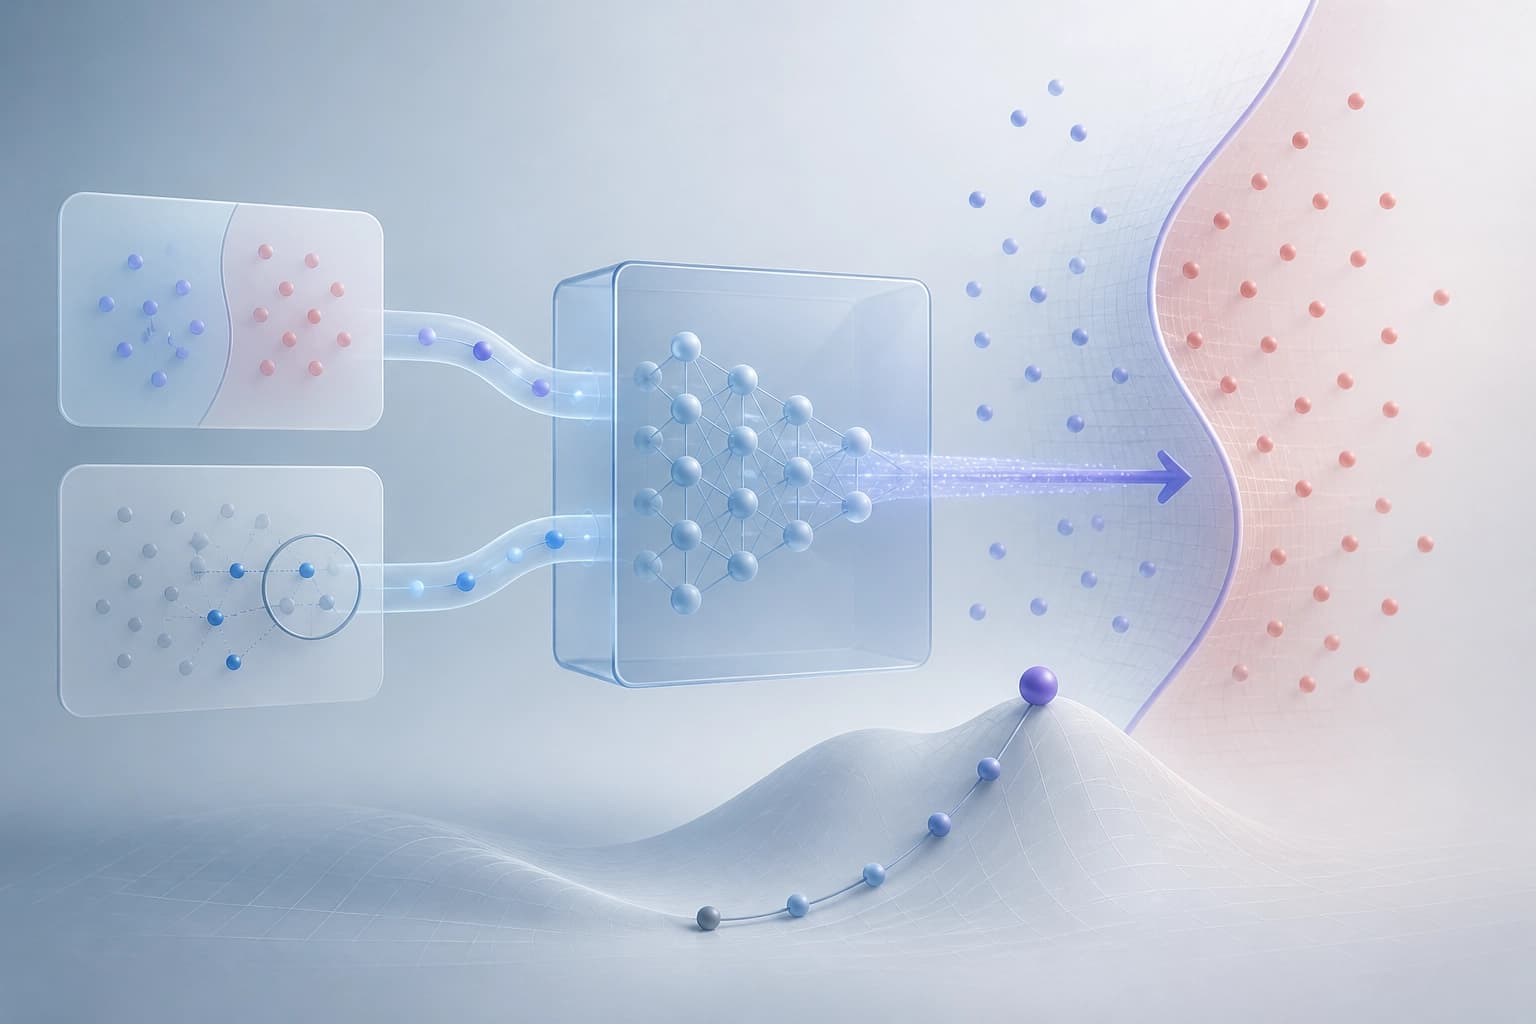
Méthode Genesis Steering : pilotage par activation sur les données utilisées pour le fine-tuning
La méthode extrait un vecteur de contrôle à partir d’exemples contrastifs présents dans les données de fine-tuning et, si celles-ci ne sont pas disponibles, sélectionne des échantillons d’entraînement probables par inférence d’appartenance et constitue un jeu de données proxy. La partie théorique décrit le déplacement optimal vers la frontière de décision et l’évaluation sur des données proxy ; empiriquement, les données internes de Tülu-3-8B produisent un effet plus marqué que les jeux de données externes, tandis que l’utilité du proxy MIA sur Llama-3.1-8B-Instruct est limitée par le rapport entre les décalages directionnels.
16 novembre 2026
Apprentissage tabulaire en contexte avec des experts clairsemés : le modèle compact OrionMoE-Small-v1.0
Un modèle de base compact pour les tâches tabulaires est présenté : il prédit de nouvelles observations à partir d’un tableau de référence annoté, sans ajustement supplémentaire des paramètres. La sélection adaptative d’experts en fonction du jeu de données et des représentations des caractéristiques offre des résultats compétitifs, en particulier avec un contexte limité et une grande dimensionnalité.
15 novembre 2026