
Approche OWP : redistribution des éléments de preuve et des signaux a priori dans Omni-LLM
Le framework Omni-Woodpecker, qui ne nécessite aucun entraînement, détecte les conflits entre les modalités et ajuste, avant le décodage, l’équilibre entre les données contextuelles et les a priori mémorisés dans les états cachés. Sur Qwen2.5-Omni-7B et VideoLLaMA2-AV, la méthode améliore la robustesse face aux erreurs audiovisuelles sur CMM et AVHBench, et apporte un gain modéré sur les benchmarks généraux de raisonnement.
Qu’est-ce que OWP et quel problème résout-il
Omni-Woodpecker (OWP) est un framework sans entraînement destiné à corriger les hallucinations intermodales des LLM Omni. La méthode déplace la correction du niveau des données de sortie vers le rééquilibrage des représentations provoqué par les conflits entre modalités. Les auteurs ont soumis l’article le 19 octobre 2026 : Zijian Liu, Chaoyou Fu, Yan Yang, Caifeng Shan, Ran He.
La correction traditionnelle intervient sur une réponse déjà générée. OWP intervient sur les représentations internes avant le décodage. Cela modifie le point d’application de la méthode.
Conclusion : OWP modifie le point de correction, au lieu de retoucher la réponse générée.
Étapes de rééquilibrage des éléments de preuve et des signaux a priori
OWP effectue un rééquilibrage en plusieurs étapes. La méthode commence par repérer les conflits intermodaux à partir de représentations supplémentaires propres à chaque modalité.
- Repérage des conflits intermodaux à partir de représentations supplémentaires propres à chaque modalité.
- Décomposition orthogonale des états cachés afin de séparer les éléments de preuve d’ancrage des évaluations a priori concurrentes.
- Rééquilibrage adaptatif des représentations fusionnées : suppression des a priori trompeurs et restauration des éléments de preuve ignorés.
- Transmission des représentations corrigées au décodage.
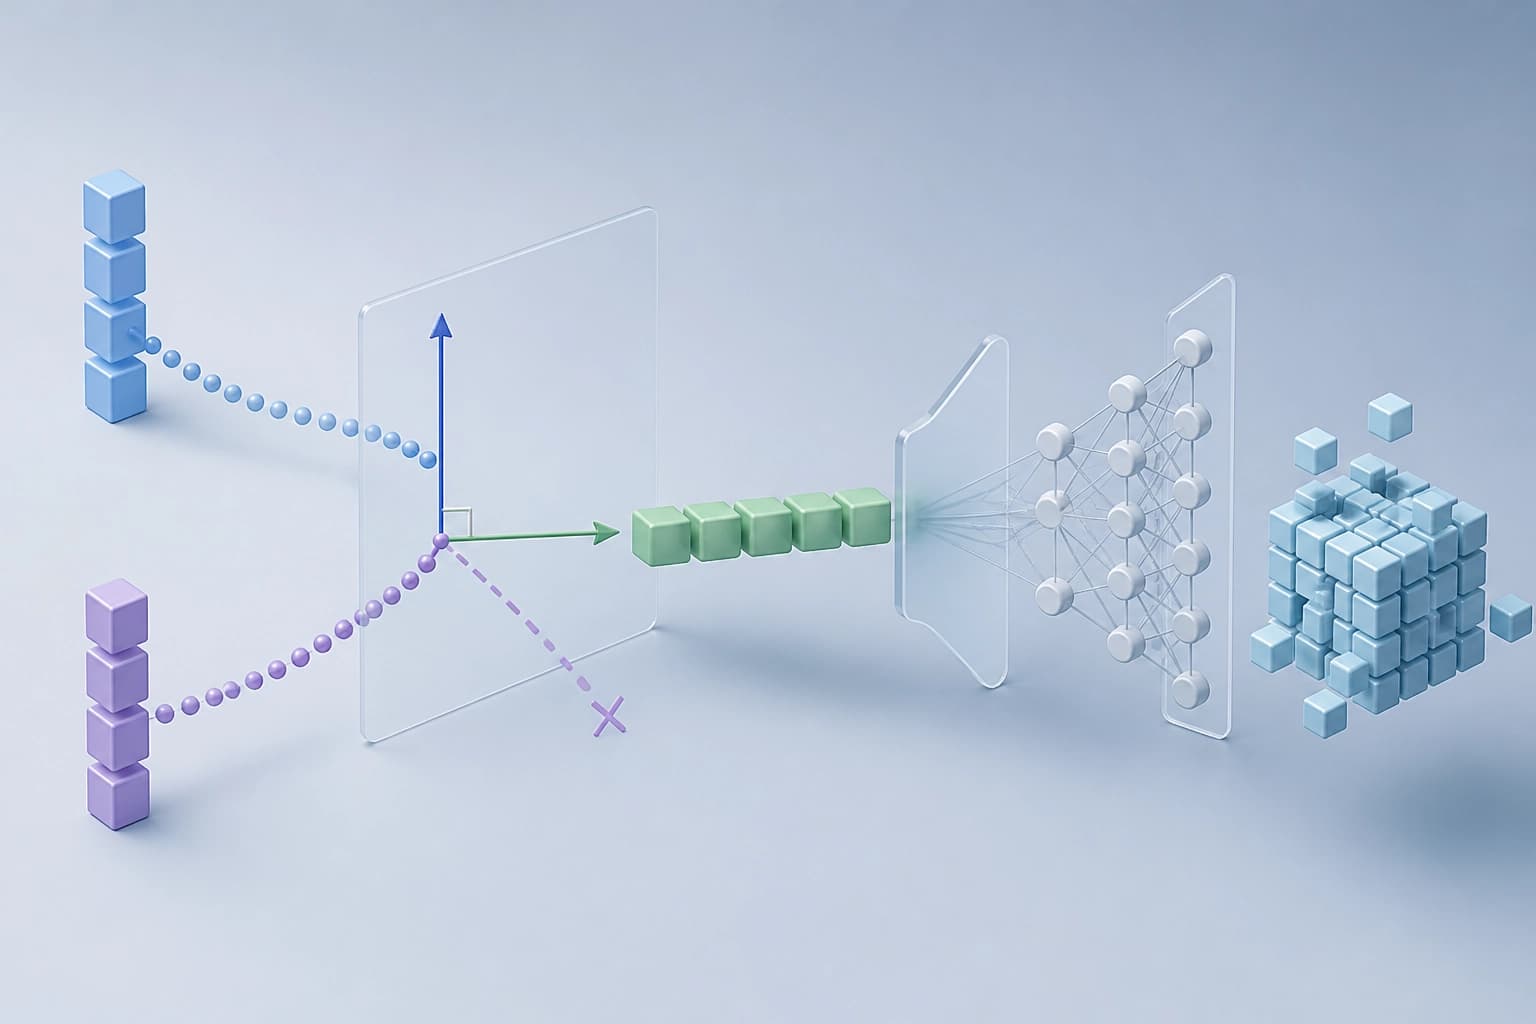
La méthode ne modifie pas les poids du modèle. Elle corrige les représentations avant la génération.
Conclusion : OWP ne nécessite ni entraînement ni modification des poids. Il agit sur les états cachés avant le décodage.
Résultats : gains sur les benchmarks et transférabilité
Sur Qwen2.5-Omni-7B, OWP améliore les résultats de 12,9 et 8,6 points sur CMM et AVHBench. Sur quatre benchmarks généraux de raisonnement OLLM, le gain est de 0,67 à 2,25 points.
| Modèle | CMM | AVHBench |
|---|---|---|
| Qwen2.5-Omni-7B | +12,9 points | +8,6 points |
| VideoLLaMA2-AV | +4,6 points | +3,9 points |
La méthode a démontré sa transférabilité à VideoLLaMA2-AV, avec une amélioration de 4,6 et 3,9 points sur CMM et AVHBench. Les auteurs indiquent qu’elle est efficace et transférable d’une architecture à l’autre. Le code est disponible publiquement.
Conclusion : le gain dépend du modèle et du benchmark. En pratique, il convient de tester OWP sur sa propre architecture et sur l’ensemble de tâches visé avant de le déployer.
Critères pratiques pour choisir OWP
OWP convient dans plusieurs cas. La méthode fonctionne sans entraînement ni modification des poids du modèle.
- Une correction des hallucinations intermodales sans entraînement est nécessaire.
- Les états cachés et les représentations propres à chaque modalité sont accessibles.
- Une intervention avant le décodage est requise, plutôt qu’un post-traitement de la réponse.
- Il est possible de reproduire la méthode : le code est disponible publiquement.
OWP est une méthode sans entraînement pour rééquilibrer les éléments de preuve et les signaux a priori. Les auteurs indiquent qu’elle est transférable d’une architecture à l’autre. Une vérification sur le modèle concerné reste une étape indispensable.
Foire aux questions
Matériaux connexes
Tous matériaux
LightCRS : un schéma compact de recommandation conversationnelle multi-domaines sans VLM distinct pour chaque catégorie
Les auteurs présentent un système dans lequel les caractéristiques multimodales des produits sont calculées hors ligne par des encodeurs figés, puis traitées au cours du dialogue par un module partagé entre tous les domaines, comptant 5,3 millions de paramètres et doté d’une cross-attention dépendante de la requête. Sur un benchmark couvrant 25 domaines, cette approche améliore les métriques moyennes de classement, réduit sensiblement la latence et montre que l’apprentissage conjoint apporte un gain par rapport aux modèles distincts entraînés sur un seul domaine.
16 novembre 2026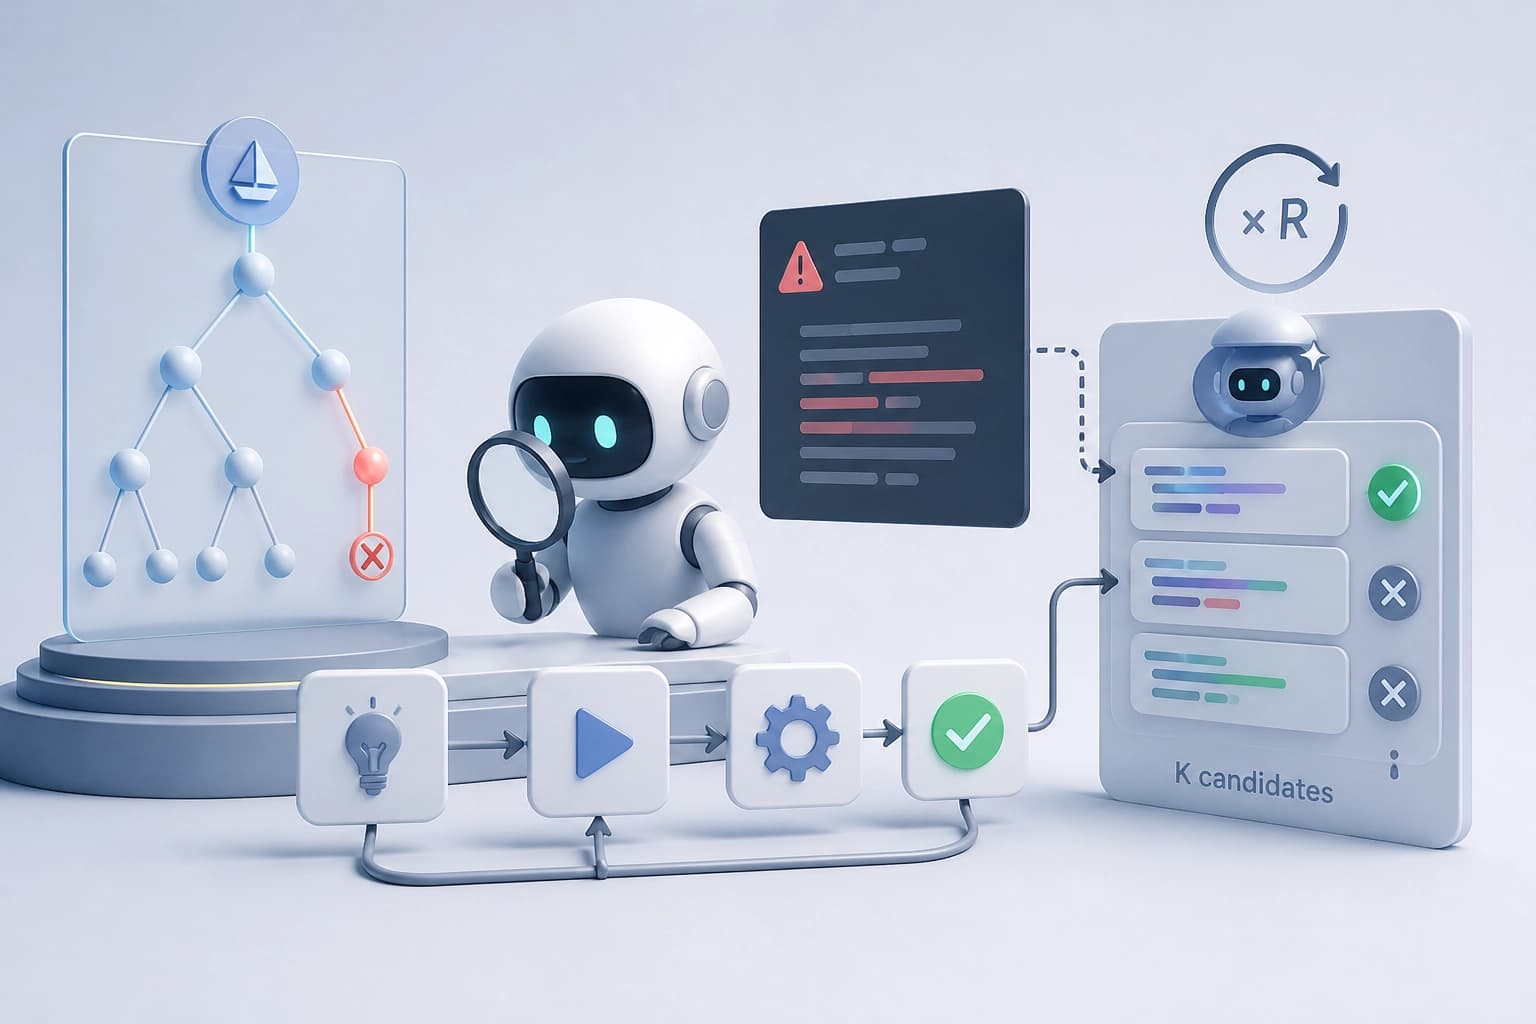
Réparation limitée des tactiques dans Lean 4 à l’aide des diagnostics du compilateur
Un module itératif est proposé : au lieu d’écarter une tactique rejetée, il demande au modèle correcteur de la corriger jusqu’à R fois en tenant compte de l’erreur Lean ; avec K candidats, cela augmente le taux de résolution des problèmes. Les expériences menées sur LeanDojo et Lean Workbook montrent que les gains proviennent principalement de défaillances d’exécution superficielles, au prix d’un temps de recherche accru.
16 novembre 2026
Méthode Genesis Steering : pilotage par activation sur les données utilisées pour le fine-tuning
La méthode extrait un vecteur de contrôle à partir d’exemples contrastifs présents dans les données de fine-tuning et, si celles-ci ne sont pas disponibles, sélectionne des échantillons d’entraînement probables par inférence d’appartenance et constitue un jeu de données proxy. La partie théorique décrit le déplacement optimal vers la frontière de décision et l’évaluation sur des données proxy ; empiriquement, les données internes de Tülu-3-8B produisent un effet plus marqué que les jeux de données externes, tandis que l’utilité du proxy MIA sur Llama-3.1-8B-Instruct est limitée par le rapport entre les décalages directionnels.
16 novembre 2026