
Pourquoi « montre-moi où c'est » est la mauvaise question
Le test classique d'orientation visuelle ressemble presque à un exercice d'école : on donne une image et une phrase du type « le dossier bleu sur l'étagère du bas », et le modèle doit indiquer où se trouve l'objet recherché. Une requête, une réponse, une métrique — il a trouvé ou non.
Le schéma est pratique, mais il décrit non pas une conversation, mais une commande. Dans une communication réelle, une personne donne rarement une description exhaustive du premier coup. Elle dit « ben ce truc à côté de la fenêtre » et compte sur son interlocuteur pour deviner ou poser une question. La compréhension mutuelle se construit au fil du dialogue — parfois en deux tours, parfois en cinq.
Les auteurs du travail arXiv:2608.23978 (Zhengxiang Wang et Owen Rambow, article accepté à EMNLP 2026) proposent de considérer précisément cette étape manquante comme objet de mesure. Leur question est la suivante : le modèle sait-il non seulement regarder, mais aussi poser des questions quand les images et les mots ne suffisent pas pour parvenir à une conclusion univoque.
Comment l'expérience est structurée
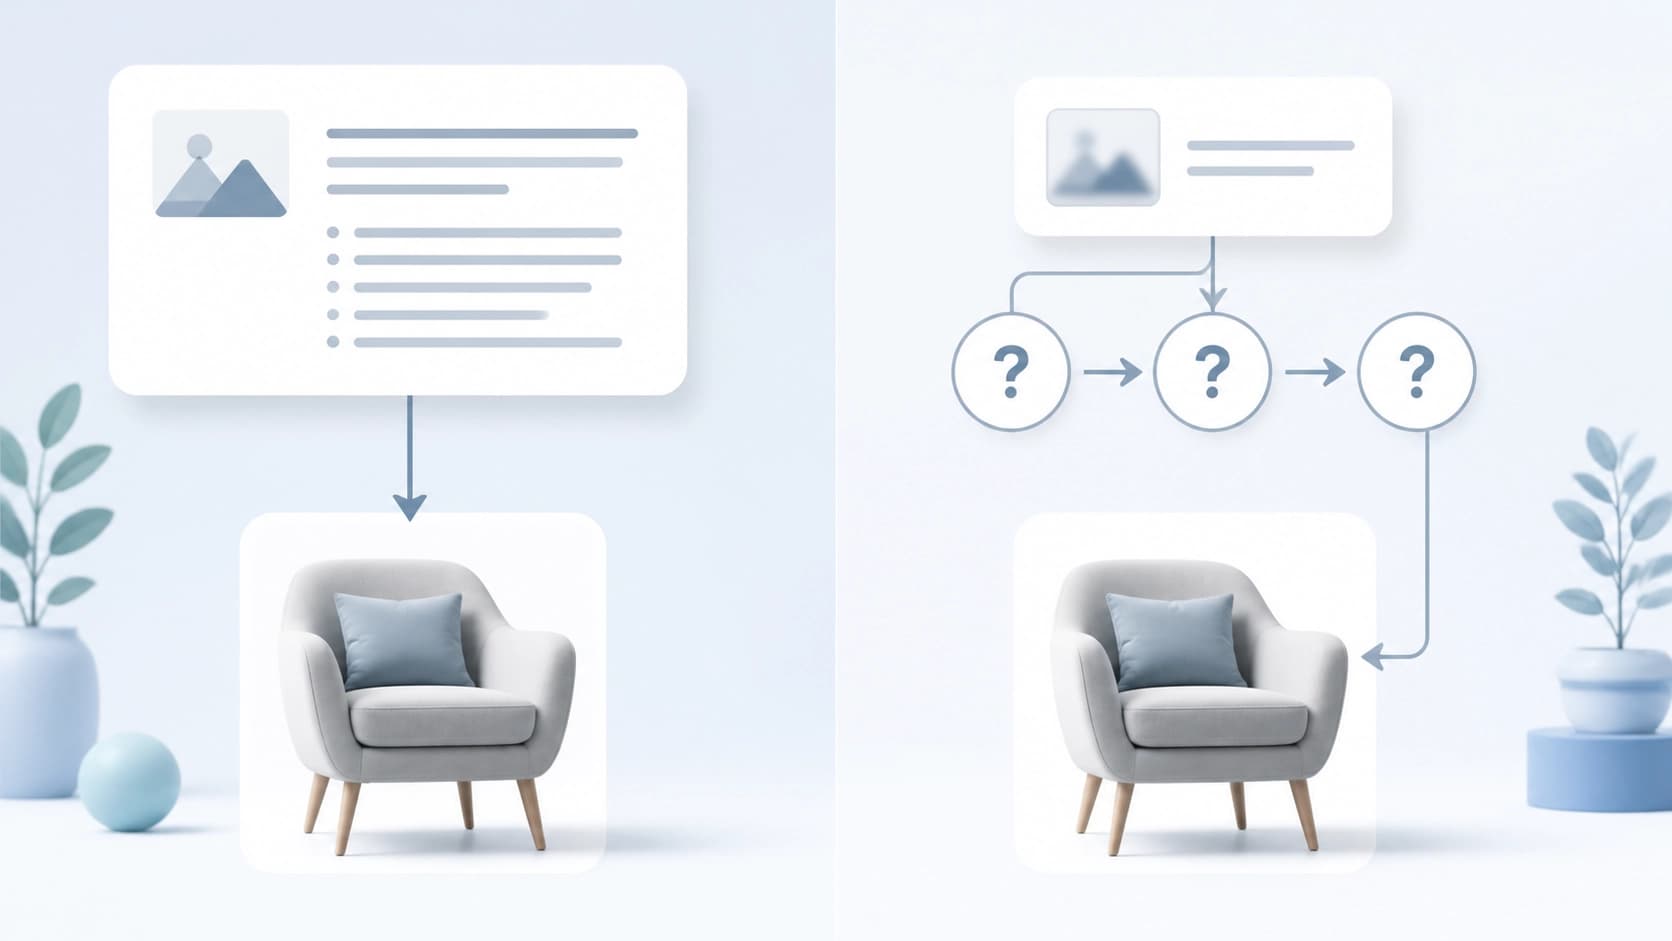
Un déficit d'information contrôlé
L'idée clé est de ne pas mesurer la précision « en moyenne », mais de réguler progressivement la quantité d'informations sur la cible fournie à l'avance, et celle que le modèle doit obtenir par lui-même. À un bout de l'échelle, la tâche ne diffère presque pas d'un test en une seule étape classique : la description est détaillée, la cible est évidente. À l'autre, il n'y a aucune formulation initiale, et tout ce que le modèle sait de l'objet recherché, il doit l'extraire de ses propres questions de clarification.
Cette construction permet de séparer la compétence de reconnaissance de la compétence à mener un dialogue. Un modèle qui trouve parfaitement un objet à partir d'un indice précis peut complètement échouer quand l'indice doit être assemblé pièce par pièce.
Quatre contextes et quatre protocoles
L'environnement expérimental s'appuie sur quatre contextes visuels proches de scénarios humains, et quatre protocoles d'interaction différents. C'est important : le résultat ne se réduit pas à une configuration réussie ou ratée. On a également vérifié qui formule la description — un humain ou un autre modèle — ainsi que l'influence du volume de raisonnement, des tentatives répétées et du changement de fournisseur de descriptions. Les régularités dont il est question ci-dessous se sont reproduites dans toutes ces variantes.
Où exactement cela casse
L'écart avec l'humain se maintient sur tous les protocoles
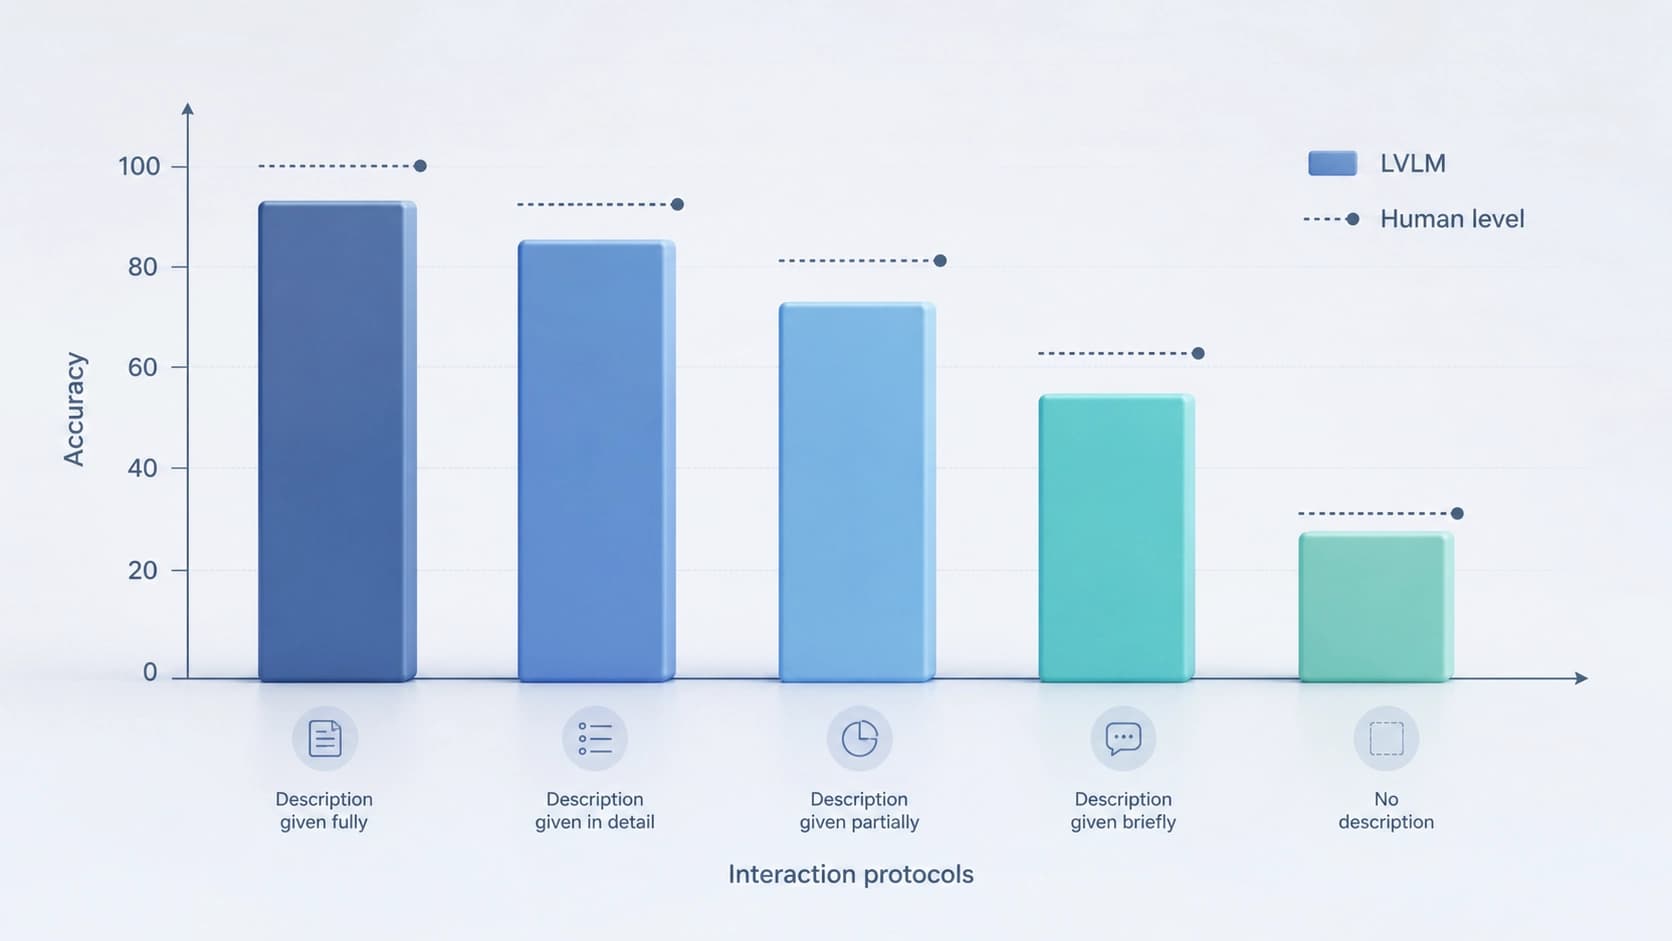
La conclusion principale n'est pas réjouissante : dans aucun des modes, les grands modèles visuels-langagiers actuels ne se sont approchés des performances de référence humaines. L'écart persiste aussi bien quand la tâche paraît presque triviale que quand elle exige un véritable dialogue. Il ne s'agit pas de quelques points de pourcentage, mais d'une différence qualitative de fiabilité.
Le pire, c'est quand il n'y a aucune description
Les résultats les plus faibles ont été enregistrés dans le scénario où la formulation initiale de la cible est absente. Le modèle doit lui-même construire une hypothèse sur ce qu'il faut chercher, poser des questions et, à partir des réponses, réduire la zone de recherche. Il ne s'agit plus de reconnaissance, mais de comportement proactif : il faut décider soi-même que l'information manque et formuler une requête qui comblera ce manque.
C'est là que se manifeste l'échec mis en avant dans le titre du travail : le modèle sait regarder, mais pas poser des questions. Soit il mise sur une supposition, soit il pose des questions qui n'apportent aucune clarification.
La clarification fonctionne, mais pas toujours
L'interaction n'est pas inutile. Quand une question de clarification corrige ou complète la description initiale, la précision augmente sensiblement. Autrement dit, le mécanisme du dialogue est présent dans le modèle et apporte un bénéfice — mais seulement dans le rôle d'éditeur de la formulation d'autrui. Dès que la formulation doit être créée de zéro, l'avantage disparaît.
La confiance avant la précision
Une ligne d'analyse distincte — la calibration. Les modèles affichent systématiquement une confiance supérieure à celle que confirme leur précision réelle. Concrètement, cela signifie qu'on ne peut pas juger, à partir de la réponse d'un modèle, s'il faut lui faire confiance : un choix correct comme un choix erroné s'accompagnent d'un ton tout aussi assuré.
Pour les applications, c'est plus dangereux que de simples erreurs. Si le système se trompe mais signale honnêtement son incertitude, on peut lui poser une question de clarification ou faire appel à un humain. S'il se trompe avec un air convaincu, il n'est pas possible d'intégrer une telle sécurité.
Pourquoi la tâche est plus difficile qu'elle n'en a l'air
L'orientation visuelle interactive exige le fonctionnement simultané de trois mécanismes :
- l'appariement visuel — relier les mots aux objets de l'image, y compris les relations spatiales et les propriétés ;
- la recherche d'information — comprendre quelles informations manquent et les obtenir par une question, plutôt que par tâtonnement ;
- la synthèse — rassembler des réponses éparses en une hypothèse unique et ne pas la perdre en chemin.
Chaque compétence prise isolément existe, à des degrés divers, chez les modèles actuels. C'est la jonction entre elles qui casse : ce qui est vu ne se transforme pas en question, et la réponse à une question ne restructure pas la vision du monde.
Ce que cela signifie en pratique
Si vous construisez un produit sur la base d'un modèle multimodal — disons GPT-4o ou n'importe quelle autre API prenant en charge les images — les conclusions du travail se transposent facilement en solutions d'ingénierie :
- Ne vous fiez pas à la première description. Si l'utilisateur formule sa requête de manière floue, prévoyez une boucle de clarifications plutôt qu'une seule paire requête-réponse.
- Ne vous fiez pas à la confiance déclarée. La calibration gagne à être construite sur votre propre annotation adaptée à la tâche, plutôt que sur l'auto-évaluation du modèle.
- Concevez les questions à la place du modèle. Si le système ne sait pas déterminer lui-même ce qui lui manque, le rôle de celui qui pose les questions devra être assumé par une couche de logique externe.
- Testez sur votre propre déficit d'information. Il est utile de vérifier comment le pipeline se comporte précisément dans les modes où, selon les données des auteurs, la précision s'effondre.
Bilan
Le travail constate non pas une absence de capacités, mais une inadéquation des compétences. Les modèles voient suffisamment pour répondre à des questions bien posées, mais ne comprennent pas assez la situation pour les poser eux-mêmes. Tant que cet écart n'est pas comblé, l'orientation visuelle interactive restera une tâche où l'humain demeure le maillon le plus fiable du dialogue.


