
Pourquoi une politique unique ne convient jamais à tout le monde
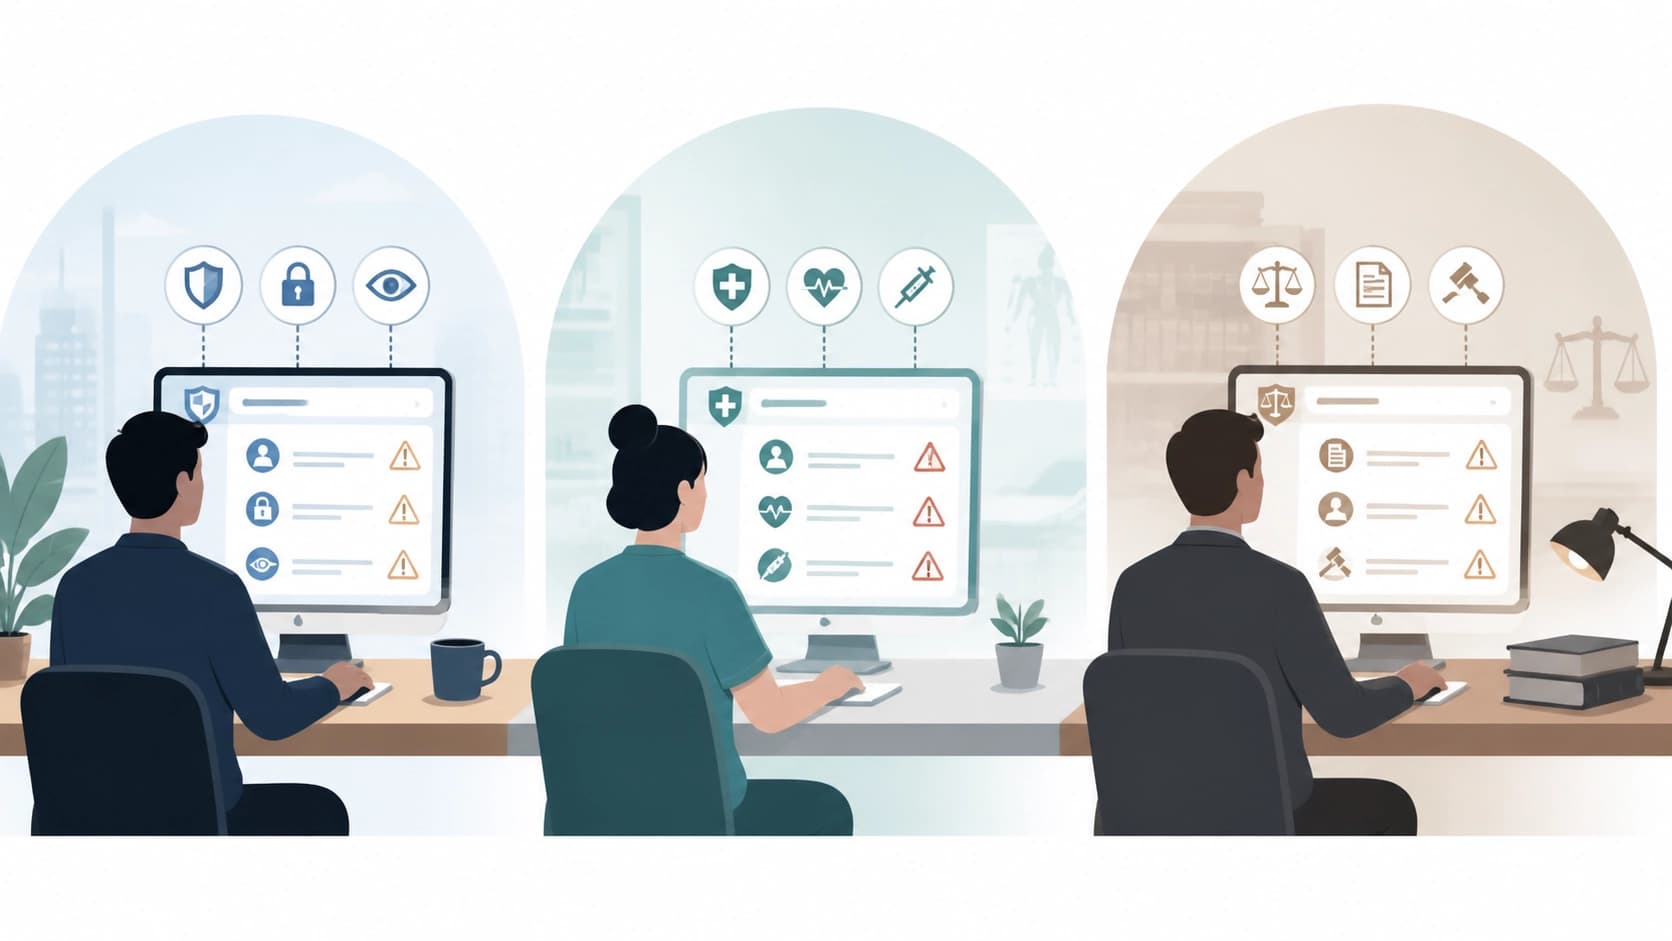
L'IA générative arrive dans des organisations très différentes, et chacune a ses propres risques. Une banque craint la fuite de données clients et les conseils financiers erronés, une clinique redoute des recommandations médicales inexactes, une école s'inquiète de contenus indésirables dans un dialogue avec un adolescent. Ajoutez à cela les exigences réglementaires du secteur, les valeurs internes de l'entreprise et l'identité de la personne qui se trouve de l'autre côté du chat : un salarié, un sous-traitant ou un utilisateur externe.
Il en découle une conclusion inconfortable : un modèle de sécurité unique pour l'IA générative ne fonctionne pas. Les paramètres doivent être adaptés à chaque scénario précis, et non recopiés d'un manuel.
Le deuxième problème est d'ordre instrumental. Les mécanismes habituels de spécification des politiques se sont développés autour de la gestion des accès : ils répondent à la question « qui a accès à quelles ressources ». Mais dans les applications dotées de modèles génératifs, une autre question est bien plus importante — ce qui peut effectivement se retrouver dans une réponse. Les restrictions liées au contenu se décrivent mal en termes de rôles et de droits, et c'est à cette jonction que commence généralement le travail manuel, impossible à mettre à l'échelle.
Ce que propose Granite.Trust
La boîte à outils est décrite dans une prépublication arXiv:2608.23870, dans la section cs.AI. Le document a été soumis le 24 août 2026, et parmi les auteurs figurent Nathalie Baracaldo, Nicolas Mello, Kush R. Varshney, Heiko Ludwig, Kate Soule et David Cox, soit six personnes au total. Le volume des sources est d'environ 2,7 Mo, ce qui, pour un article accompagné d'outils, témoigne d'une base de code bien tangible, et pas seulement d'un concept.
Les auteurs avancent deux points principaux.
Actionable Policy : la politique comme document modifiable
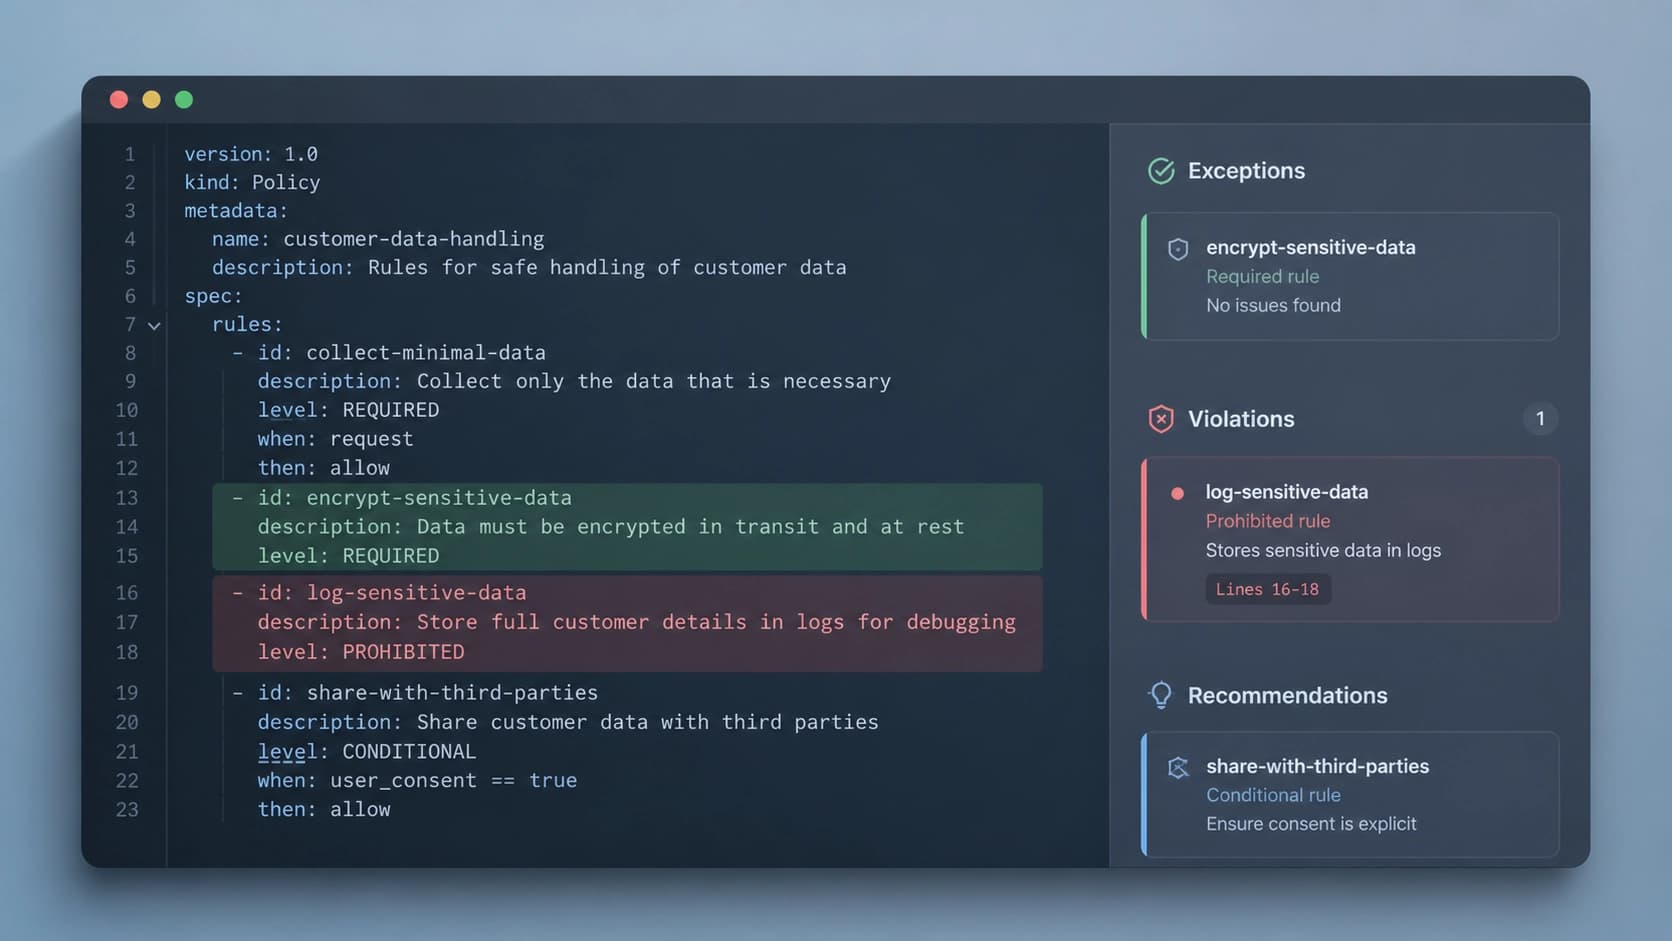
Le premier est le schéma Actionable Policy, un format fondé sur YAML. Il ne s'agit pas d'un « guide de sécurité » abstrait, mais d'une description lisible par machine de ce qui est acceptable ou non dans les réponses du modèle. Le détail clé réside dans la gestion par exceptions : les règles comportent des réserves explicites, et ce sont elles qui permettent de repérer les cas de violation de la politique. Autrement dit, l'équipe dispose non seulement d'une liste d'interdictions, mais aussi d'un mécanisme pour comprendre où exactement le modèle a dépassé les limites, et pourquoi.
Des données synthétiques pour vérifier la politique
Le second est un pipeline de génération de données synthétiques. Il crée des exemples d'entraînement cohérents avec la politique déjà décrite, et ceux-ci servent à deux fins : l'alignement du modèle et son test. S'y ajoute un ensemble d'utilitaires qui aident à concevoir le schéma lui-même, puis à contrôler le respect des règles.
La logique est saine : si la politique existe séparément des données sur lesquelles le modèle est entraîné, elle reste une déclaration d'intention. En revanche, lorsque des exemples « ceci est permis » et « ceci ne l'est pas » découlent automatiquement de la politique, les exigences deviennent quelque chose de vérifiable.
Définie une fois, appliquée sur tout le cycle
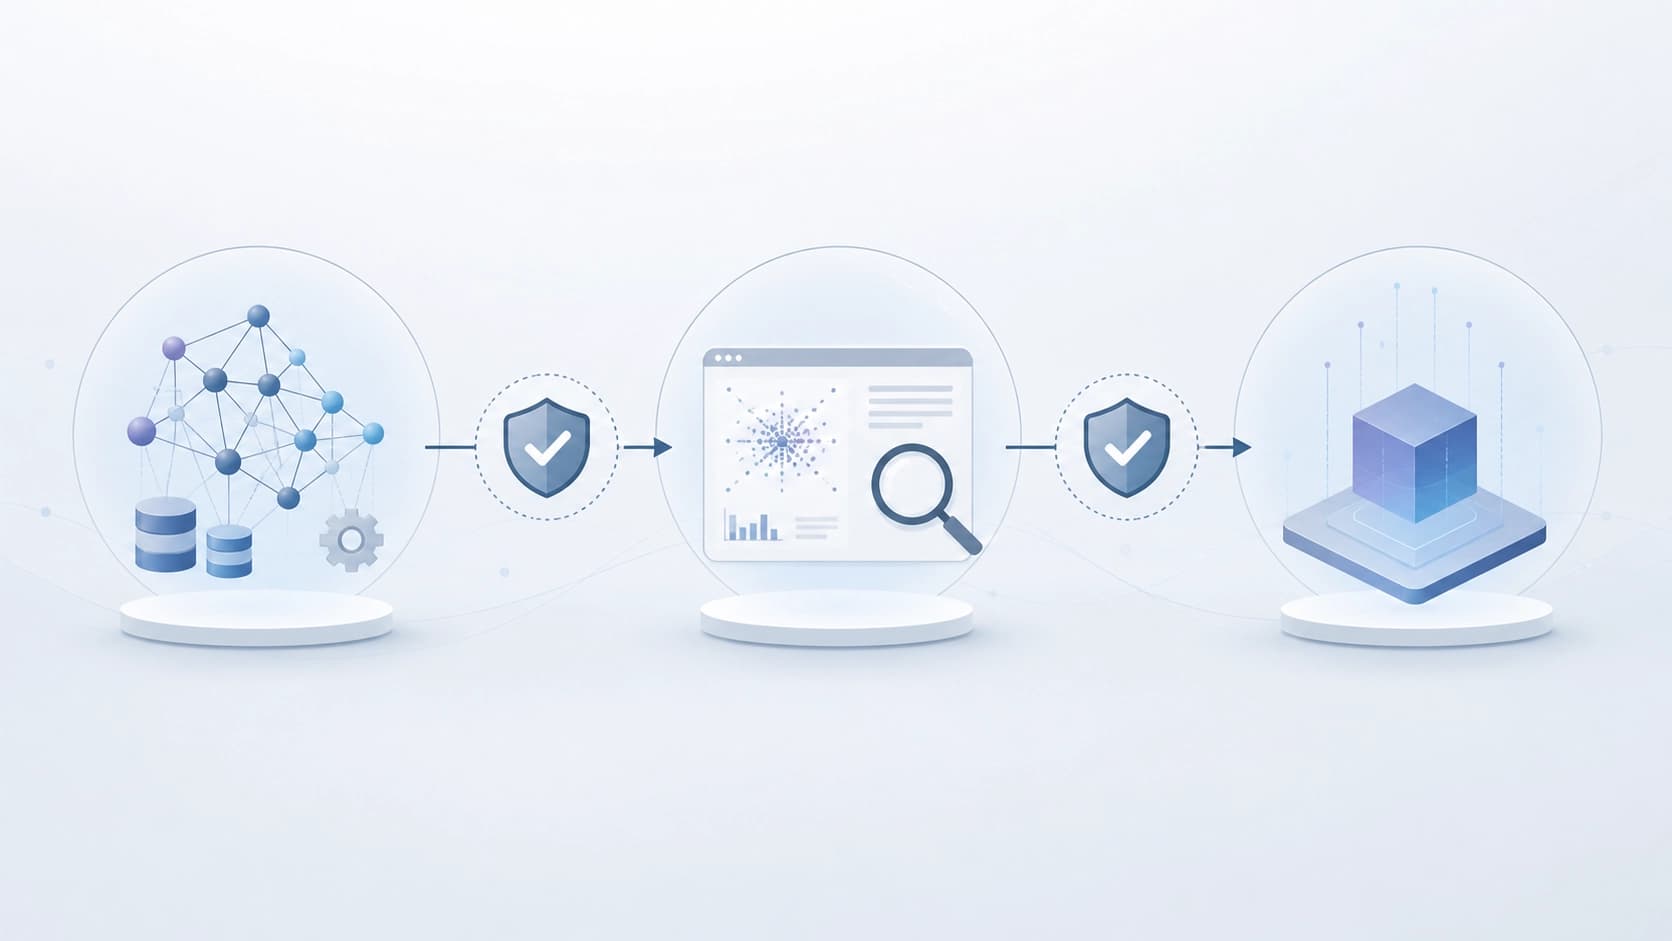
La principale valeur pratique de cet ensemble réside dans le fait que la politique cesse d'être un document à usage unique. L'organisation la formule une fois, puis la fait traverser tout le cycle de vie de l'application : de l'étape d'alignement du modèle jusqu'à la surveillance d'un produit déjà en service.
Cela change sensiblement la routine quotidienne des équipes. D'ordinaire, les exigences de sécurité vivent à un endroit, les tests à un autre, et les logs de production à un troisième, et il faut les synchroniser manuellement. Ici, en revanche, on suppose une source unique de règles, dont dépendent à la fois l'entraînement, les vérifications avant mise en production et l'observation du trafic réel.
Il convient de préciser une chose : la boîte à outils ne décide pas à la place de l'organisation quels risques sont critiques pour elle. Elle fournit un langage pour décrire la politique et une infrastructure pour l'appliquer — mais le contenu même des règles reste du ressort des personnes qui connaissent leur produit, leur secteur et leur audience.
Code ouvert et pistes à explorer
Le schéma, les exemples de politiques et les outils eux-mêmes sont mis à disposition en accès libre. Les auteurs invitent explicitement à envoyer des idées, des améliorations et des retours — un pari typique pour ce genre de projets, misant sur le fait que la communauté trouvera plus vite des scénarios que le groupe de recherche n'a pas explorés.
Le texte intégral est disponible en plusieurs formats : PDF, version HTML expérimentale et sources en TeX. L'article possède un DOI — 10.48550/arXiv.2608.23870 —, ce qui permet de le citer dans des documents d'entreprise sans réserve liée à une prépublication dépourvue d'identifiant.
Si vous êtes justement en train d'essayer de faire passer vos exigences internes en matière d'IA générative du format « présentation pour le conseil d'administration » à un format qui fait réellement quelque chose dans le pipeline, c'est exactement le type de solution qu'il vaut la peine d'examiner de près. Commencez par les exemples de politiques : ils montrent assez bien à quel point les auteurs se représentent les contraintes réelles, et pas seulement la formulation académique du problème.


