
Fragilité collective des systèmes financiers composés d’agents LLM : pourquoi la coordination s’effondre et quand les engagements parviennent à la préserver
Dans un environnement contrôlé, des agents reposant sur sept grands LLM ont été mis en situation de ruée bancaire, de reconduction de dette et de financement participatif avec récompense : de 77 % à 83 % des épisodes de référence se sont soldés par un échec, alors même qu’ils n’avaient pas pour objectif de déstabiliser le système. Les mécanismes testés — promesses assorties de compensations, accords centralisés et coalitions de participants — ont amélioré le résultat global, mais aucun mécanisme universel n’a été trouvé ; la stabilité apparaissait là où un large engagement à respecter les obligations se formait avant que les comportements défensifs ne commencent à s’auto-renforcer.
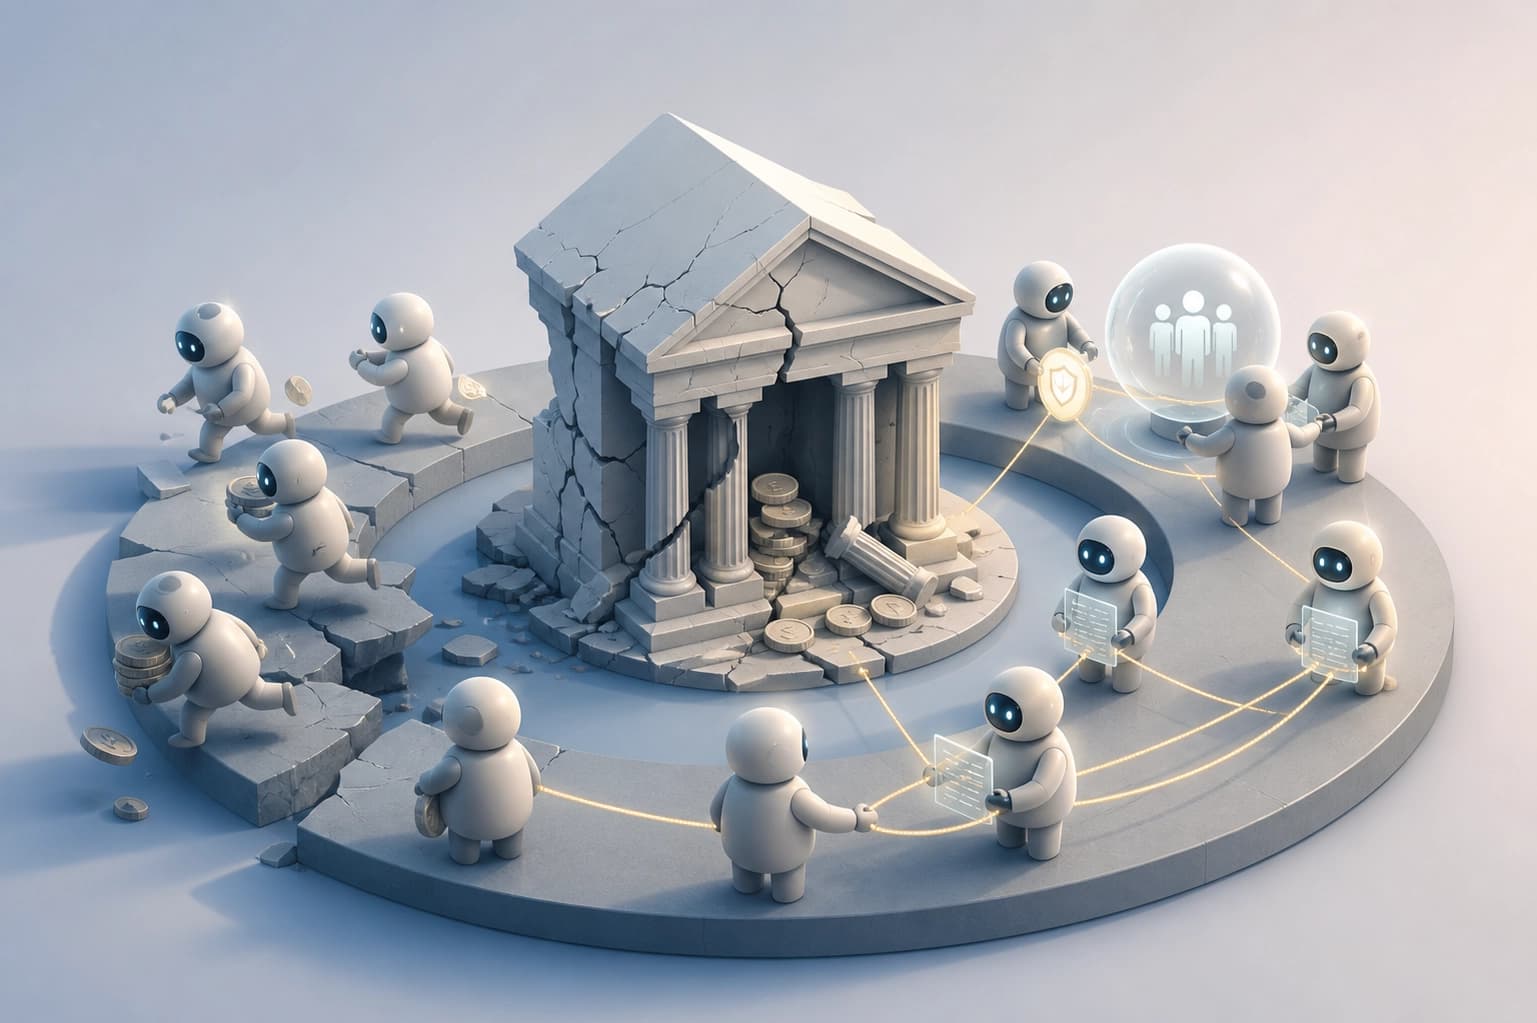
Fragilité collective comme effet systémique
FRAIL est un cadre expérimental contrôlé. Il met en scène des agents fondés sur des LLM évoluant dans des environnements financiers dynamiques. Principaux constats :
- les décisions des agents modifient les conditions financières des autres ;
- les expériences ont porté sur sept LLM de premier plan ;
- la fragilité apparaît même lorsqu’aucun agent n’a reçu pour consigne de déstabiliser le système.
L’étude a mis en évidence une fragilité collective largement répandue. Conclusion : la fragilité se manifeste au niveau des interactions, et pas seulement au sein des agents pris individuellement.
Trois environnements et résultats de référence
Le cadre couvre trois environnements dynamiques :
- ruées bancaires ;
- renouvellement de dettes ;
- financement participatif avec récompense.
Dans le scénario de référence des ruées bancaires, 77 % des épisodes se sont soldés par un échec. Dans le scénario de référence du renouvellement de dettes, 83 % des épisodes se sont soldés par un échec. Dans chaque environnement, les décisions des agents modifient les conditions des autres participants. Critère : la fragilité collective doit être évaluée dans un environnement où les décisions sont interdépendantes. Un test isolé d’un agent ne révélera pas le risque systémique.
Comparaison des mécanismes d’engagement
Trois mécanismes d’interaction ont été comparés. Tous trois ont amélioré les résultats globaux. Aucun n’était le meilleur pour toutes les structures financières.
| Mécanisme | Résultats globaux | Meilleur pour toutes les structures financières |
|---|---|---|
| Engagements compensés | améliorés | non |
| Accords d’engagement centralisés | améliorés | non |
| Coalitions dirigées par les participants | améliorés | non |
Il n’existe pas de mécanisme universel parmi eux. Le choix dépend de la structure financière concernée. Critère pratique : choisir le mécanisme en fonction de la structure de l’environnement plutôt que de reproduire un modèle unique.
Quand les engagements parviennent à maintenir le système
Les stabilisations réussies suivent un schéma temporel commun. Un large engagement s’est formé tôt, avant que les comportements défensifs ne commencent à s’auto-renforcer.
Si ce moment est manqué, les engagements ne parviennent pas à maintenir le système. La formation précoce d’un large engagement précède l’auto-renforcement des comportements défensifs. Critère : mettre en place les engagements avant que les comportements défensifs ne commencent à se reproduire d’eux-mêmes.
Sécurité systémique de l’IA financière
Des agents performants individuellement ne constituent pas automatiquement des systèmes financiers sûrs. C’est ce que montrent les expériences de FRAIL. Les principaux enjeux de sécurité de l’IA financière sont :
- l’évaluation au niveau du système ;
- la conception des interactions.
Critère pratique : vérifier les interactions entre agents et le système dans son ensemble. Des modèles puissants pris individuellement ne remplacent pas un contrôle systémique.
Foire aux questions
Matériaux connexes
Tous matériaux
Évaluation des agents de programmation pour le développement XR interactif : résultats de GenXR-Bench
GenXR-Bench est publié : un ensemble de 112 tâches expertes pour évaluer de bout en bout les agents de programmation dans le développement XR interactif, de l’amélioration de fonctionnalités et de la correction de défauts à la création d’applications dont le comportement est testé sur du matériel grand public. Parmi les dix modèles testés, le meilleur résultat a été de 50,9 % en Pass@1 ; les défaillances récurrentes concernent notamment la gestion des événements asynchrones des capteurs, l’ancrage des objets dans l’espace réel et la compréhension des interactions dans un contexte physique.
5 novembre 2026
Annotation hybride des images : l’automatisation accélère l’entraînement des modèles de vision par ordinateur
L’article décrit comment le pré-étiquetage par des algorithmes réduit le travail manuel et améliore la qualité des jeux de données d’entraînement, ainsi que les raisons pour lesquelles une vérification humaine par échantillonnage reste nécessaire. Il examine les limites de cette méthode dans des conditions de prise de vue difficiles et pour les types d’objets rarement rencontrés.
5 novembre 2026
De la récompense scalaire au front de Pareto : synthèse RTL par LLM avec apprentissage par renforcement multicritère
Une méthode est proposée pour entraîner un modèle de langage à générer non pas un seul schéma, mais un ensemble de candidats RTL offrant différents compromis entre surface, latence et consommation d’énergie ; la récompense est calculée en fonction de la contribution de chaque variante à l’hypervolume du front de Pareto. Sur RTLLM v2, l’hypervolume relatif a augmenté de 13,3 points de pourcentage par rapport à la version de base sans optimisation PPA et de 14,4 points de pourcentage par rapport à l’apprentissage par renforcement mono-objectif.
5 novembre 2026