
ভিড়ের প্রজ্ঞা একরূপতার কাছে হেরে যায়
যখন ভবিষ্যৎ নিয়ে কিছু পূর্বাভাস দিতে হয় — বাজারের আচরণ, কোনো ঘটনার পরিণতি, কোনো প্রযুক্তির ভাগ্য — তখন সহজ একটা ভাবনা মাথায় আসে: যত বেশি মডেলকে জিজ্ঞাসা করা হবে, উত্তর তত নির্ভরযোগ্য হবে। যুক্তিটা আপাতদৃষ্টিতে লোহার মতো মজবুত: ভিন্ন ভিন্ন সিস্টেম ভিন্ন ভিন্নভাবে ভুল করে, তাই গড় করলে এলোমেলো ভুলগুলো মসৃণ হয়ে যাবে।
কিন্তু এই পরিকল্পনায় একটা ফাঁদ আছে। যদি "ভিড়ের" সব সদস্য একই ধরনেরভাবে চিন্তা করে, তবে তাদের ভোটগুলো স্বাধীন সাক্ষ্য নয় — বরং একই মতামত, কপি করে বহুগুণ বাড়ানো। প্রায় একই রকম দশটি উত্তর একটি উত্তরের তুলনায় কোনো বাড়তি তথ্য দেয় না; তারা কেবল আত্মবিশ্বাসের অনুভূতি তৈরি করে এবং ইনফারেন্সের বিল বাড়ায়।
ঠিক এই সমস্যাকে কেন্দ্র করেই রচিত হয়েছে "Diverse by Reasoning: Harnessing the Wisdom of LLM Crowds for Future Prediction" — এটি প্রস্তুত করেছেন নিরুপম চেটলাপাল্লি, ইমিং লিয়াও, মিন-চুন চেন এবং কেকে চেন। প্রিপ্রিন্ট arXiv:2608.24001 প্রকাশিত হয় ২৫ আগস্ট ২০২৬-এ, পরদিনই বেরিয়ে আসে সংশোধিত সংস্করণ, আর নিবন্ধটি জমা দেওয়া হয়েছে IEEE BigData 2026-এ।
শুধু "আরও বেশি মডেল" সমস্যার সমাধান নয়
লেখকদের মূল পর্যবেক্ষণ: ভিন্ন ভিন্ন বড় ভাষা মডেল আচরণে অপ্রয়োজনীয়ভাবে একই রকম হতে পারে। তারা তুলনীয় ডেটায় প্রশিক্ষিত, একই ধরনের ভাষাভঙ্গি ও প্রচলিত যুক্তির ধারায় ঝোঁক রাখে। ফলে অংশগ্রহণকারীদের তালিকা যান্ত্রিকভাবে বাড়ালে সেই বৈচিত্র্য পাওয়া যায় না, যার জন্য পুরো আয়োজন।
এখানে দুটি ধারণা আলাদা করা জরুরি। সংখ্যা মানে আমরা কতগুলো মডেলকে জিজ্ঞাসা করছি। বৈচিত্র্য মানে তারা কতটা ভিন্নভাবে সিদ্ধান্তে পৌঁছায়। দ্বিতীয়টি প্রথমটি থেকে স্বয়ংক্রিয়ভাবে আসে না: কুড়িটি অংশগ্রহণকারী জড়ো করেও একই ভাবনার কুড়িটি রূপান্তর পাওয়া যেতে পারে।
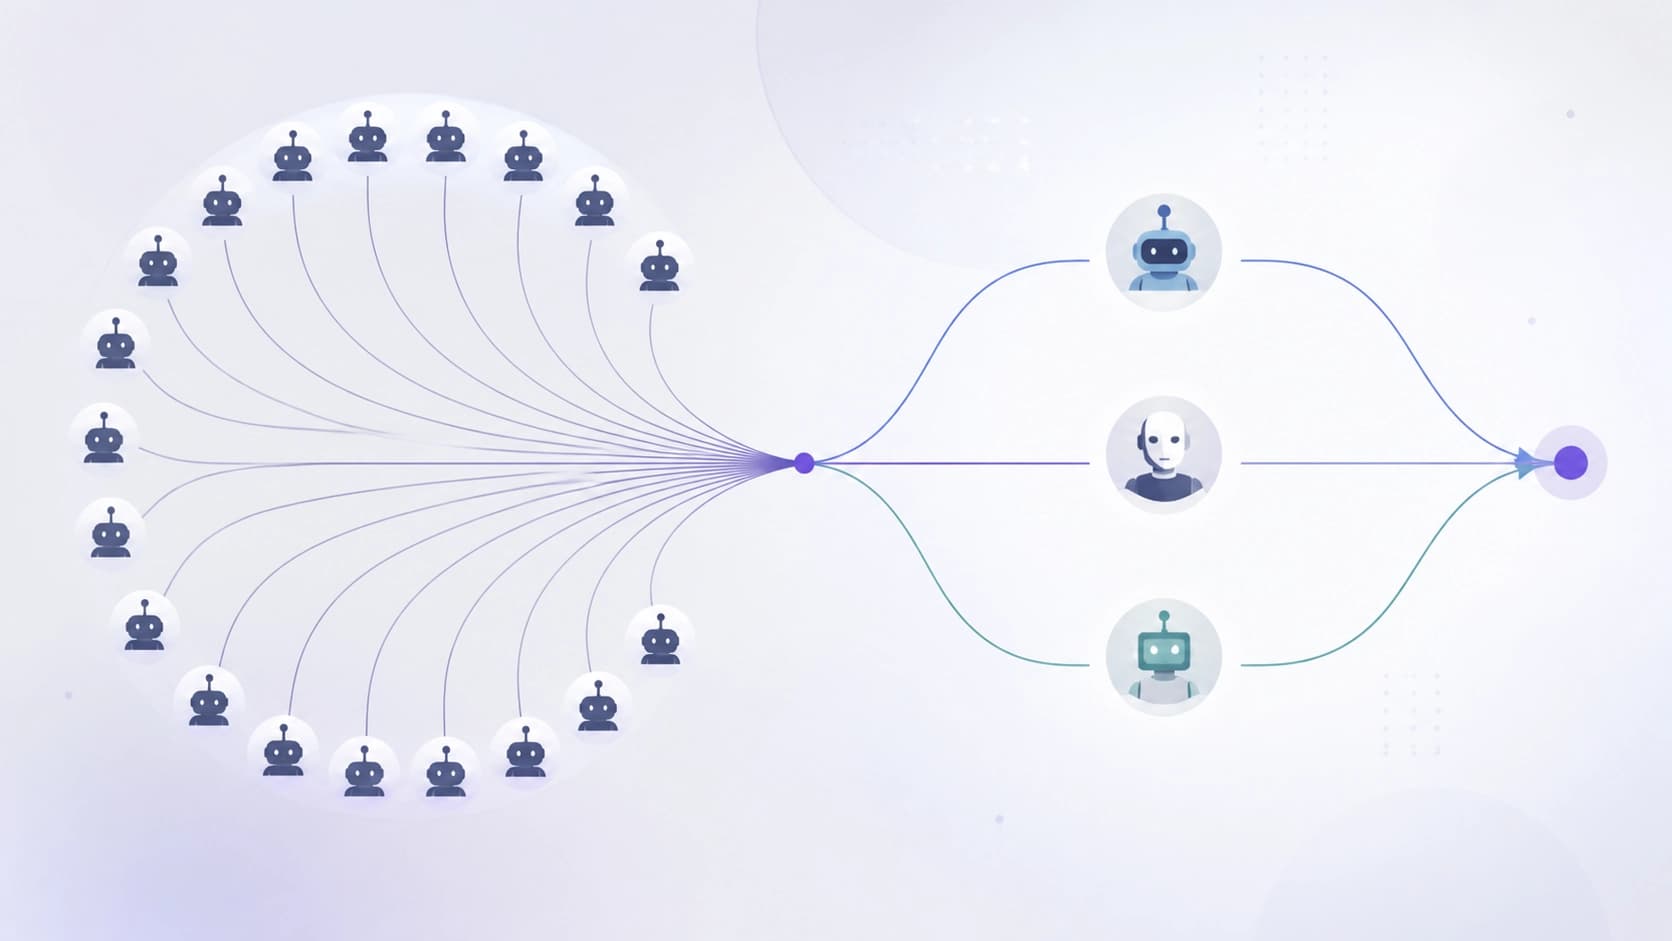
পদ্ধতি: মডেল নির্বাচন করা হয় উত্তরের নয়, যুক্তির ধরন অনুযায়ী
আচরণভিত্তিক নির্বাচন দেখতে কেমন
লেখকরা একটি ফ্রেমওয়ার্ক প্রস্তাব করেন, যাকে তারা আচরণ-কেন্দ্রিক বলে অভিহিত করেন। মূল কথা চূড়ান্ত উত্তরের সঠিকতা দিয়ে মডেল তুলনা করা নয়, বরং তারা কীভাবে চিন্তা করে তা বোঝা।
পরিকল্পনাটি এমন:
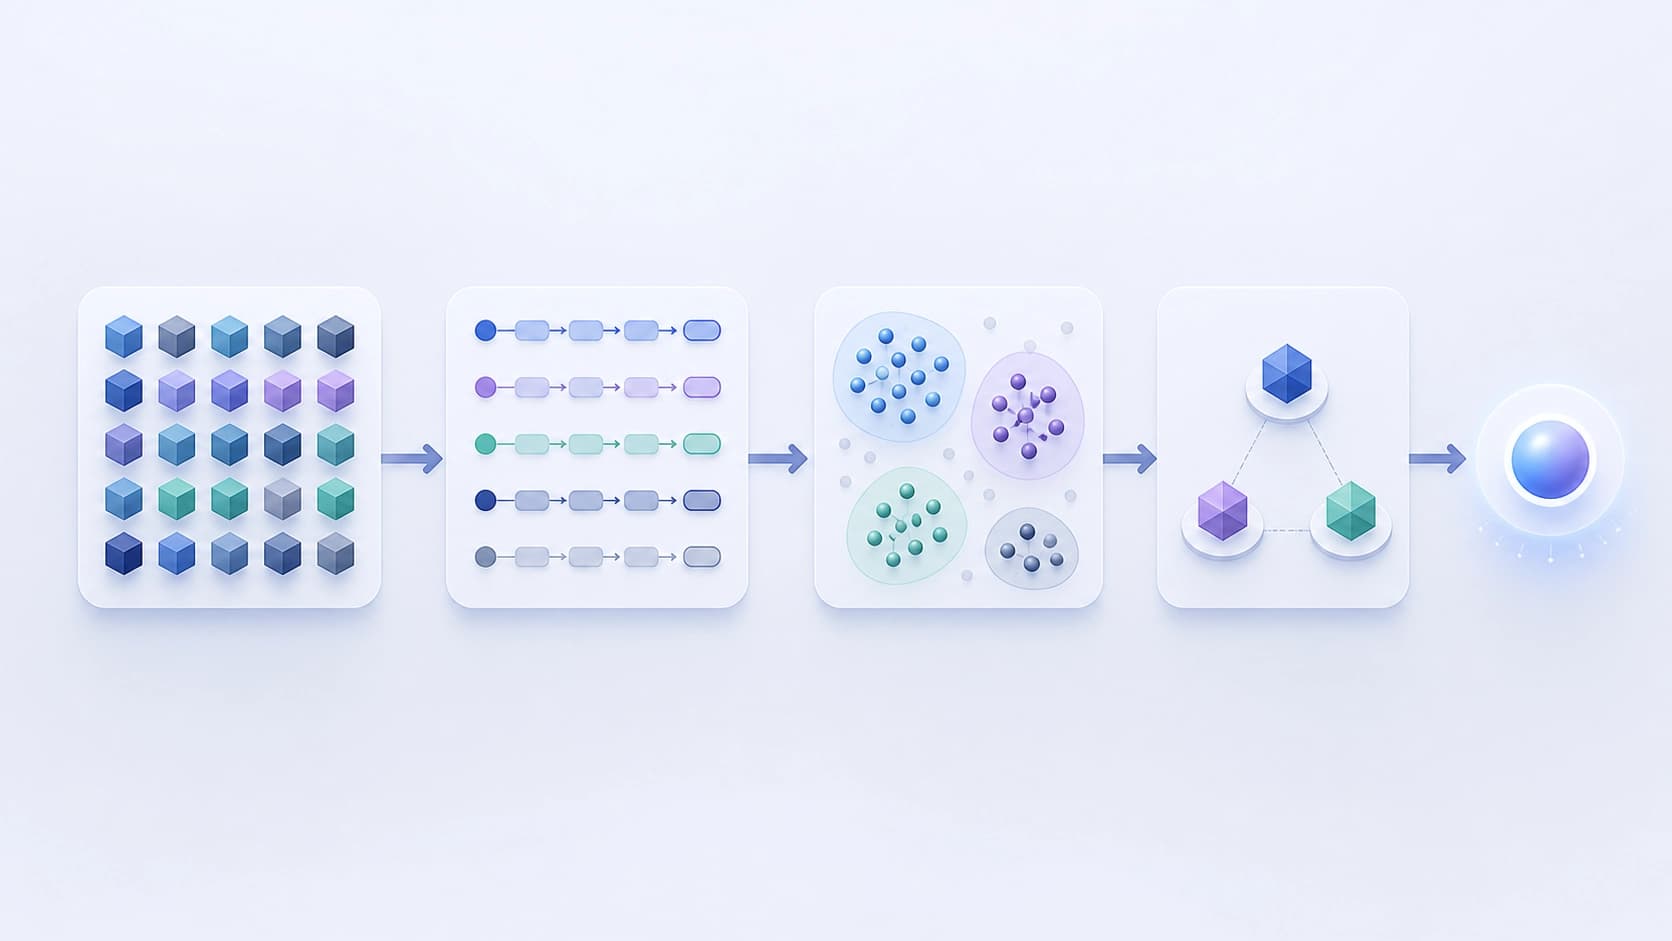
- প্রতিটি মডেলকে ভবিষ্যৎ পূর্বাভাসের সঙ্গে সম্পর্কহীন স্বাধীন কিছু কাজের উপর চালানো হয়। উত্তর যতটা নয়, সংগৃহীত হয় মূলত যুক্তির শৃঙ্খল — সেই reasoning traces-গুলো।
- এই চিহ্নগুলোর ভিত্তিতে একটি আচরণগত প্রোফাইল তৈরি হয়: মডেল কী কী ধাপ নেয়, সমস্যাকে কীভাবে ভাগ করে, কোথায় ভুল করে, কোন যুক্তি ব্যবহার করে।
- আচরণের সাদৃশ্য অনুযায়ী মডেলগুলোকে ক্লাস্টারে ভাগ করা হয়। এর জন্য K-means++ অ্যালগরিদম ব্যবহার করা হয়।
- প্রতিটি ক্লাস্টার থেকে একজন প্রতিনিধি নেওয়া হয় — একটি মেডয়েড, অর্থাৎ যে মডেলটি তার দলের জন্য সবচেয়ে সাধারণ।
- এই সংক্ষিপ্ত মেডয়েড-"ভিড়"ই সমষ্টিগত পূর্বাভাস দেয়।
ভালো করে ভাবলে ধারণাটি নতুন নয় — পরিসংখ্যানে এভাবেই করা হয়, যখন পারস্পরিক সম্পর্কযুক্ত বৈশিষ্ট্যের মধ্যে থেকে একটি করে প্রতিনিধি রাখা হয়, যাতে একই তথ্য পুনরাবৃত্তি না হয়। এখানে নতুনত্ব হলো, "বৈশিষ্ট্য" হয়ে ওঠে ভাষা মডেলের চিন্তার ধরন, কোনো সংখ্যাগত বৈশিষ্ট্য নয়।
কী দিয়ে পরীক্ষা করা হয়েছে
পরীক্ষাটি ২৫টি মডেলের উপর গড়া। সাতটি ডেভেলপমেন্ট বেঞ্চমার্ক ব্যবহার করা হয়েছে মডেলগুলোর আচরণ বর্ণনা ও আলাদা করতে, আর ভবিষ্যৎ পূর্বাভাসের জন্য দুটি আলাদা বেঞ্চমার্ক — তৈরি হওয়া "ভিড়"গুলোর গুণমান মূল্যায়ন করতে। এই বিভাজন মৌলিক: যে কাজগুলো দিয়ে প্রোফাইল তৈরি হয়, সেগুলো সেই কাজগুলোর সঙ্গে মেলে না, যেগুলো দিয়ে ফলাফল গণনা করা হয়। নইলে এটা হয়ে যেত উঁকি দিয়ে শেখা, আর সংখ্যাগুলোর প্রায় কোনো অর্থই থাকত না।
ফলাফল: তিনটি মডেল পঁচিশটিকে ছাড়িয়ে যায়
কাজটির সবচেয়ে চমকপ্রদ দিক হলো তুলনার ফলাফল। আচরণগত ক্লাস্টারিংয়ের মাধ্যমে গড়া মাত্র তিনটি মেডয়েড-মডেলের "ভিড়" একসঙ্গে ২৫টি মডেলের উপর সাধারণ ভোটদানের চেয়ে ভালো ফল দেখিয়েছে। আর এটি দুটি পূর্বাভাস বেঞ্চমার্কের ক্ষেত্রেই সত্য।
একই সঙ্গে সাশ্রয় হয়েছে চোখে পড়ার মতো: মডেলে অনুরোধের সংখ্যা কমেছে ৮৮%, আর ইনফারেন্স খরচ প্রায় ৮০%। বাস্তব প্রয়োগে এটি নির্ভুলতার বৃদ্ধির চেয়েও প্রায় বেশি গুরুত্বপূর্ণ। পূর্বাভাস ব্যবস্থা প্রায়ই আটকে যায় উত্তরের গুণমানে নয়, তার দামে: প্রতিটি প্রশ্নের জন্য যদি কুড়িটি মডেলকে জিজ্ঞাসা করতে হয়, তবে সমাধান নির্ভুল হওয়ার অনেক আগেই অলাভজনক হয়ে পড়ে।
এখান থেকে একটি অপ্রত্যাশিত সিদ্ধান্ত বেরিয়ে আসে: "ভিড়ের" গঠন তার আকারের চেয়ে বেশি ভারী। ২৫টি মডেল তিনটির তুলনায় স্বয়ংক্রিয় সুবিধা নয়, যদি সেই ২৫টি আসলে একে অপরের পুনরাবৃত্তি করে।
সব বৈচিত্র্যই সমান উপকারী নয়
লেখকরা আরেকটি সূক্ষ্ম সিদ্ধান্তে আসেন, যা সহজেই এড়িয়ে যাওয়া যায়। দেখা যায়, বৈচিত্র্যকে যতটা সম্ভব বাড়ানো নয়, বরং প্রতিনিধিত্বমূলকতা গুরুত্বপূর্ণ — অর্থাৎ নির্বাচিত অংশগ্রহণকারীরা মডেলগুলোর মধ্যে থাকা ভিন্ন ভিন্ন আচরণের মেরুগুলো কতটা প্রতিফলিত করে।
পার্থক্যটি মৌলিক। তিনটি মডেল বেছে নেওয়া যায়, যারা এলোমেলোভাবে ও তুচ্ছ বিষয়ে একে অপরের থেকে আলাদা — এবং সংকেতের বদলে শব্দ পাওয়া যায়। আবার সত্যিই ভিন্ন আচরণগত গোষ্ঠী থেকে একটি করে বেছে নেওয়া যায় — এবং সমাধানের পরিসর ঢেকে দেওয়া একটি সংক্ষিপ্ত সেট পাওয়া যায়। প্রথমটি বৈচিত্র্যহীনতা, দ্বিতীয়টি বৈচিত্র্যময়তা। কাজ করে দ্বিতীয়টি।
এখানে সাধারণ বিশেষজ্ঞতার সঙ্গে সমান্তরাল টানা যায়। ভালো কমিটি সেটি নয়, যেখানে বেশি মানুষ থাকে, বরং সেটি, যেখানে ভিন্ন ভিন্ন দৃষ্টিভঙ্গি ও পদ্ধতি উপস্থিত থাকে। ভিন্ন ভিন্ন ক্ষেত্রের পাঁচজন বিশেষজ্ঞ সাধারণত একই বিভাগের পনেরোজন স্নাতকের চেয়ে বেশি কাজে আসেন।
বাস্তবে এর অর্থ কী
যারা ভাষা মডেলের উপর পূর্বাভাস সেবা তৈরি করেন, তাদের জন্য নিবন্ধের সিদ্ধান্তগুলো বেশ নির্দিষ্ট একটি রেসিপি দেয়:
- মডেলের তালিকা লম্বা করার পেছনে ছোটা নয়। আচরণ বিশ্লেষণ ছাড়া পুল বাড়ানো মানে পুনরাবৃত্ত উত্তরগুলোর জন্য টাকা খরচ করা।
- আগে আচরণ মাপুন, তারপর গঠন বাছুন। অসম্পর্কিত কাজের উপর চালানো ও ক্লাস্টারিং স্পষ্ট ছবি দেয় কে সত্যিই আলাদা।
- সচেতনভাবে সাশ্রয় করুন। নির্ভুলতা ধরে রেখে বা বাড়িয়ে অনুরোধের সংখ্যা এক ক্রম কমিয়ে আনা পণ্যের অর্থনীতিই বদলে দেয়, শুধু কারিগরি বৈশিষ্ট্য নয়।
- সীমাবদ্ধতার কথা মনে রাখুন। এসব পরীক্ষা করা হয়েছে ২৫টি মডেলের নির্দিষ্ট একটি সেট ও দুটি পূর্বাভাস বেঞ্চমার্কে; সংখ্যাগুলো হুবহু অন্য ডোমেইন বা অন্য মডেলে প্রয়োগ করা উচিত নয়।
কাজটির মূল ভাবনা প্রায় মানুষের মতোই শোনায়: সমষ্টিগত মতামতের মূল্য ভোটের সংখ্যার উপর নির্ভর করে না, বরং এই উপর যে ভোটগুলো সত্যিই ভিন্ন। ভাষা মডেলের ক্ষেত্রে এর অর্থ হলো, মাপতে হবে নামের তালিকা নয়, চিন্তার ধরন — আর সেই অনুযায়ীই দল গড়তে হবে।


